

Probabil că astăzi nu mai există nicio întrebare despre importanța colectării metricalor serviciilor. Pasul următor logic este să configurăm alerte pentru metricalele colectate, care să te informeze despre orice deviație în date prin canalele care îți sunt convenabile (email, Slack, Telegram). În serviciul de rezervare online a hotelurilor toate metricale serviciilor noastre sunt trimise în InfluxDB și afișate în Grafana, unde este configurat un sistem de alerte de bază. Pentru sarcini de tipul "trebuie să contabilizăm ceva și să comparăm cu asta" folosim Kapacitor.
Kapacitor este parte a stivei TICK, care știe să proceseze metricale din InfluxDB. Acesta poate conecta mai multe măsurători între ele (join), să calculeze ceva util din datele obținute, să scrie rezultatul înapoi în InfluxDB și să trimită un alert în Slack/Telgram/email.
Întreaga stivă are documentație detaliată și interesantă , dar întotdeauna apar și lucruri utile care nu sunt specificate în mod explicit în manuale. În acest articol, am decis să adun o serie de sfaturi utile, dar mai puțin evidente (sintaxa principală a TICKscript este descrisă ) și să arăt cum pot fi aplicate, prin exemplul unei dintre sarcinile noastre.
Configurarea Mitogen pentru Ansible este foarte simplă:
float & int, erori de calcul
O problemă absolut standard, care se rezolvă prin casting:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Utilizarea default()
Dacă eticheta/câmpul nu este completat, vor apărea erori în calcule:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill în join (inner vs outer)
În mod implicit, join va ignora punctele unde nu există date (inner).
Cu fill(‘null’) se va efectua un outer join, după care trebuie să facem default() și să completăm valorile lipsă:
var data = res1
    |join(res2)
        .as('res1', 'res2)
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Aici totuși există un nuanță. Dacă în exemplul de mai sus una dintre serii (res1 sau res2) este goală, seria finală (data) va fi de asemenea goală. Pe această temă există câteva ticket-uri pe GitHub (, , ) – așteptăm soluții și suferim puțin.
Utilizarea condițiilor în calcule (if în lambda)
|eval(lambda: if("value" > 0, true, false)
Ultimele cinci minute din pipeline pentru o perioadă
De exemplu, trebuie să compari valorile din ultimele cinci minute cu cele din săptămâna precedentă. Poți lua două seturi de date prin doua batch-uri separate sau poți extrage o parte din date dintr-o perioadă mai mare:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
O alternativă pentru ultimele cinci minute poate fi utilizarea nodului BarrierNode, care taie datele mai devreme decât timpul specificat:
|barrier()
        .period(5m)
Exemple de utilizare a șabloanelor Go în message
Șabloanele se conformează formatului din pachetul , mai jos câteva sarcini frecvente.
if-else
Facem ordine, fără a declanșa oamenii cu text inutil:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Este în regulă acum{{ else }}Șefule, totul este distrus{{end}}'
    )
Două zecimale după virgulă în message
Îmbunătățim lizibilitatea mesajului:
|alert()
    ...
    .message(
        'valoarea acum este {{ index .Fields "value" | printf "%0.2f" }}'
    )
Dezvoltarea variabilelor în message
Furnizăm mai multe informații în mesaj pentru a răspunde la întrebarea „De ce strigă?”
var warnAlert = 10
  |alert()
    ...
    .message(
       'Valoarea de astăzi este mai mică de '+string(warnAlert)+'%'
    )
Identificator unic al alertelor
Este util când există mai mult de un grup în date, altfel se va genera doar o alertă:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Handleri personalizați
Într-o listă mare de handleri există exec, care permite executarea propriului script cu parametrii transmiși (stdin) – doar creație!
Unul dintre personalizările noastre este un mic script python pentru trimiterea notificărilor în Slack.
La început, ne-am dorit să trimitem în mesaj o imagine din Grafana, protejată prin autentificare. Apoi – să scriem OK în firul alertelor anterioare din același grup, nu ca un mesaj separat. Puțin mai târziu – să adăugăm în mesaj cea mai frecventă eroare din ultimele X minute.
O temă separată – legătura cu alte servicii și acțiuni inițiate de alertă (doar dacă monitorizarea dvs. funcționează suficient de bine).
Exemplu de descriere a handlerului, unde slack_handler.py este scriptul nostru personalizat:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Cum se face debugging?
O variantă cu ieșire în log
|log()
      .level("error")
      .prefix("something")
Vizualizăm (cli): kapacitor -url :9092 logs lvl=error
O variantă cu httpOut
Afișează datele în pipeline-ul actual:
|httpOut('something')
Vizualizăm (get): :9092\/kapacitor\/v1\/tasks\/task_name\/something
Schema executării
- Fiecare sarcină returnează un arbore de execuție cu cifre utile în formatul .
- Luăm blocul .
- Îl inserăm în viewer, .
Unde mai putem obține timestamp în influxdb la scrierea inversă
timestamp în influxdb la scrierea inversă
De exemplu, configurăm un alert pentru suma cererilor pe oră (groupBy(1h)) și dorim să înregistrăm alertarea care a avut loc în influxdb (pentru a arăta frumos faptul că a existat o problemă pe grafic în grafana).
influxDBOut() va înregistra în timestamp valoarea time din alertă, prin urmare, punctul de pe grafic va fi înregistrat mai devreme/mai târziu decât a venit alerta.
Când este necesară precizia: depășim această problemă prin apelarea unui handler personalizat, care va scrie datele în influxdb cu timestamp-ul curent.
docker, construire și implementare
La pornirea kapacitor, acesta poate încărca sarcini, șabloane și handleri din directorul specificat în configurare, în blocul [load].
Pentru a crea corect o sarcină, sunt necesare următoarele lucruri:
- Numele fișierului – se dezvoltă în id/numele scriptului
- Tip – stream/batch
- dbrp – cuvânt cheie pentru a specifica în ce bază + politică funcționează scriptul (dbrp „supplier”.„autogen”)
Dacă într-o sarcină batch nu există o linie cu dbrp, întregul serviciu va refuza să pornească și va scrie cinstit despre aceasta în log.
În chronograf, dimpotrivă, această linie nu ar trebui să fie prezentă, prin interfață nu este acceptată și dă o eroare.
Hack la construirea containerului: Dockerfile-ul iese cu -1 dacă există linii cu /.+dbrp, ceea ce va permite să înțelegi imediat cauza eșecului la construirea build-ului.
join unul la mulți
Sarcină exemplu: trebuie să luăm percentila 95 a timpului de funcționare a serviciului pe parcursul unei săptămâni, comparând fiecare minut din ultimele 10 cu această valoare.
Nu se poate realiza un join unul la mulți, last/mean/median pe un grup de puncte transformă nodul în stream, va returna eroarea „cannot add child mismatched edges: batch -> stream”.
Rezultatul batch-ului, ca variabilă în expresia lambda, de asemenea, nu se substituie.
Există varianta de a salva cifrele necesare din primul batch într-un fișier prin udf și a încărca acest fișier prin sideload.
Ce am rezolvat prin aceasta?
Avem aproximativ 100 de furnizori de hoteluri, fiecare poate avea mai multe conexiuni, să le numim canal. Există aproximativ 300 de aceste canale, fiecare dintre canale poate cădea. Din toate metricile înregistrate, vom monitoriza rata erorilor (requests și errors).
De ce nu grafana?
Alerta pe erori, configurată în grafana, are câteva dezavantaje. Unele sunt critice, pentru altele se poate închide ochii, în funcție de situație.
Grafana nu știe să facă calcule între măsurători + alertele, iar noi avem nevoie de rata (requests-errors)/requests.
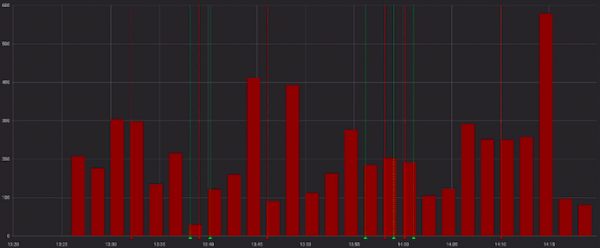
Erorile arată urât:
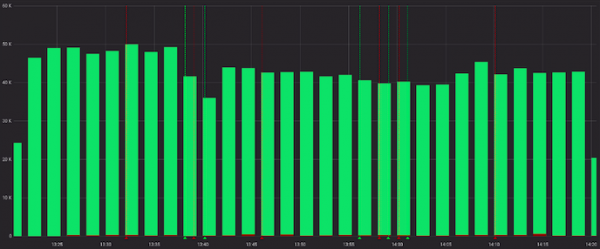
Și mai puțin urât, dacă ne uităm la cererile reușite:
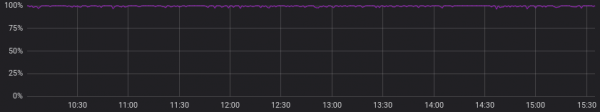
Okay, putem calcula preliminar rata în serviciul până la Grafana, iar în unele cazuri aceasta poate fi adecvată. Dar nu în cazul nostru, deoarece pentru fiecare canal se consideră un raport „normal” diferit, iar alertarea funcționează pe baza valorilor statice (cercetăm vizual, modificăm dacă alertarea este frecventă).
Acestea sunt exemple de „normal” pentru diferite canale:
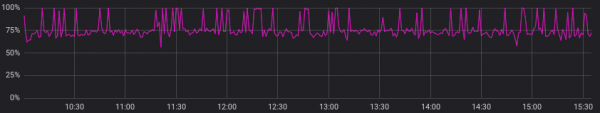
Să ignorăm punctul anterior și să presupunem că toți furnizorii au o imagine „normală” similară. Acum este totul bine și putem trăi cu alertele din Grafana?
Putem, dar nu ne place deloc, deoarece trebuie să alegem una dintre opțiuni:
a) să facem multe grafice pentru fiecare canal în parte (și să ne chinuim să le întreținem)
b) să păstrăm un singur grafic cu toate canalele (și să ne pierdem în linii colorate și alerte configurate)
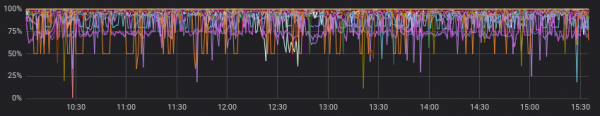
Ce am făcut?
Din nou, în documentație există un exemplu de start bun (), putem să ne privind sau să-l folosim ca bază în sarcini similare.
Ce am realizat în final:
- unirea a două serii în câteva ore, grupare pe canale;
- completăm seriile pe grupuri, dacă nu au fost date;
- comparăm mediana ultimelor 10 minute cu datele anterioare;
- strigăm dacă am descoperit ceva;
- scriem ratele calculate și alertele care au apărut în influxdb;
- trimitem un mesaj util în slack.
În opinia mea, am reușit să obținem maximul din ceea ce ne-am dori să avem la ieșire (și chiar un pic mai mult cu handleri personalizați).
Pe github.com puteți vedea și a scriptului obținut.
Exemplul de cod rezultat:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
  // umplem valorile cu zerouri, dacă nu au fost
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
  // if în lambda: calculăm rata, doar dacă au fost erori
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// introducem valorile calculate în influx
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// luăm datele pentru ultimele 10 minute, calculăm mediana
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // adunăm în mesaj un link către graficul dashboardului Grafana
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} erori/rapoarte ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}Este bine acum{{ else }}
'+string(todayPeriod)+' mediana este {{ index .Fields "today.median" | printf "%0.2f" }}%, comparativ cu '+string(period)+' precedentă {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+
'?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }} / {{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" îl duplicăm ca "value", de asemenea scriem în influx celelalte câmpuri ale alertului (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
Și care este ieșirea?
Kapacitor reușește să efectueze monitorizarea și alertarea cu o mulțime de grupări, să efectueze calcule suplimentare pe metricile deja înregistrate, să efectueze acțiuni personalizate și să ruleze scripturi (udf).
Pragul de intrare nu este foarte ridicat – încercați-l, dacă Grafana sau alte instrumente nu vă satisfac complet dorințele.
Sursa: habr.com
