

Після п'яти місяців розробки опубліковано випуск проекту IncidentRelay 1.1, який розвиває відкриту систему для організації чергувань, маршрутизації оповіщень та супроводу інцидентів, що запускається на власному сервері (self-hosted). IncidentRelay 1.1 відзначений як перший стабільний випуск (гілка 1.0 мала статус бета-версії). Проект орієнтований на SRE, DevOps та інфраструктурні команди, яким потрібна локально розгортається альтернатива SaaS-сервісам для управління чергуванням (on-call management), застосування політик ескалації та реагування на інциденти. Код проекту написано на Python і поширюється під ліцензією MIT.
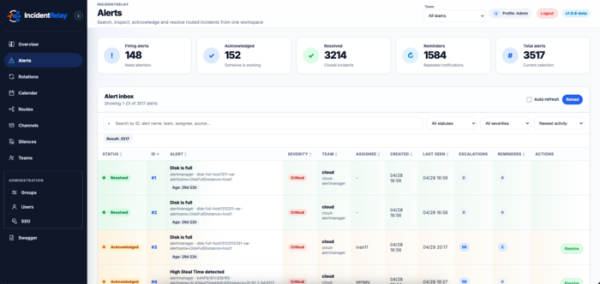
IncidentRelay приймає події із систем моніторингу, зіставляє їх із сервісом, командою та ротацією, після чого доставляє повідомлення відповідальним черговим чи командам. У системі реалізовано розклад чергувань, ротації, перевизначення змін, підтвердження отримання інциденту, стану ACK/Resolve, нагадування, ескалації, тимчасові заміни чергових, визначення часу планових робіт та придушення гучних алертів.
Основна перевага проекту – повний контроль над інфраструктурою та логікою маршрутизації. IncidentRelay розгортається у своєму середовищі, працює зі своєю базою даних і дозволяє явно розділити вхідні маршрути, команди, ротації та канали доставки. Вхідні токени належать маршрутам, а не каналам, тому простіше зрозуміти, яке зовнішнє джерело має право відправляти події до конкретної команди.
У IncidentRelay підтримується прийом подій з Prometheus Alertmanager, Grafana Alerting, Zabbix, Sentry, LibreNMS, RMON, AWS SNS/CloudWatch та довільних webhook-ів. Для надсилання повідомлень передбачені канали Mattermost, Slack, Telegram, Discord, Microsoft Teams, email, webhook-і, browser/PWA push та провайдери голосових дзвінків. Mattermost і Telegram повідомлення можуть містити дії для підтвердження та вирішення проблеми, що дозволяє обробляти інцидент без переходу в окремий інтерфейс.
Проект можна запускати через Docker Compose, RPM-пакет для Red Hat-подібних дистрибутивів, вручну через systemd, а також Kubernetes за допомогою Helm-чарта. Для невеликих інсталяцій можна використовувати SQLite, для робочих чистем та вищого навантаження рекомендується PostgreSQL.
У новій версії запропоновано такі зміни:
- Додані багаторівневі on-call ротації з обмеженнями часу, пріоритетами шарів та врахуванням тимчасових замін;
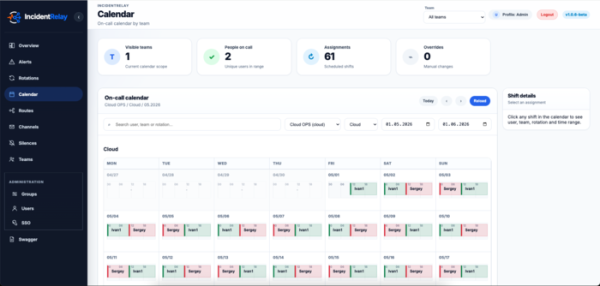
- З'явився календар чергувань, CalDAV та ICS-підписки для зовнішніх календарів;
- Реалізовано політики ескалації інцидентів із багатокроковими ланцюжками підвищення рівня;
- Додано групи попереджень, угруповання подій, відкладені повідомлення та ручне об'єднання пов'язаних алертів;
- З'явилися вікна для проведення планових робіт та «тихі» алерти;
- Додано можливість додавання коментарів до алертів;
- Додано пріоритети інцидентів (P1-P5) та автоматичне підвищення пріоритету за рівнем важливості;
- Реалізовано сервісний каталог, залежність сервісів, SLI/SLO, історію впливу на роботу систем (Service Impact History) та бізнес-сервіси (Business Services);
- З'явився Explain Trace для розбору маршрутизації: чому алерт потрапив чи не влучив у команду, був згрупований, пригнічений чи відправлений у конкретний канал;
- Додані перевірки (Heartbeats/dead-man-switch) для watchdog, backup, ETL та інших завдань, де проблемою є відсутність очікуваного сигналу.
Джерело: opennet.ru
