

Dnes už pravděpodobně nikomu nevzniká otázka, proč je důležité sbírat metriky služeb. Dalším logickým krokem je nastavit alerting na shromážděné metriky, který vás upozorní na jakékoliv odchylky v datech v pro vás vhodných kanálech (e-mail, Slack, Telegram). V službě online rezervace hotelů všechny metriky našich služeb tečou do InfluxDB a jsou zobrazeny v Grafaně, kde je také nastaven základní alerting. Pro úkoly jako „je potřeba něco spočítat a porovnat s tím“ používáme Kapacitor.
Kapacitor je součástí TICK stacku, který umí zpracovávat metriky z InfluxDB. Může spojit několik měření mezi sebou (join), z získaných dat vypočítat něco užitečného, zapsat výsledek zpět do InfluxDB a poslat alert do Slacku/Telegramu/e-mailu.
Celý stack má skvělou a podrobnou , ale vždy se najdou užitečné věci, které nejsou v manuálech přímo uvedeny. V tomto článku jsem se rozhodl shromáždit řadu takových užitečných, ale nejasných rad (základní syntax TICKscriptu je popsána ) a ukázat, jak je možné je aplikovat na příkladu řešení jednoho z našich úkolů.
Začínáme!
float & int, chyby ve výpočtech
Naprostá standardní problém, řeší se přes cast:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Použití default()
Pokud tag/pole není vyplněno, dojde k chybám ve výpočtech:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill v join (inner vs outer)
Ve výchozím nastavení join odhodí body, kde nejsou data (inner).
Při fill(‘null’) dojde k provedení outer join, po kterém je třeba provést default() a vyplnit prázdné hodnoty:
var data = res1
    |join(res2)
        .as('res1', 'res2')
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Zde je přesto jeden obrat. Pokud v příkladu výše bude jedna ze sérií (res1 nebo res2) prázdná, výsledná série (data) bude také prázdná. Na toto téma existuje několik tiketů na GitHubu (, , ) – čekáme na opravy a trochu trpíme.
Použití podmínek ve výpočtech (if v lambda)
|eval(lambda: if("value" > 0, true, false)
Posledních pět minut z pipeline za období
Například, potřebujete porovnat hodnoty posledních pěti minut s předchozím týdnem. Můžete vzít dva balíčky dat dvěma samostatnými batchi nebo vytáhnout část dat z většího období:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Alternativou pro posledních pět minut může být použití nody BarrierNode, která ořízne data dříve, než je stanovený čas:
|barrier()
        .period(5m)
Příklady použití šablon v Go v message
Šablony odpovídají formátu z balíčku , níže několik často se vyskytujících úloh.
if-else
Urovnáváme pořádek, nevyvoláváme zbytečně reakci lidí textem:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Je to v pořádku{{ else }}Šéfe, všechno je rozbité{{end}}'
    )
Dvě číslice za desetinnou čárkou v message
Zlepšujeme čitelnost zprávy:
|alert()
    ...
    .message(
        'nyní je hodnota {{ index .Fields "value" | printf "%0.2f" }}'
    )
Rozbalení proměnných v message
Zobrazujeme ve zprávě více informací pro odpověď na otázku "Proč vlastně křičí"?
var warnAlert = 10
  |alert()
    ...
    .message(
       'Dnešní hodnota je menší než '+string(warnAlert)+'%'
    )
Unikátní identifikátor alertu
Potřebná věc, když je v datech více než jedna skupina, jinak bude generován pouze jeden alert:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Vlastní handlery
V dlouhém seznamu handlerů je exec, který umožňuje spustit váš skript s předanými parametry (stdin) – to je teprve kreativita!
Jedním z našich vlastních řešení je malý python skript pro odesílání oznámení do Slacku.
Nejdříve jsme chtěli poslat do zprávy obrázek z Grafany chráněné autorizací. Poté jsme chtěli psát OK do vlákna předchozího alertu ze stejné skupiny, a ne jako samostatnou zprávu. Ještě o trochu později – doplňovat do zprávy nejčastější chybu za posledních X minut.
Samostatné téma – připojení k jiným službám a provádění jakýchkoli akcí iniciovaných alertem (pouze pokud váš monitoring funguje dostatečně dobře).
Příklad popisu handleru, kde slack_handler.py je náš vlastní skript:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Jak ladit?
Variant s výpisem do logu
|log()
      .level("error")
      .prefix("something")
Sledovat (cli): kapacitor -url :9092 logs lvl=error
Variant s httpOut
Zobrazuje data v aktuálním pipeline:
|httpOut('something')
Sledovat (get): :9092\/kapacitor\/v1\/tasks\/task_name\/something
Schéma provádění
- Každý úkol vrací strom provedení s užitečnými čísly ve formátu .
- Bereme blok .
- Vložte do vieweru, .
Kde jinde lze získat timestamp v InfluxDB při zpětném zápisu?
timestamp v influxdb při zpětném zápisu
Například nastavujeme alert na množství dotazů za hodinu (groupBy(1h)) a chceme zaznamenat vzniklý alert do influxdb (abychom hezky ukázali fakt existence problému na grafu v grafana).
influxDBOut() zaznamená do timestamp hodnotu time z alertu, a tedy bod na grafu bude zaznamenán dříve/později, než přišel alert.
Když je požadována přesnost: obcházíme tento problém pomocí volání custom handler’a, který zapíše data do influxdb s aktuálním timestamp'em.
docker, sestavení a nasazení
Při startu kapacitor může načíst úkoly, šablony a handlery z adresáře uvedeného v konfigu, v bloku [load].
Pro správné vytvoření úkolu jsou potřeba následující věci:
- Název souboru – rozvíjí se na id/název skriptu
- Typ – stream/batch
- dbrp – klíčové slovo pro určení, ve které databázi + politice skript pracuje (dbrp „supplier“.„autogen“)
Pokud v nějaké batch úloze nebude řádek s dbrp, celý servis se odmítne spustit a upřímně to napíše do logu.
V chronografu však tato řádka být nemá, přes rozhraní není přijímána a vyhazuje chybu.
Hack při sestavení kontejneru: Dockerfile končí s -1, pokud jsou tam řádky s //.+dbrp, což okamžitě umožní pochopit příčinu selhání při sestavení buildu.
join jedna k mnoha
Úkol-příklad: je potřeba vzít 95. percentil doby běhu služby za týden, srovnat každou minutu z posledních 10 s touto hodnotou.
Nelze provést join jedna k mnoha, last/mean/median podle skupiny bodů převádí uzel do streamu, vrátí chybu „cannot add child mismatched edges: batch -> stream“.
Výsledek batch’e, jako proměnné v lambda výrazu, se také nezapočítává.
Existuje možnost ukládat potřebná čísla z prvního batch’e do souboru přes udf a načíst tento soubor přes sideload.
Co jsme tímto řešili?
Máme kolem 100 dodavatelů hotelů, každý z nich může mít několik připojení, nazvěme to kanál. Těchto kanálů je přibližně 300, každý z kanálů může vypadnout. Z všech zaznamenávaných metrik budeme monitorovat míru chyb (requests a errors).
Proč ne grafana?
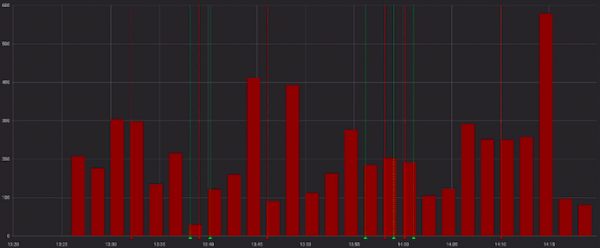
Alerte na chyby nastavené v grafaně mají několik nevýhod. Některé jsou kritické, na některé se dá v závislosti na situaci přivřít oko.
Grafana neumí výpočty mezi metrikami + alerting, a my potřebujeme míru (requests-errors)/requests.
Chyby vypadají zlověstně:
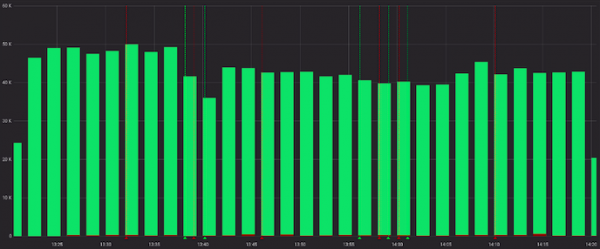
A méně zlověstně, pokud se díváte na úspěšné dotazy:
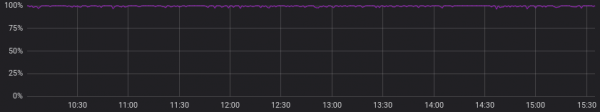
Dobře, můžeme předběžně vypočítat poměr v službě před Grafanou, a v některých případech to bude vyhovovat. Ale ne v našem případě, protože pro každý kanál se počítá jiné "normální" poměr, a alarmy fungují na statických hodnotách (hledáme očima, měníme, pokud často upozorňuje).
To jsou příklady "normální" pro různé kanály:
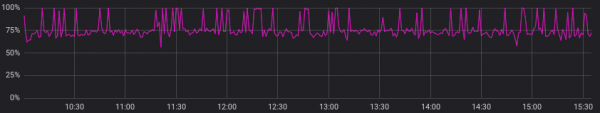
Přeskočme předchozí bod a předpokládejme, že u všech poskytovatelů je "normální" obraz podobný. Teď je to dobré a vystačíme si s alarmy v Grafaně?
Můžeme, ale moc se nám nechce, protože je třeba vybrat jednu z možností:
a) udělat spoustu grafů pro každý kanál zvlášť (a trápit se s jejich údržbou)
b) nechat jeden graf se všemi kanály (a ztratit se v barevných liniích a nastavených alarmech)
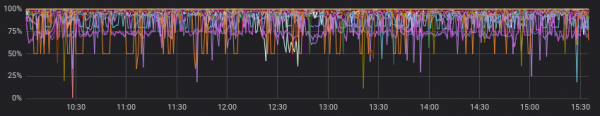
Jak jsme udělali?
Opět v dokumentaci je dobrý výchozí příklad (), který si můžete prohlédnout nebo použít jako základ pro podobné úkoly.
Co jsme nakonec udělali:
- spojuje dvou sérií za několik hodin, seskupení podle kanálů;
- vyplňujeme série podle skupin, pokud nebyly žádné data;
- porovnáváme medián posledních 10 minut s předchozími daty;
- křičíme, pokud něco zjistíme;
- zapíšeme vypočtené poměry a vyskytlé alarmy do influxdb;
- odesíláme užitečnou zprávu do slacku.
Podle mého názoru se nám maximálně podařilo vše, co bychom chtěli mít na výstupu (a dokonce o něco více s vlastními handlery).
Na github.com si můžete prohlédnout a získaného skriptu.
Příklad výsledného kódu:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // naplníme hodnoty nulami, pokud nebyly
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // if v lambda: počítáme rate, pouze pokud byly chyby
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// zapisujeme vypočítané hodnoty do influx
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// vybíráme data za posledních 10 minut, počítáme medián
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // shromažďujeme do message odkaz na graf d Dashboardu grafány
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} chyb/požadavek ratio ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}Nyní je to v pořádku{{ else }}
'+string(todayPeriod)+' medián je {{ index .Fields "today.median" | printf "%0.2f" }}%, podle předchozího '+string(period)+' je {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+'
?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }} / {{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" duplikujeme jako "value", také zapisujeme do influx ostatní pole alertu (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
Jaký je výstup?
Kapacitor výborně zvládá monitorování a alarmování s mnoha seskupeními, provádí dodatečná výpočty na již zapsaných metrikách, provádí vlastní akce a spouští skripty (udf).
Práh vstupu není příliš vysoký – vyzkoušejte to, pokud grafana nebo jiné nástroje zcela neodpovídají vašim požadavkům.
Zdroj: habr.com
