

Denne note vil være interessant for dem, der bruger databehandlingsbiblioteket til R - data.table, og måske vil være glade for at se fleksibiliteten i dens anvendelse i forskellige eksempler.
Inspiration fra et godt eksempel , og i håbet om, at du allerede har læst hans artikel, foreslår jeg at dykke dybere ned i optimering af kode og ydelse baseret på data.table.
Introduktion: hvor kommer data.table fra?
Det er bedst at starte bekendtskab med biblioteket lidt udefra, nemlig med de datatyper, som et data.table-objekt (fremover D.T.) kan opnås fra.
Array
Kode
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
En af disse strukturer er et array (?base::array). Som i andre sprog er arrays her flerdimensionale. Men det interessante er, at for eksempel et todimensionelt array begynder at arve egenskaber fra matrixklassen (?base::matrix), mens et endimensionelt array, hvilket også er vigtigt, ikke arver fra vektoren (?base::vector).
Her skal man forstå, at datatypen i et objekt skal kontrolleres med funktionen base::typeof, som returnerer en intern beskrivelse af typen i henhold til R Internals — et generelt protokol for sproget, der relaterer til den oprindelige C.
En anden kommando til at bestemme klassens objekt, base::class, returnerer for vektorer den vektoriske type (den adskiller sig i navnet fra den interne, men gør det også muligt at forstå datatypen).
Liste
Fra det todimensionale array, også kaldet matrix, kan man gå videre til en liste (?base::list).
Kode
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Der sker flere ting på én gang:
- Det andet mål i matrixen komprimeres, så vi får både en liste og en vektor.
- Listen arver således fra disse klasser. Det er vigtigt at have i tankerne, at listen element svarer til én (skalar) værdi fra cellen i matrix-arrayet.
Takket være det, at listen også er en vektor, kan visse funktioner anvendes til vektorer.
Dataframe
Fra listen, matrix eller vektor kan man gå over til en dataframe (?base::data.frame).
Kode
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Det interessante ved det er: dataframe arver fra listen! Kolonnerne i dataframen er cellerne i listen. Dette vil være vigtigt senere, når vi bruger funktioner, der anvendes til lister.
data.table
At få D.T. (?data.table::data.table) er muligt fra dataframe, liste, vektor eller matrix. For eksempel sådan (on place).
Kode
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Det er nyttigt, at D.T. ligesom dataframe arver egenskaberne fra listen.
D.T. og hukommelse
I modsætning til alle andre objekter i R-base overføres DT ved reference. Hvis du har brug for at lave en kopi til et nyt hukommelsesområde, skal du bruge funktionen data.table::copy eller du skal vælge fra det gamle objekt.
Kode
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Her slutter introduktionen. DT er en videreudvikling af datastrukturer i R, som primært sker gennem udvidelse og acceleration af operationer udført på objekter af klassen data.frame. Samtidig bevares arven fra andre primtaler.
Nogle eksempler på anvendelse af egenskaberne data.table
Som en liste…
At iterere over rækkerne i en data.frame eller DT er ikke den bedste idé, fordi loop koden i sproget R er langt langsommere C, men at gå gennem kolonnerne, som der normalt er væsentligt færre af, er helt muligt. Når vi går gennem kolonnerne, skal vi huske, at hver kolonne er et listeelement, der typisk indeholder en vektor. Og operationer på vektorer er godt vektoriserede i sprogets grundlæggende funktioner. Det er også muligt at bruge udvalg operatører, der er karakteristiske for lister og vektorer: `[[`, `$`.
Kode
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vektorisering
Hvis der er behov for at gå gennem rækkerne i en stor DT, er den bedste løsning at skrive en funktion med vektorisering. Men hvis det ikke er muligt, skal man huske, at loopet indenfor DT er stadig hurtigere end loopet i R, fordi det udføres på C.
Lad os prøve med et større eksempel med 100K rækker. Vi vil trække det første bogstav fra ord, der indgår i vektor-kolonnen w.
Opdateret
Kode
library(magrittr)
library(microbenchmark)

## Større eksempel ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vektorisering

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# andet

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# tredje

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Første kørsel med iteration over rækker:
Unit: millisekunder
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
Andet løb, hvor vektoriseringen sker ved at omdanne en liste til en matrix og tage elementerne på skærer med indeks 1 (sidste er selve vektoriseringen). Jeg korrigerer: vektorisering på funktionsniveau strsplit, som kan tage en vektor som input. Det viser sig, at proceduren til at omdanne en liste til en matrix er meget tungere end selve vektoriseringen, men i dette tilfælde er det stadig meget hurtigere end den ikke-vektorisede version.
Unit: millisekunder
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Fremgang over medianen med 3 gange.
Tredje løb, hvor skemaet til omdannelse til en matrix er ændret.
Unit: millisekunder
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Fremgang over medianen med 13 gange.
Man må eksperimentere med dette; jo mere, desto bedre.
Endnu et eksempel med vektorisering, hvor teksten også er til stede, men den er tættere på reelle forhold: varierende længde af ord, varierende antal ord. Det kræver at tage de første 3 ord. Sådan her:
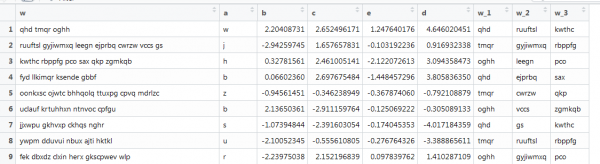
Her fungerer den tidligere funktion ikke længere, da vektorerne har varierende længde, og vi havde angivet størrelsen af matricen. Lad os ændre det ved at søge på internettet.
Kode
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Unit: millisekunder
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Scriptet arbejdede med en gennemsnitlig hastighed på 1 sekund. Ikke dårligt.
Forbundet med et kæde…
Man kan arbejde med DT-objekter ved at bruge chaining. Det ser ud som tilføjelse af parentes-syntaks til højre, i bund og grund er det sukker.
Kode
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Løber gennem rørene…
De samme operationer kan udføres ved hjælp af piping, det ser lignende ud, men er funktionelt rigere, da man kan bruge enhver metode og ikke kun DT. Lad os udlede koefficienterne for logistisk regression for vores syntetiske data med en række filtre på DT.
Kode
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Statistik, maskinlæring og mere inden for DT
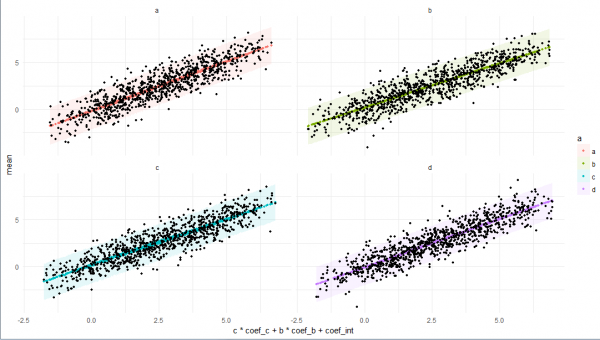
Man kan bruge lambda-funktioner, men nogle gange er det bedre at oprette dem separat, skrive hele dataanalysepipelinen, og så videre - de arbejder inden for DT. Eksemplet er beriget med alle de nævnte funktioner samt nogle nyttige ting fra DT's arsenal (soff som at henvise til selve DT inde i DT ved link, nogle gange indsat ikke sekventielt, men for at gøre det).
Kode
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Konklusion
Jeg håber, at jeg har formået at skabe et sammenhængende, men selvfølgelig ikke fuldstændigt, billede af objekter som data.table, fra dets egenskaber relateret til arv fra R-klasser til dets egne funktioner og omgivelser fra tidyverse-elementer. Jeg håber, dette hjælper dig med at lære bedre og anvende dette bibliotek til arbejde og underholdning.
Tak!
Fuld kode
Kode
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Kilde: habr.com
