

Mõnikord, et lahendada mõni probleem, tuleb sellele lihtsalt teise nurga alt vaadata. Isegi kui viimased kümme aastat on sarnaseid probleeme lahendatud sama meetodiga erineva tulemusega, ei pruugi see meetod olla ainus.
On teema, nagu klientide lahkumine. See on vältimatu nähtus, sest igal ettevõtte kliendil on põhjuseid, miks nad võivad lõpetada selle toodete või teenuste kasutamise. Loomulikult ei ole lahkumine ettevõtte jaoks soovitav sündmus, seega püüavad kõik seda minimaalset hoida. Veel parem on prognoosida lahkumise tõenäosust teatud kasutajate kategooriates või konkreetse kasutaja puhul ning pakkuda lahendusi nende säilitamiseks.
Klienti analüüsida ja püüda teda säilitada, kui see on võimalik, on vajalik vähemalt järgmistel põhjustel:
- uute klientide kaasamine on kallim kui säilitamine. Uute klientide kaasamiseks kulub tavaliselt teatud summad (reklaam), samas kui olemasolevaid kliente saab aktiveerida eripakkumisega, millel on erilised tingimused;
- klientide lahkumise põhjuste mõistmine on võtmetähtsusega toodete ja teenuste parendamiseks.
Lahkumise prognoosimiseks on olemas standardmeetodid. Kuid ühes tehisintellekti meistrivõistlustel otsustasime proovida selleks Weibulli jaotust. Seda kasutatakse kõige sagedamini ellujäämise analüüsimiseks, ilmaennustamiseks, looduskatastroofide analüüsimiseks, tööstusinsenerias ja mujal. Weibulli jaotus on spetsiaalne jaotuse funktsioon, millel on kaks parameetrit.  ja
 .
Vikipeedia
Üldiselt on see huvitav asi, kuid lahkumise prognoosimiseks, ja isegi finantstehnoloogias, ei kasutata seda nii sageli. Allpool räägime, kuidas me (Andmeanalüüsi Labor) seda tegime, kattes kuldmedali tehisintellekti meistrivõistlustel kategoorias „AI pankades”.
Lahkumisest üldiselt
Vaatame veidi lähemalt, mis on kliendihäving ja miks see on nii oluline. Äri jaoks on kliendibaas tähtis. Sellesse baasi tulevad uued kliendid, näiteks tutvuvad nad tootega või teenusega reklaami kaudu, elavad seal mõnda aega (kasutavad aktiivselt tooteid) ja mingil hetkel lõpetavad selle kasutamise. Seda perioodi nimetatakse "Kliendi elutsükliks" (ingl. k. Customer Lifecycle) — see on termin, mis kirjeldab etappe, mida klient läbib, kui ta tutvub tootega, teeb ostuotsuse, maksab, kasutab ja muutub lojaalseks tarbijaks, ning lõpuks lõpetab toote kasutamise erinevatel põhjustel. Seega on häving lõppstaadium kliendi elutsüklist, mil klient lõpetab teenuste kasutamise, mis tähendab ettevõttele, et klient ei too enam kasumit ja ei too üldse mingit kasu.
Iga panga klient on konkreetne inimene, kes valib ühe või teise pangakaardi spetsiaalselt oma vajaduste jaoks. Reisib sageli — sobib kaart miilidega. Ostab palju — tere, kaardikass tagasi. Ostab palju konkreetsetes kauplustes — ja selle jaoks on juba olemas spetsiaalne partnerkaart. Loomulikult valitakse kaart vahel ka kriteeriumi järgi "odavaim teenindus". Ühesõnaga, muutujaid on siin küllalt.
Inimene valib ka pangandi — miks valida panga kaart, mille filiaalid asuvad ainult Moskvas ja piirkonnas, kui sa oled Habarovskist? Olgu see pangakaart isegi kaks korda kasulikum, kuid panga filiaalide olemasolu läheduses on endiselt oluline kriteerium. Jah, 2019 on juba käes ja digitaalne on meie kõik, kuid teatud küsimusi saab mõnes pangas lahendada ainult filiaalis. Pluss, jälle, osa elanikkonnast usaldab palju rohkem füüsilist panka kui nutitelefoni rakendust, seda tuleb samuti arvesse võtta.
Seetõttu võib inimesel olla palju erinevaid põhjuseid panga toodetest (või pangast endast) loobumiseks. Vahetas tööd ja kaardi tarifikatsioon muutus palgakaardilt "Lihtsate surelike jaoks", mis on vähem kasulik. Kolis teise linna, kus ei ole pangafiliale. Ei meeldinud suhtlemine kvalifitseerimata pangatöötajaga filiaalis. Seega võivad pangakonto sulgemise põhjused olla isegi palju arvukamad kui toote kasutamise põhjused.
Kliendil on võimalus mitte ainult selgelt väljendada oma kavatsust — minna panka ja kirjutada avaldus, vaid ka lihtsalt lõpetada toodete kasutamine, katkestamata lepingut. Just selliste probleemide lahendamiseks otsustati kasutada masinõpet ja tehisintellekti.
Tõepoolest, klientide lahkumine võib toimuda igas valdkonnas (telekom, internetiteenuse pakkujad, kindlustusfirmad — igal pool, kus on kliendibaas ja perioodilised tehingud).
Mida me tegime
Esmalt tuli määratleda selge piir, millal me hakkame arvestama, et klient on lahkunud. Panga jaoks, kes andis meile töötamiseks andmed, oli kliendi aktiivsuse seisund binaarne — ta oli kas aktiivne või mitte. Andmebaasi tabelis "Aktiivsus" oli flag ACTIVE_FLAG, mille väärtuseks võis olla kas "0" või "1" (vastavalt "Mitteaktiivne" ja "Aktiivne"). Kõik oleks hästi, kuid inimene on selline, et võib mõnda aega aktiivselt kasutada, seejärel aga jääda kuuks ajaks mitteaktiivseks — ta on haigena, reisib teise riiki puhkama või katsetab hoopis teise panga kaarti. Võib-olla hakkab ta pärast pikka mitteaktiivsuse perioodi uuesti panga teenuseid kasutama.
Seetõttu otsustasime nimetada mitteaktiivsuse perioodiks teatud katkematu ajavahemiku, mille jooksul tema flag oli seatud "0".
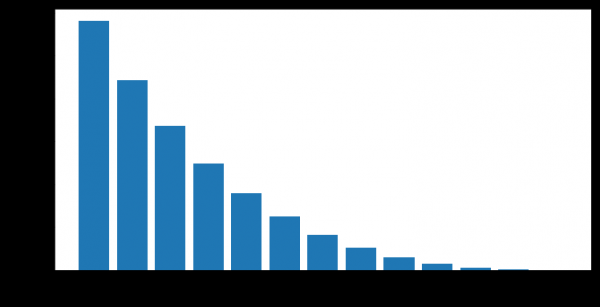
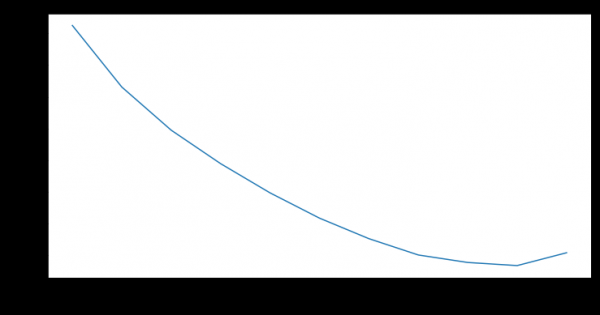
Kliendid muudavad mitteaktiivsed aktiivseteks pärast erineva pikkusega mitteaktiivsuse perioode. Meil on võimalus arvutada empiirilise suuruse "mitteaktiivsuse perioodide usaldusväärsus" — ehk tõenäosus, et inimene hakkab uuesti panga tooteid kasutama pärast ajutist mitteaktiivsust.
Näiteks, siin diagrammil on kujutatud klientide aktiivsuse taastumist (ACTIVE_FLAG=1) pärast mitut kuud mitteaktiivsust (ACTIVE_FLAG=0).
Siin täpsustame andmestikku, millega hakkasime töötama. Pangaklient andis 19 kuu kokkuvõtete andmed järgmistes tabelites:
- "Aktiivsus" — kliendi kuised tehingud (kaardiga, internetipangas ja mobiilipangas), sealhulgas palkade laekumised ja teave käivete kohta.
- "Kaardid" — andmed kõikide kaartide kohta, mis kliendil on, koos üksikasjaliku hinnakirjaga.
- „Lepingud“ – teave kliendi lepingute kohta (nii avatud kui suletud): laenud, hoiused ja muu, igaühe parameetritega.
- „Kliendid“ – demograafiliste andmete kogum (sugu ja vanus) ning kontaktandmete olemasolu.
Meie töös vajati kõiki tabeleid, välja arvatud „Kaardid“.
Siin oli keerukus veel selles, et need andmed ei näidanud, milline tegevus kaardiga toimus. Me saime aru, kas tehingud toimusid või mitte, kuid nende tüüpi määramine oli juba keeruline. Seetõttu ei olnud selge, kas klient võttis sularaha, sai palka või kasutas raha ostude jaoks. Ja meil ei olnud ka konto saldode andmeid, mis oleks olnud kasulikud.
Valimine oli mittekatkestamata – selle lõike jaoks ei olnud pank 19 kuu jooksul teinud mingeid katseid klientide hoidmiseks ja lahkumise vähendamiseks.
Nii et nüüd räägime mitteaktiivsuse perioodidest.
Lahkumise määratlemiseks tuleb valida mitteaktiivsuse periood. Selleks, et luua lahkumise prognoos kindlal hetkel,  , peab olema kliendi ajalugu vähemalt 3 kuud antud ajavahemikus.
 Meie ajalugu oli piiratud 19 kuuga, seetõttu otsustasime võtta mitteaktiivsuse perioodiks 6 kuud, kui see on olemas. Kvaliteetse prognoosi jaoks võtsime minimaalperioodiks 3 kuud. Numbrid 3 ja 6 kuud põhinevad empiiriliselt antud klientide käitumise analüüsil.
Lahkumise määratlesime järgmiselt: kliendi lahkumise kuu  on esimene kuu, mil ACTIVE_FLAG=0, kus alates sellest kuust on ACTIVE_FLAG väljal järjest vähemalt kuus nulli. Teisisõnu, kuu, mil klient oli 6 kuud mitteaktiivne.
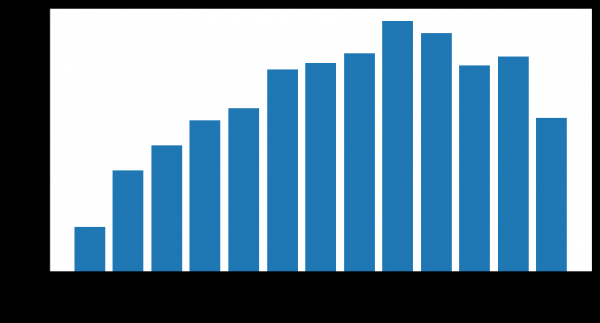
Lahkunud klientide arv
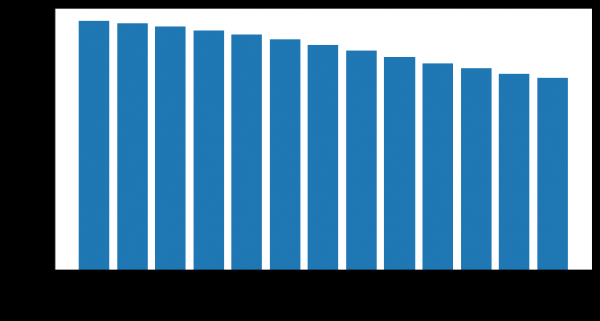
Jäänud klientide arv
Kuidas tavaliselt püstitada lahkumisprognoosi
Sarnastes võistlustes ja praktikas prognoositakse lahkumist sageli sellisel viisil. Klient kasutab tooteid ja teenuseid erinevates ajavahemikes, tema suhtluse andmed esitatakse fikseeritud pikkusega tunnuste vektorina n. Enamasti sisaldavad need andmed:
- Kliendi iseloomustavad andmed (demograafilised andmed, turunduse segment).
- Panga toodete ja teenuste kasutamise ajalugu (need on tegevused, mis on alati seotud konkreetse aja või soovitud ajavahemiku perioodiga).
- Välisteavet, kui seda on õnnestunud hankida — näiteks sotsiaalmeedia arvustused.
Ja alles pärast seda antakse igale ülesandele välja lahendus klientide lahkumise määratlemiseks. Seejärel kasutatakse masinõppe algoritmi, mis ennustab kliendi lahkumise tõenäosust  tuginedes tegurite vektorile
 . Algoritmi treenimiseks kasutatakse ühte tuntud otsustuspuude ansamblite raamistikku, , , või nende modifikatsioone.
Isegi algoritm on hea, kuid just klienditeeninduse prognoosimise osas on tal mitmeid tõsiseid puudusi.
- Talle ei meeldi nn „mälu”. Mudelile edastatakse etteantud arv tunnuseid, mis vastavad praegusele ajahetkele. Ajaloo teabe sisestamiseks muudatuste kohta on vajalik arvutada erilisi tunnuseid, mis iseloomustavad parameetrite muutusi ajas, näiteks pangatehingute arvu või summa viimase 1, 2, 3 kuu jooksul. Selline lähenemine võib vaid osaliselt peegeldada ajaliselt muutuvate andmete olemust.
- Määratud prognoosihorisont. Mudel suudab prognoosida klienditeeninduse lahkumist ainult eelnevalt määratud ajavahemikuks, näiteks kuu aja prognoosiks. Kui on vajalik prognoos teise ajavahemiku kohta, näiteks kolme kuu kohta, siis tuleb ümber ehitada treenimisnäidist ja uut mudelit uuesti treenida.
Meie lähenemine
Otsustasime kohe, et ei kasuta standardseid lähenemisi. Meie kõrval registreerus meistrivõistlustel veel 497 osalejat, kellest igaühel oli muljetavaldav kogemus. Seega sellistes tingimustes standardse skeemi järgimine — ei ole parim idee.
Ja hakkasime lahendama mudeli binaarse klassifitseerimisega seotud probleeme, kasutades kliendi lahkumise tõenäosuse jaotuse prognoosimist. Sarnast lähenemist saab vaadata , see võimaldab paindlikumalt prognoosida lahkumist ja testida keerukamaid hüpoteese kui klassikaline lähenemine. Lahkumise aja modelleerimise jaotuste haru valisime selle laialdase rakendamise pärast ellujäämise analüüsis. Kliendi käitumist võib vaadelda kui mingisugust ellujäämist.
Siin on näited Weibulli tõenäosusjaotuste jaotumisest sõltuvalt parameetritest.  ja
 :
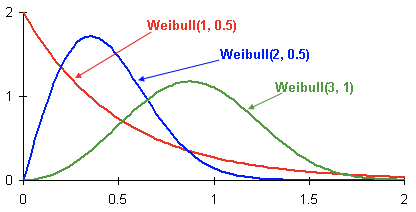
See on kolmest erinevast kliendist kliendi lahkumise tõenäosuse jaotuse tihedus ajas. Aeg on esitatud kuudes. Teisisõnu, see graafik näitab, millal on kõige tõenäolisem, et klient lahkub järgmise kahe kuu jooksul. Nagu näha, on kliendil, kellel on jaotus, suurem potentsiaal lahkuda varem kui klientidel, kellel on Weibulli jaotused (2, 0,5) ja Weibulli jaotused (3,1).
Tulemusena saadakse mudel, mis iga kliendi jaoks igaks
kuuks prognoosib Weibulli jaotuse parameetreid, mis kõige paremini peegeldavad lahkumise tõenäosuse tekkimist aja jooksul. Täiendavalt:
- Sihtmärkide tunnused koolituskogumis — aeg, mis on jäänud lahkumiseni konkreetse kuu jooksul konkreetse kliendi jaoks.
- Kui kliendi lahkumise näitajat pole, eeldame, et lahkumise aeg on suurem kui kuude arv alates praegusest hetkest kuni olemasoleva ajalooga.
- Kasutatav mudel: rekurssne närvivõrk LSTM-kihiga.
- Kahjufunktsioonina kasutame Weibulli jaotuse negatiivset logaritmilist tõenäosusfunktsiooni.
Siin on meetodi plussid:
- Tõenäosusjaotus, lisaks ilmselgele võimalusele binaarseks klassifitseerimiseks, võimaldab paindlikult prognoosida erinevaid sündmusi, näiteks kas klient lõpetab panga teenuste kasutamise kolme kuu jooksul. Samuti saab seda jaotust kasutada erinevate näitajate keskmistamiseks, kui see on vajalik.
- Rekurssne närvivõrk LSTM-l on mälu ja see kasutab tõhusalt kogu olemasolevat ajalugu. Ajaloo laiendamise või täpsustamise korral täpsus suureneb.
- Seda lähenemist saab probleemideta skaleerida ajavahemike jaotamisel väiksemateks (näiteks kuude jaotamine nädalateks).
Kuid hea mudeli loomine ei piisa, tuleb ka õige kvaliteet hindamine.
Kuidas kvaliteeti hinnati
Kvaliteedi mõõdikuks valisime Lift Curve. Seda kasutatakse äritegevuses sarnastes olukordades selle arusaadava tõlgendamise tõttu, see on hästi kirjeldatud ja . Kui selle mõõdiku tähendust ühes lauses describeerida, siis see kõlaks "Mitu korda algoritm teeb paremat prognoosi esimestel  % võrreldes juhusliku valikuga."
Treeni mudeleid.
Konkurentsi tingimustes ei olnud kindlat kvaliteedimeetrit, mille alusel oleks võimalik võrrelda erinevaid mudeleid ja lähenemisviise. Veelgi enam, lahkumise mõisted võivad olla erinevad ja sõltuda ülesande määratlemisest, mille omakorda määravad ärieesmärgid. Seega, et mõista, milline meetod on parem, koolitasime kahte mudelit:
- Sageli kasutatav lähenemine binaarse klassifitseerimisega, kasutades otsustuspuude ensemblese masinõppe algoritmi ();
- Weibull-LSTM mudel
Testigrupp koosnes 500 eelnevalt valitud kliendist, keda ei olnud koolitusgrupis. Mudeli jaoks tehti hüperparameetrite valimine klientide lõikes läbi ristvalideerimise. Iga mudeli koolitamiseks kasutati samu tunnuste komplekte.
Arvestades, et mudel ei oma mälu, kasutati selle jaoks spetsiaalseid tunnuseid, mis näitasid ühe kuu parameetrite muutumise suhet viimase kolme kuu keskmise väärtusega. See iseloomustas viimase kolme kuu jooksul väärtuste muutumise kiirust. Ilma selleta oleks Random Forest baasil mudel eelnevalt ebasoodsas positsioonis võrreldes Weibull-LSTM-iga.
Miks on LSTM Weibulli jaotuse põhjal parem kui otsustuspuude ensemble'l põhinev lähenemine
Siin on kõik selgelt näidatud paar pildi kaudu.
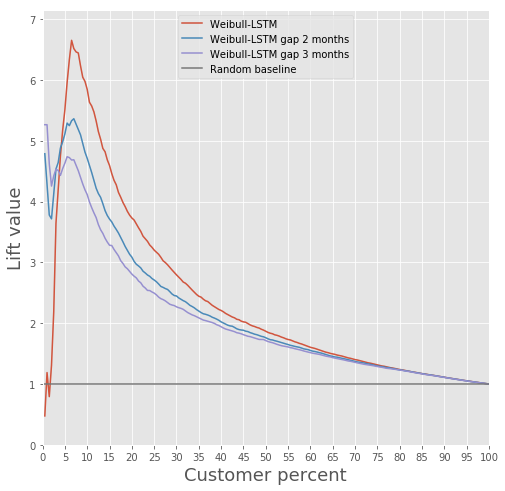
Lift Curve'i võrdlus klassikalise algoritmi ja Weibull-LSTM vahel
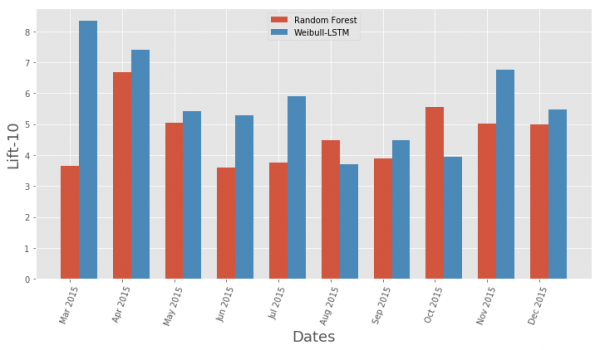
Lift Curve'i metoodika võrdlus kuude lõikes klassikalise algoritmi ja Weibull-LSTM vahel
Üldiselt on LSTM peaaegu igas olukorras klassikalisest algoritmist parem.
Lahkumise ennustamine
Weibulli jaotuse põhjal LSTM rakendatud korduva närvivõrgu mudel suudab lahkumist ette ennustada, näiteks ennustada kliendi lahkumist järgmise n kuu jooksul. Vaatame juhtumit, kus n = 3. Sellisel juhul peab iga kuu närvivõrk õigesti määrama: kas klient lahkub alates järgmisest kuust kuni n-kuu jooksul. Teisisõnu, ta peab õigesti määrama, kas klient jääb pärast n kuud. Seda võib pidada eelnevaks prognoosiks: hetk, mil klient hakkab mõtlema lahkumisele.
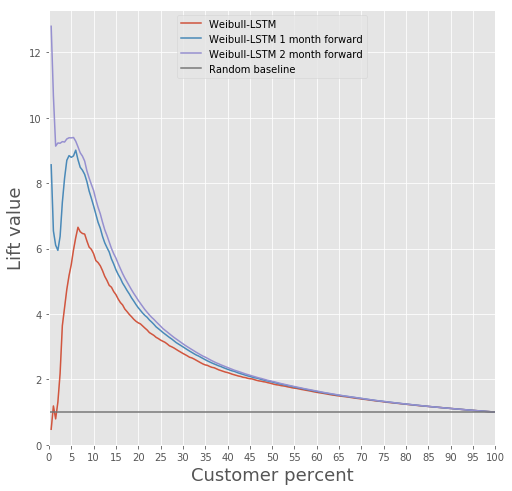
Võrreldame Weibull-LSTM Lift Curve'i 1, 2 ja 3 kuud enne lahkumist:
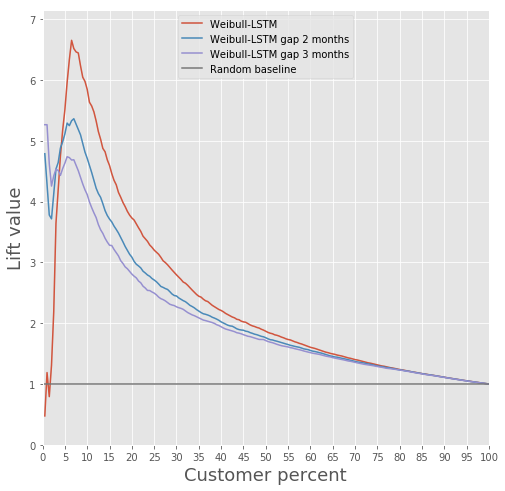
Oleme juba varem maininud, et olulised on ka prognoosid, mis on tehtud klientide kohta, kes on aktiivsest kasutusest mõneks ajaks välja langenud. Seetõttu lisame siia valimisse olukorrad, kui lahkunud klient oli juba üks või kaks kuud mitteaktiivne, ja kontrollime, et Weibull-LSTM i suudaks sellised juhtumid õigesti lahus hoidmiseks klassifitseerida. Kuna sarnased juhtumid olid valimis olemas, siis ootame, et mudel suudab nendega hästi hakkama saada:
Klientide hoidmine
See on tegelikult peamine, mida saate teha, kui teil on käes teave, et teatud kliendid kavatsevad lõpetada toote kasutamise. Rääkides mudeli loomisest, mis võiks klientidele soovitada midagi, et neid hoida — seda ei saa teha, kui teil pole ajalooandmeid sarnaste hästi lõppenud katsete kohta.
Meil sellist ajalugu ei olnud, seega otsustasime selle viisi.
- Loome mudeli, mis määratleb iga kliendi huvitavad tooted.
- Igas kuus käivitame klassifitseerija ja määrame potentsiaalselt lahkuvad kliendid.
- Mõnele kliendile pakume toodet vastavalt punktis 1 kirjeldatud mudelile ja salvestame oma tegevuse.
- Mõne kuu pärast vaatame, kes neist potentsiaalselt lahkuvad klientidest on lahkunud ja kes on jäänud. Nii moodustame õppimisvalimi.
- Koolitame mudelit ajaloo pealt, mille saime punktis 4.
- Valikuline: kordame protseduuri, asendades punktis 1 toodud mudeli punktis 5 saadud mudeliga.
A/Б-testimise kaudu saab kontrollida sellise hoidmise kvaliteeti — jagame potentsiaalselt lahkuvad kliendid kaheks rühmaks. Ühele pakume tooteid meie hoidmisemudeli põhjal, teisele ei paku me midagi. Otsustasime koolitada mudelit, mis võiks kasu tuua juba meie näite punktis 1.
Soovisime, et segmenteerimine oleks maksimaalselt tõlgendatav. Seetõttu valisime mõned omadused, mida oleks lihtne tõlgendada: tehingute koguarv, palk, konto koguvool, vanus, sugu. „Kaardid“ tabelist ei võetud omadusi arvesse, kuna need on vähe informatiivsed, ja „Lepingud“ tabelist omadused — komplitseeritud töötlemise tõttu, et vältida andmete lekkeid valideerimisja kohaliku vältimise vahel.
Klastri loomine toimus Gaussiani segamudelite abil. Akaike teavet kriteerium aitas määrata 2 optimaalset lahendust. Esimene optimaalse lahendus vastab 1 klastrile. Teine, vähem väljendunud, vastab 80 klastrile. Selle tulemuse põhjal võib teha järgmise järelduse: andmeid on äärmiselt keeruline jagada klastriteks ilma eeloleva teabeta. Kvaliteetseks klasterdamiseks on vajalikud andmed, mis kirjeldavad iga kliendi üksikasjalikult.
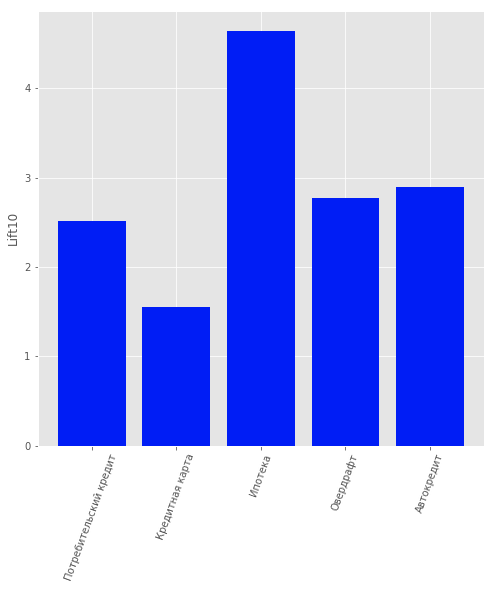
Seetõttu vaadati üle juhendatud õppe ülesanne, et pakkuda igale kliendile tema toodet. Arvesse võeti järgmised tooted: „Tähtajaline hoiustus“, „Krediitkaart“, „Ülekatte võimalus“, „Tarbijalaen“, „Autolaen“, „Hüpokateka“.
Andmetes oli veel üks toote tüüp: „Jooksev konto“. Kuid me ei vaadanud seda väikese informatiivsuse tõttu. Panga klientide seas, kes pole lõpetanud tema toodete kasutamist, ehitati mudel, mis ennustab, milline toode võiks neid huvitada. Mudeliks valiti logistiline regressioon ning kvaliteedi hindamiseks kasutati Lift väärtust esimese 10 protsentiili jaoks.
Mudeli kvaliteeti saab hinnata jooniselt.
Toodete soovituste mudeli tulemused klientidele
Kokkuvõte
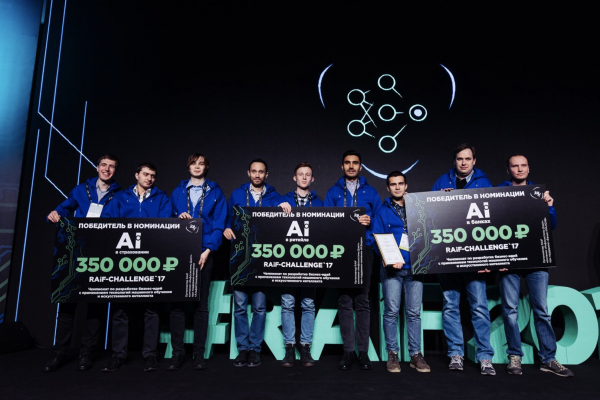
See lähenemine tõi meile esikoha „AI panganduses“ nominatsioonis 2017. aasta RAIF-Challenge tehisintellekti võistlusel.
Tundub, et peamine oli siiski probleemile läheneda mitte kõige tavalisemalt ja kasutada meetodit, mida tavaliselt kasutatakse teistes olukordades.
Kuigi massiline kasutajate väljavool võib olla teenustele tõeline looduskatastroof.
Seda meetodit saab rakendada ka igas muus valdkonnas, kus on oluline arvestada kasutajate väljavoolu, mitte ainult pankade puhul. Näiteks kasutasime seda ka meie enda väljavoolu arvutamiseks - Siberi ja Peterburi Rossotelecomi filiaalides.
„Intelligentse andmeanalüüsi labor“ ettevõte „Otsinguportaal „Sputnik“
Allikas: habr.com
