

KDB+، محصول شرکت یک پایگاه داده ستونی و بسیار سریع در دایره های باریک شناخته شده است که برای ذخیره سری های زمانی و محاسبات تحلیلی بر اساس آنها طراحی شده است. در ابتدا، در صنعت مالی بسیار محبوب بود (و هست) - همه 10 بانک سرمایه گذاری برتر و بسیاری از صندوق های تامینی معروف، صرافی ها و سایر سازمان ها از آن استفاده می کنند. اخیراً، KX تصمیم گرفت پایگاه مشتریان خود را گسترش دهد و اکنون راهحلهایی را در حوزههای دیگری ارائه میکند که در آن حجم زیادی داده وجود دارد، سازماندهی شده بر اساس زمان یا موارد دیگر - مخابرات، بیوانفورماتیک، تولید و غیره. آنها همچنین شریک تیم مسابقهای استون مارتین ردبول در فرمول 1 شدند، جایی که به جمعآوری و پردازش دادهها از حسگرهای خودرو و تجزیه و تحلیل تستهای تونل باد کمک میکنند. در این مقاله میخواهم به شما بگویم که چه ویژگیهای KDB+ باعث عملکرد فوقالعاده آن میشود، چرا شرکتها حاضرند پول زیادی برای آن خرج کنند و در نهایت، چرا واقعاً یک پایگاه داده نیست.
در این مقاله سعی می کنم به طور کلی به شما بگویم KDB+ چیست، چه قابلیت ها و محدودیت هایی دارد و چه مزایایی برای شرکت هایی دارد که می خواهند حجم زیادی از داده ها را پردازش کنند. من وارد جزئیات پیاده سازی KDB+ یا جزئیات زبان برنامه نویسی Q آن نمی شوم. اطلاعات زیادی در مورد این موضوعات را می توان در code.kx.com یافت، از جمله کتابی در مورد Q - Q For Mortals (به لینک زیر مراجعه کنید).
برخی اصطلاحات
- پایگاه داده درون حافظه پایگاه داده ای که داده ها را برای دسترسی سریعتر در RAM ذخیره می کند. مزایای چنین پایگاه داده ای مشخص است، اما معایب آن امکان از بین رفتن اطلاعات و نیاز به حافظه زیاد روی سرور است.
- پایگاه داده ستونی پایگاه داده ای که در آن داده ها به جای ثبت بر اساس رکورد، ستون به ستون ذخیره می شوند. مزیت اصلی چنین پایگاه داده ای این است که داده های یک ستون با هم روی دیسک و حافظه ذخیره می شوند که دسترسی به آن را به میزان قابل توجهی افزایش می دهد. نیازی به بارگذاری ستون هایی که در پرس و جو استفاده نمی شوند وجود ندارد. عیب اصلی این است که تغییر و حذف رکوردها دشوار است.
- سری زمانی. داده ها با ستون تاریخ یا زمان. به طور معمول، ترتیب زمانی برای چنین دادههایی مهم است، به طوری که میتوانید به راحتی تعیین کنید کدام رکورد قبل یا بعد از رکورد فعلی است، یا توابعی را اعمال کنید که نتایج آنها به ترتیب رکوردها بستگی دارد. پایگاه های داده کلاسیک بر اساس یک اصل کاملا متفاوت ساخته شده اند - مجموعه ای از رکوردها را به عنوان یک مجموعه نشان می دهد، که در آن ترتیب رکوردها، در اصل، تعریف نشده است.
- بردار. در زمینه KDB+، این لیستی از عناصر از همان نوع اتمی است، به عنوان مثال، اعداد. به عبارت دیگر، آرایه ای از عناصر. آرایه ها، برخلاف لیست ها، می توانند به صورت فشرده ذخیره شوند و با استفاده از دستورالعمل های پردازنده برداری پردازش شوند.
اطلاعات تاریخی
KX در سال 1993 توسط آرتور ویتنی، که قبلاً در بانک مورگان استنلی بر روی زبان A+ کار می کرد، تأسیس شد، جانشین APL - یک زبان بسیار اصلی و زمانی محبوب در دنیای مالی. البته در KX، آرتور با همین روحیه ادامه داد و با هدایت ایده های مینیمالیسم رادیکال، زبان عملکردی- برداری K را ایجاد کرد. برنامههای K مانند ترکیبی از نشانهها و کاراکترهای خاص به نظر میرسند، معنای علائم و توابع به زمینه بستگی دارد، و هر عملیات معنای بسیار بیشتری نسبت به زبانهای برنامهنویسی معمولی دارد. به همین دلیل، یک برنامه K فضای کمتری را اشغال می کند - چند خط می تواند جایگزین صفحات متن در یک زبان پرمخاطب مانند جاوا شود - و یک پیاده سازی فوق متمرکز از الگوریتم است.
تابعی در K که بیشتر مولد تجزیه کننده LL1 را طبق دستور زبان مشخصی پیاده سازی می کند:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/:1_r),"]";""]]}
آرتور این فلسفه راندمان شدید را با حداقل حرکات بدن در KDB+ تجسم داد که در سال 2003 ظاهر شد (فکر میکنم اکنون مشخص است که حرف K در نام از کجا آمده است) و چیزی بیش از مفسر نسخه چهارم K نیست. زبان یک نسخه کاربرپسندتر در بالای K K به نام Q اضافه شده است. Q همچنین پشتیبانی از یک گویش خاص از SQL - QSQL، و مفسر - پشتیبانی از جداول به عنوان نوع داده سیستم، ابزارهایی برای کار با جداول اضافه شده است. در حافظه و روی دیسک و غیره
بنابراین از دیدگاه کاربر، KDB+ به سادگی یک مفسر زبان Q با پشتیبانی از جداول و عبارات سبک LINQ SQL از سی شارپ است. این مهمترین تفاوت بین KDB+ و سایر پایگاه های داده و مزیت رقابتی اصلی آن است که اغلب نادیده گرفته می شود. این یک پایگاه داده + زبان کمکی غیرفعال نیست، بلکه یک زبان برنامه نویسی قدرتمند تمام عیار + پشتیبانی داخلی برای عملکردهای پایگاه داده است. این تمایز نقش تعیین کننده ای در فهرست کردن تمام مزایای KDB+ خواهد داشت. مثلا…
اندازه
با استانداردهای مدرن، KDB+ به سادگی از نظر اندازه میکروسکوپی است. این به معنای واقعی کلمه یک فایل اجرایی زیر مگابایتی و یک فایل متنی کوچک با برخی عملکردهای سیستم است. در واقع - کمتر از یک مگابایت، و برای این برنامه شرکت ها ده ها هزار دلار در سال برای یک پردازنده روی سرور می پردازند.
- این اندازه به KDB+ اجازه می دهد تا در هر سخت افزاری احساس خوبی داشته باشد - از میکرو کامپیوتر Pi گرفته تا سرورهایی با ترابایت حافظه. این به هیچ وجه بر عملکرد تأثیر نمی گذارد، علاوه بر این، Q بلافاصله شروع می شود، که به آن اجازه می دهد از جمله به عنوان یک زبان برنامه نویسی استفاده شود.
- در این اندازه، مفسر Q به طور کامل در حافظه نهان پردازنده قرار می گیرد که اجرای برنامه را سرعت می بخشد.
- با این حجم از فایل اجرایی، فرآیند Q فضای ناچیزی در حافظه اشغال می کند؛ شما می توانید صدها مورد از آنها را اجرا کنید. علاوه بر این، در صورت لزوم، Q می تواند با ده ها یا صدها گیگابایت حافظه در یک فرآیند واحد کار کند.
تطبیق پذیری
Q برای طیف گسترده ای از برنامه ها عالی است. فرآیند Q می تواند به عنوان یک پایگاه داده تاریخی عمل کند و دسترسی سریع به ترابایت اطلاعات را فراهم کند. به عنوان مثال، ما ده ها پایگاه داده تاریخی داریم که در برخی از آنها یک روز فشرده نشده بیش از 100 گیگابایت داده می شود. با این حال، تحت محدودیت های معقول، یک پرس و جو در پایگاه داده در ده ها تا صدها میلی ثانیه تکمیل می شود. به طور کلی، ما یک مهلت زمانی جهانی برای درخواست های کاربر داریم - 30 ثانیه - و بسیار به ندرت کار می کند.
Q به همین راحتی می تواند یک پایگاه داده در حافظه باشد. داده های جدید به قدری سریع به جداول درون حافظه اضافه می شوند که درخواست های کاربر عامل محدود کننده هستند. داده ها در جداول در ستون ها ذخیره می شوند، به این معنی که هر عملیاتی بر روی یک ستون از حافظه پنهان پردازنده با ظرفیت کامل استفاده می کند. علاوه بر این، KX سعی کرد تمام عملیات های اساسی مانند حساب را از طریق دستورالعمل های برداری پردازنده پیاده سازی کند و سرعت آنها را به حداکثر برساند. Q همچنین می تواند کارهایی را انجام دهد که برای پایگاه های داده معمولی نیستند - به عنوان مثال، داده های جریانی را پردازش کرده و در "زمان واقعی" (با تاخیر از ده ها میلی ثانیه تا چند ثانیه بسته به وظیفه) توابع مختلف تجمیع ابزارهای مالی را برای زمان های مختلف محاسبه کند. فواصل زمانی ایجاد کنید یا مدلی از تأثیر معاملات بی نقص در بازار بسازید و پروفایل آن را تقریباً بلافاصله پس از تکمیل آن انجام دهید. در چنین کارهایی، اغلب تاخیر زمانی اصلی Q نیست، بلکه نیاز به همگام سازی داده ها از منابع مختلف است. سرعت بالا به این دلیل حاصل می شود که داده ها و توابعی که آنها را پردازش می کنند در یک فرآیند هستند و پردازش به اجرای چندین عبارت QSQL و اتصالات کاهش می یابد که تفسیر نمی شوند، اما توسط کد باینری اجرا می شوند.
در نهایت، می توانید هر فرآیند سرویس را در Q بنویسید. به عنوان مثال، Gateway پردازش می کند که به طور خودکار درخواست های کاربر را در پایگاه های داده و سرورهای لازم توزیع می کند. برنامه نویس آزادی کاملی برای پیاده سازی هر الگوریتمی برای تعادل، اولویت بندی، تحمل خطا، حقوق دسترسی، سهمیه ها و اساساً هر چیز دیگری دارد که دلش می خواهد. مشکل اصلی اینجاست که باید همه اینها را خودتان پیاده کنید.
به عنوان مثال، من انواع فرآیندهای ما را لیست می کنم. همه آنها به طور فعال مورد استفاده قرار می گیرند و با هم کار می کنند، ده ها پایگاه داده مختلف را در یک پایگاه داده ترکیب می کنند، داده ها را از چندین منبع پردازش می کنند و به صدها کاربر و برنامه خدمات ارائه می دهند.
- اتصال دهنده (feedhandler) به منابع داده. این فرآیندها معمولاً از کتابخانه های خارجی استفاده می کنند که در Q بارگذاری می شوند. رابط C در Q بسیار ساده است و به شما اجازه می دهد تا به راحتی توابع پروکسی را برای هر کتابخانه C/C++ ایجاد کنید. Q به اندازهای سریع است که بهعنوان مثال، پردازش سیل پیامهای FIX از تمام بورسهای اروپایی را بهطور همزمان پردازش میکند.
- توزیع کنندگان داده (نقطه دار)، که به عنوان یک پیوند میانی بین اتصال دهنده ها و مصرف کنندگان عمل می کنند. در همان زمان، آنها داده های دریافتی را در یک گزارش باینری ویژه می نویسند و برای مصرف کنندگان در برابر قطع شدن اتصال یا راه اندازی مجدد استحکام می بخشند.
- پایگاه داده در حافظه (rdb). این پایگاه های داده با ذخیره سازی در حافظه، سریع ترین دسترسی ممکن را به داده های خام و تازه فراهم می کنند. به طور معمول، آنها داده ها را در طول روز در جداول جمع می کنند و در شب آنها را بازنشانی می کنند.
- پایگاه داده ماندگار (PDB). این پایگاههای اطلاعاتی تضمین میکنند که دادههای امروزی در یک پایگاه داده تاریخی ذخیره میشوند. به عنوان یک قاعده، بر خلاف rdb، آنها داده ها را در حافظه ذخیره نمی کنند، اما از یک کش مخصوص روی دیسک در طول روز استفاده می کنند و داده ها را در نیمه شب در پایگاه داده تاریخی کپی می کنند.
- پایگاه های اطلاعاتی تاریخی (hdb). این پایگاه داده ها امکان دسترسی به داده های روزها، ماه ها و سال های گذشته را فراهم می کند. اندازه آنها (در روز) فقط با اندازه هارد دیسک ها محدود می شود. داده ها را می توان در هر جایی قرار داد، به ویژه در دیسک های مختلف برای افزایش سرعت دسترسی. فشرده سازی داده ها با استفاده از چندین الگوریتم برای انتخاب امکان پذیر است. ساختار پایگاه داده به خوبی مستند و ساده است، داده ها ستون به ستون در فایل های معمولی ذخیره می شوند، بنابراین می توان آنها را پردازش کرد، از جمله با استفاده از سیستم عامل.
- پایگاه های داده با اطلاعات جمع آوری شده آنها مجموعه های مختلفی را ذخیره می کنند، معمولاً با نام ابزار و فاصله زمانی گروه بندی شده اند. پایگاه های داده درون حافظه با هر پیام دریافتی وضعیت خود را به روز می کنند و پایگاه های داده تاریخی داده های از پیش محاسبه شده را برای سرعت بخشیدن به دسترسی به داده های تاریخی ذخیره می کنند.
- در نهایت، فرآیندهای دروازهسرویس دهی به اپلیکیشن ها و کاربران Q به شما امکان می دهد پردازش کاملا ناهمزمان پیام های دریافتی، توزیع آنها در پایگاه های داده، بررسی حقوق دسترسی و غیره را اجرا کنید. توجه داشته باشید که پیامها محدود نیستند و اغلب عبارتهای SQL نیستند، همانطور که در سایر پایگاههای داده وجود دارد. بیشتر اوقات ، عبارت SQL در یک تابع خاص پنهان می شود و بر اساس پارامترهای درخواستی کاربر ساخته می شود - زمان تبدیل می شود ، فیلتر می شود ، داده ها عادی می شوند (به عنوان مثال ، در صورت پرداخت سود سهام قیمت سهام برابر می شود) و غیره.
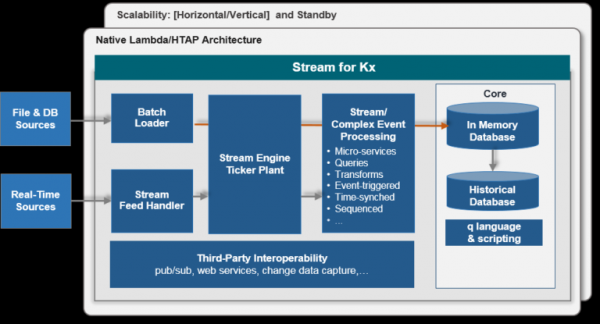
معماری معمولی برای یک نوع داده:
سرعت
اگرچه Q یک زبان تفسیری است، اما یک زبان برداری نیز هست. این بدان معناست که بسیاری از توابع داخلی، به ویژه توابع حسابی، آرگومانهایی را به هر شکلی میگیرند - اعداد، بردارها، ماتریسها، فهرستها - و از برنامهنویس انتظار میرود که برنامه را به عنوان عملیات آرایه پیادهسازی کند. در چنین زبانی، اگر دو بردار از یک میلیون عنصر را اضافه کنید، دیگر اهمیتی ندارد که زبان تفسیر شود؛ جمع توسط یک تابع باینری فوق بهینه شده انجام می شود. از آنجایی که بخش عمده زمان در برنامه های Q صرف عملیات با جداولی می شود که از این توابع بردار اساسی استفاده می کنند، خروجی سرعت عملیاتی بسیار مناسبی دارد و به ما امکان می دهد حجم عظیمی از داده ها را حتی در یک فرآیند پردازش کنیم. این شبیه به کتابخانه های ریاضی در پایتون است - اگرچه پایتون زبان بسیار کندی است، اما کتابخانه های بسیار خوبی دارد مانند numpy که به شما امکان می دهد داده های عددی را با سرعت یک زبان کامپایل شده پردازش کنید (به هر حال، numpy از نظر ایدئولوژیکی به Q نزدیک است. ).
علاوه بر این، KX رویکرد بسیار دقیقی را برای طراحی جداول و بهینه سازی کار با آنها در نظر گرفت. در مرحله اول، چندین نوع شاخص پشتیبانی می شوند که توسط توابع داخلی پشتیبانی می شوند و می توانند نه تنها در ستون های جدول، بلکه برای هر بردار - گروه بندی، مرتب سازی، ویژگی منحصر به فرد و گروه بندی ویژه برای پایگاه های داده تاریخی اعمال شوند. این شاخص به سادگی اعمال می شود و هنگام افزودن عناصر به ستون/بردار به طور خودکار تنظیم می شود. ایندکس ها می توانند با موفقیت به ستون های جدول هم در حافظه و هم روی دیسک اعمال شوند. هنگام اجرای یک کوئری QSQL، در صورت امکان از ایندکس ها به صورت خودکار استفاده می شود. در مرحله دوم، کار با داده های تاریخی از طریق مکانیسم نمایش فایل های سیستم عامل (نقشه حافظه) انجام می شود. جداول بزرگ هرگز در حافظه بارگذاری نمی شوند، در عوض، ستون های لازم مستقیماً در حافظه نگاشت می شوند و تنها بخشی از آنها در واقع بارگذاری می شود (نمایه ها نیز در اینجا کمک می کنند) که مورد نیاز است. برای برنامه نویس فرقی نمی کند که داده ها در حافظه باشند یا نه؛ مکانیسم کار با mmap کاملاً در اعماق Q پنهان است.
KDB+ یک پایگاه داده رابطهای نیست؛ جداول میتوانند حاوی دادههای دلخواه باشند، در حالی که ترتیب ردیفها در جدول زمانی که عناصر جدید اضافه میشوند تغییر نمیکند و میتوان و باید هنگام نوشتن پرسوجوها از آنها استفاده کرد. این ویژگی برای کار با سریهای زمانی (دادههای مبادلات، تلهمتری، گزارشهای رویداد) ضروری است، زیرا اگر دادهها بر اساس زمان مرتب شوند، کاربر نیازی به استفاده از هیچ ترفند SQL برای یافتن اولین یا آخرین ردیف یا N ندارد. ردیف های جدول، تعیین کنید که کدام خط از خط N ام پیروی می کند و غیره. پیوستن به جدول حتی بیشتر سادهتر میشود، برای مثال، یافتن آخرین نقلقول برای 16000 تراکنش VOD.L (Vodafone) در جدولی با 500 میلیون عنصر حدود یک ثانیه روی دیسک و دهها میلیثانیه در حافظه زمان میبرد.
نمونه ای از پیوستن زمانی - جدول نقل قول به حافظه نگاشت شده است، بنابراین نیازی به تعیین VOD.L نیست که در آن، شاخص در ستون sym و این واقعیت که داده ها بر اساس زمان مرتب شده اند به طور ضمنی استفاده می شود. تقریباً همه اتصالات در Q توابع منظم هستند، نه بخشی از یک عبارت انتخابی:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
در نهایت، شایان ذکر است که مهندسان KX، که از خود آرتور ویتنی شروع میکنند، واقعاً به کارایی وسواس دارند و تمام تلاش خود را میکنند تا از ویژگیهای استاندارد Q حداکثر استفاده را ببرند و رایجترین الگوهای استفاده را بهینه کنند.
مجموع
KDB+ عمدتاً به دلیل تطبیق پذیری استثنایی آن در بین مشاغل محبوب است - به همان اندازه به عنوان یک پایگاه داده در حافظه، به عنوان پایگاه داده برای ذخیره ترابایت داده های تاریخی و به عنوان بستری برای تجزیه و تحلیل داده ها عمل می کند. با توجه به اینکه پردازش داده ها به طور مستقیم در پایگاه داده انجام می شود، سرعت کار بالا و صرفه جویی در منابع حاصل می شود. یک زبان برنامه نویسی کامل که با توابع پایگاه داده یکپارچه شده است به شما امکان می دهد کل پشته فرآیندهای لازم را در یک پلت فرم - از دریافت داده ها تا پردازش درخواست های کاربر - پیاده سازی کنید.
برای اطلاعات بیشتر،
محدودیت ها
یک نقطه ضعف قابل توجه KDB+/Q آستانه ورود بالا است. زبان نحو عجیبی دارد، برخی از توابع به شدت بارگذاری شده اند (مثلاً مقدار حدود 11 مورد استفاده دارد). مهمتر از همه، این نیاز به یک رویکرد کاملاً متفاوت برای نوشتن برنامه دارد. در یک زبان برداری، شما باید همیشه بر حسب تبدیل آرایه فکر کنید، همه حلقهها را از طریق چندین نوع توابع نقشه/کاهش (که در Q قید نامیده میشوند) پیادهسازی کنید و هرگز سعی نکنید با جایگزین کردن عملیات بردار با عملیات اتمی، در هزینه خود صرفهجویی کنید. به عنوان مثال، برای یافتن اندیس وقوع N ام یک عنصر در یک آرایه، باید بنویسید:
1. (where element=vector)[N]
اگرچه این به نظر می رسد بسیار ناکارآمد با استانداردهای C/Java (= یک بردار بولی ایجاد می کند، جایی که شاخص های واقعی عناصر موجود در آن را برمی گرداند). اما این نماد معنای عبارت را واضح تر می کند و شما به جای عملیات اتمی آهسته از عملیات برداری سریع استفاده می کنید. تفاوت مفهومی بین یک زبان برداری و سایر زبان ها با تفاوت بین رویکردهای ضروری و کاربردی در برنامه نویسی قابل مقایسه است و شما باید برای این کار آماده باشید.
برخی از کاربران نیز از QSQL ناراضی هستند. نکته این است که فقط شبیه SQL واقعی است. در واقع، این فقط یک مفسر عبارات SQL مانند است که از بهینه سازی پرس و جو پشتیبانی نمی کند. کاربر باید کوئری های بهینه را خودش بنویسد و در Q بنویسد که خیلی ها آماده نیستند. از طرف دیگر، البته، همیشه می توانید به جای اتکا به یک بهینه ساز جعبه سیاه، کوئری بهینه را خودتان بنویسید.
به عنوان مزیت، کتابی در مورد Q - Q For Mortals به صورت رایگان در دسترس است ، همچنین بسیاری از مواد مفید دیگر در آنجا جمع آوری شده است.
یکی دیگر از معایب بزرگ هزینه مجوز است. این ده ها هزار دلار در سال برای هر CPU است. فقط شرکت های بزرگ می توانند از عهده چنین هزینه هایی برآیند. اخیراً، KX خطمشی صدور مجوز خود را انعطافپذیرتر کرده است و فرصت پرداخت تنها برای زمان استفاده یا اجاره KDB+ را در ابرهای Google و Amazon فراهم میکند. KX نیز برای دانلود ارائه می دهد (نسخه 32 بیتی یا 64 بیتی در صورت درخواست).
رقبا
تعداد کمی پایگاه داده تخصصی وجود دارد که بر اساس اصول مشابه ساخته شده اند - ستونی، در حافظه، متمرکز بر مقادیر بسیار زیادی از داده ها. مشکل اینجاست که اینها پایگاه های داده تخصصی هستند. یک مثال بارز کلیک هاوس است. این پایگاه داده یک اصل بسیار شبیه به KDB+ برای ذخیره داده ها بر روی دیسک و ایجاد یک نمایه دارد؛ برخی از پرس و جوها را سریعتر از KDB+ انجام می دهد، البته نه به میزان قابل توجهی. اما حتی به عنوان یک پایگاه داده، Clickhouse تخصصی تر از KDB+ - تجزیه و تحلیل وب در مقابل سری های زمانی دلخواه است (این تفاوت بسیار مهم است - به دلیل آن، برای مثال، در Clickhouse امکان استفاده از ترتیب رکوردها وجود ندارد). اما مهمتر از همه، Clickhouse تطبیق پذیری KDB+ را ندارد، زبانی که به جای بارگیری آن ها در یک برنامه جداگانه، ایجاد عبارات SQL دلخواه، اعمال توابع دلخواه در یک پرس و جو، ایجاد فرآیندها، امکان پردازش مستقیم داده ها را در پایگاه داده را فراهم می کند. مربوط به اجرای توابع پایگاه داده تاریخی نیست. بنابراین، مقایسه KDB+ با سایر پایگاههای داده دشوار است؛ آنها ممکن است در موارد استفاده خاص بهتر باشند یا به سادگی در مورد وظایف پایگاه داده کلاسیک بهتر باشند، اما من ابزاری به همان اندازه مؤثر و همه کاره دیگر برای پردازش دادههای موقت نمیشناسم.
ادغام پایتون
برای آسانتر کردن استفاده از KDB+ برای افرادی که با این فناوری آشنا نیستند، KX کتابخانههایی را برای ادغام محکم با پایتون در یک فرآیند واحد ایجاد کرد. می توانید هر تابع پایتون را از Q فراخوانی کنید، یا برعکس - هر تابع Q را از پایتون (به ویژه عبارات QSQL) فراخوانی کنید. کتابخانه ها، در صورت لزوم (نه همیشه به خاطر کارایی)، داده ها را از قالب یک زبان به قالب زبان دیگر تبدیل می کنند. در نتیجه، Q و Python در یک همزیستی نزدیک زندگی می کنند که مرزهای بین آنها محو می شود. در نتیجه، برنامه نویس از یک طرف به کتابخانه های مفید متعدد پایتون دسترسی کامل دارد، از سوی دیگر، یک پایگاه سریع برای کار با داده های بزرگ ادغام شده در پایتون دریافت می کند، که به ویژه برای کسانی که در یادگیری ماشین فعالیت می کنند مفید است. یا مدلینگ
کار با Q در پایتون:
1. >>> q()
2.q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
مراجع
سایت شرکت -
وب سایت برای توسعه دهندگان -
کتاب Q For Mortals (به زبان انگلیسی) -
مقالات مربوط به برنامه های KDB+/Q از کارکنان kx -
منبع: www.habr.com
