

برخی از شرکت ها، از جمله مشتری ما، محصول را از طریق یک شبکه شریک توسعه می دهند. به عنوان مثال، فروشگاه های آنلاین بزرگ با خدمات تحویل یکپارچه شده اند - شما یک محصول را سفارش می دهید و به زودی یک شماره پیگیری برای بسته دریافت می کنید. مثال دیگر زمانی است که همراه با بلیط هواپیما بیمه یا بلیط Aeroexpress خریداری می کنید.
برای این کار از یک API استفاده می شود که باید از طریق API Gateway برای شرکا صادر شود. ما این مشکل را حل کرده ایم. در این مقاله جزئیات را به شما خواهیم گفت.
داده شده: یک اکوسیستم و یک پورتال API با یک رابط که در آن کاربران ثبت نام، اطلاعات دریافت می کنند و غیره. ما باید یک API Gateway راحت و قابل اعتماد بسازیم. در این فرآیند، ما نیاز به ارائه داشتیم
- ثبت،
- کنترل اتصال API،
- نظارت بر نحوه استفاده کاربران از سیستم نهایی،
- حسابداری برای شاخص های کسب و کار
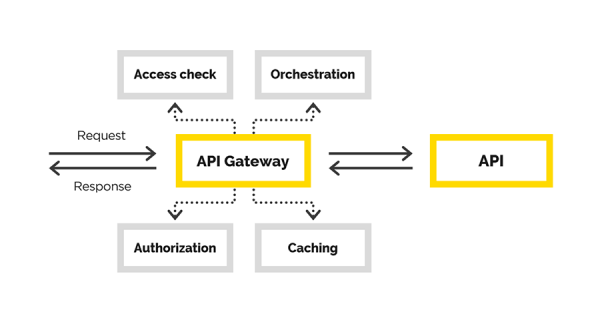
در این مقاله در مورد تجربه خود در ایجاد دروازه API صحبت خواهیم کرد که طی آن وظایف زیر را حل کردیم:
- احراز هویت کاربر،
- مجوز کاربر،
- اصلاح درخواست اصلی،
- درخواست پروکسی،
- پس پردازش پاسخ
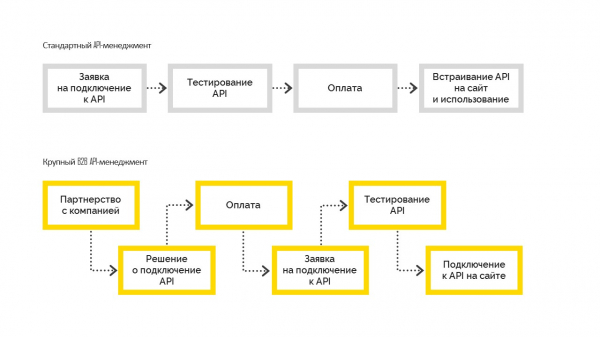
دو نوع مدیریت API وجود دارد:
1. استاندارد که به شرح زیر عمل می کند. قبل از اتصال، کاربر ویژگی ها را آزمایش می کند، سپس پرداخت می کند و در سایت خود جاسازی می کند. اغلب آنها در مشاغل کوچک و متوسط استفاده می شوند.
2. مدیریت API B2B بزرگ، زمانی که شرکت ابتدا تصمیم تجاری برای اتصال می گیرد، با تعهد قراردادی شریک شرکت می شود و سپس به API متصل می شود. و پس از انجام تمام تشریفات، شرکت دسترسی آزمایشی را دریافت می کند، تست را پشت سر می گذارد و وارد تولید می شود. اما این بدون تصمیم مدیریت برای اتصال امکان پذیر نیست.
راه حل ما
در این قسمت در مورد ایجاد یک API Gateway صحبت خواهیم کرد.
کاربران نهایی دروازه API ایجاد شده شرکای مشتری ما هستند. ما در حال حاضر برای هر یک از آنها قراردادهای لازم را داریم. ما فقط باید با علامت گذاری دسترسی داده شده به دروازه، عملکرد را گسترش دهیم. بر این اساس، یک اتصال کنترل شده و فرآیند مدیریت مورد نیاز است.
البته میتوان راهحل آمادهای برای حل مشکل مدیریت API و بهویژه ایجاد یک API Gateway در نظر گرفت. به عنوان مثال، این می تواند باشد. این برای ما مناسب نبود، زیرا در مورد ما قبلاً یک پورتال API و یک اکوسیستم عظیم در اطراف آن ساخته شده بودیم. همه کاربران قبلاً ثبت نام کرده اند، آنها قبلاً فهمیده اند که از کجا و چگونه می توانند اطلاعات لازم را دریافت کنند. رابط های لازم از قبل در پورتال API وجود داشت، ما فقط به دروازه API نیاز داشتیم. در واقع، ما در حال توسعه آن هستیم.
چیزی که ما به آن API Gateway می گوییم نوعی پروکسی است. در اینجا ما دوباره یک انتخاب داشتیم - می توانید پروکسی خود را بنویسید یا می توانید چیزی آماده را انتخاب کنید. در این صورت راه دوم را رفتیم و باندل nginx + Lua را انتخاب کردیم. چرا؟ ما به نرم افزار قابل اعتماد و آزمایش شده ای نیاز داشتیم که از مقیاس بندی پشتیبانی کند. بعد از پیاده سازی، نمی خواستیم هم صحت منطق تجاری و هم درستی پروکسی را بررسی کنیم.
هر وب سرور یک خط لوله پردازش درخواست دارد. در مورد nginx، به این صورت است:
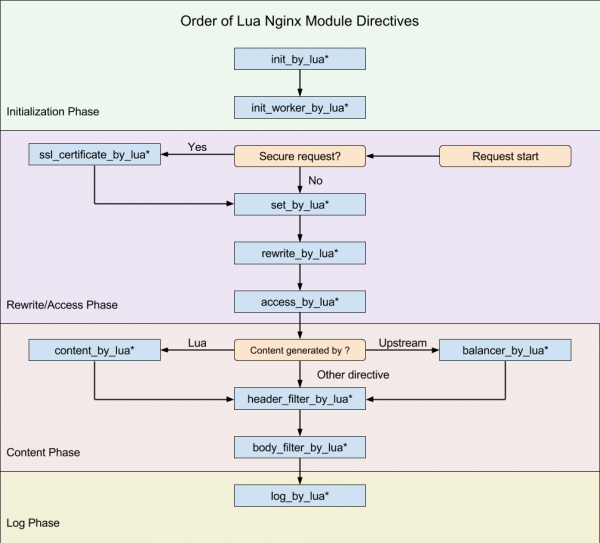
(نمودار از )
هدف ما این بود که در این خط لوله در نقطه ای قرار بگیریم که بتوانیم درخواست اصلی را تغییر دهیم.
ما می خواهیم یک پروکسی شفاف ایجاد کنیم تا درخواست از نظر عملکردی همان چیزی باشد که آمده است. ما فقط دسترسی به API نهایی را کنترل می کنیم، به درخواست کمک می کنیم تا به آن برسد. اگر درخواست نادرست بود، API نهایی باید خطا را نشان دهد، اما نه ما. تنها دلیلی که می توانیم درخواست را رد کنیم این است که مشتری دسترسی ندارد.
از قبل برای nginx وجود دارد بر . Lua یک زبان برنامه نویسی است، بسیار سبک وزن و یادگیری آن آسان است. بنابراین، منطق لازم را با استفاده از Lua پیاده سازی کردیم.
پیکربندی nginx (مشابهی با مسیر برنامه) که در آن همه کار انجام می شود، کاملاً قابل درک است. نکته قابل توجه در اینجا آخرین دستورالعمل - post_action است.
location /middleware {
      more_clear_input_headers Accept-Encoding;
      lua_need_request_body on;
      rewrite_by_lua_file 'middleware/rewrite.lua';
      access_by_lua_file 'middleware/access.lua';
      proxy_pass https://someurl.com;
      body_filter_by_lua_file 'middleware/body_filter.lua';
      post_action /process_session;
}
در نظر بگیرید که در این پیکربندی چه اتفاقی می افتد:
more_clear_input_headers - مقدار هدرهای مشخص شده بعد از دستورالعمل را پاک می کند.
lua_need_request_body - کنترل می کند که آیا بدنه درخواست اصلی باید قبل از اجرای دستورالعمل های rewrite/access/access_by_lua خوانده شود یا خیر. بهطور پیشفرض، nginx متن درخواست کلاینت را نمیخواند، و اگر نیاز به دسترسی به آن دارید، این دستورالعمل باید روی روشن تنظیم شود.
rewrite_by_lua_file - مسیر اسکریپت که منطق تغییر درخواست را توضیح می دهد
access_by_lua_file - مسیر اسکریپت، که منطقی را که دسترسی به منبع را بررسی می کند، توصیف می کند.
پروکسی_گذر - آدرس اینترنتی که درخواست به آن پروکسی می شود.
body_filter_by_lua_file - مسیر اسکریپت، که منطق فیلتر کردن درخواست را قبل از بازگرداندن آن به مشتری توضیح می دهد.
و در نهایت، post_action - یک دستورالعمل رسمی غیرمستند که با آن می توانید برخی از اقدامات دیگر را پس از ارائه پاسخ به مشتری انجام دهید.
در ادامه به ترتیب نحوه حل مشکلات خود را شرح خواهیم داد.
مجوز/احراز هویت و درخواست اصلاح
اجازه
ما مجوز و احراز هویت را با استفاده از دسترسی گواهی ایجاد کردیم. گواهی ریشه وجود دارد. هر کلاینت جدید مشتری گواهی شخصی خود را تولید می کند که با آن می تواند به API دسترسی داشته باشد. این گواهی در قسمت سرور تنظیمات nginx پیکربندی شده است.
ssl on;
ssl_certificate /usr/local/openresty/nginx/ssl/cert.pem;
ssl_certificate_key /usr/local/openresty/nginx/ssl/cert.pem;
ssl_client_certificate /usr/local/openresty/nginx/ssl/ca.crt;
ssl_verify_client on;
اصلاح
ممکن است یک سوال منصفانه پیش بیاید: اگر به طور ناگهانی بخواهیم آن را از سیستم جدا کنیم با یک مشتری تأیید شده چه کنیم؟ گواهینامه ها را برای همه مشتریان دیگر دوباره صادر نکنید.
بنابراین ما به آرامی به کار بعدی نزدیک شدیم - تغییر درخواست اصلی. درخواست اولیه مشتری، به طور کلی، برای سیستم نهایی معتبر نیست. یکی از کارها این است که قسمت های گم شده را به درخواست اضافه کنید تا معتبر شود. نکته این است که داده های از دست رفته برای هر مشتری متفاوت است. ما می دانیم که یک کلاینت با یک گواهی به ما می آید که می توانیم از آن اثر انگشت گرفته و داده های مشتری لازم را از پایگاه داده استخراج کنیم.
اگر در مقطعی نیاز به قطع ارتباط مشتری از سرویس ما داشته باشید، داده های او از پایگاه داده ناپدید می شوند و او نمی تواند کاری انجام دهد.
کار با داده های مشتری
ما باید راه حل را بسیار در دسترس قرار می دادیم، به خصوص اینکه چگونه داده های مشتری را به دست می آوریم. مشکل این است که منبع اصلی این داده ها یک سرویس شخص ثالث است که سرعت بدون وقفه و به اندازه کافی بالا را تضمین نمی کند.
بنابراین، ما نیاز به اطمینان از در دسترس بودن بالای داده های مشتری داشتیم. به عنوان یک ابزار، ما انتخاب کرده ایم که در اختیار ما قرار می دهد:
- دسترسی سریع به داده ها
- توانایی سازماندهی یک خوشه از چندین گره با داده های تکرار شده در گره های مختلف.
ما با ساده ترین استراتژی برای تحویل داده ها به حافظه پنهان پیش رفتیم:
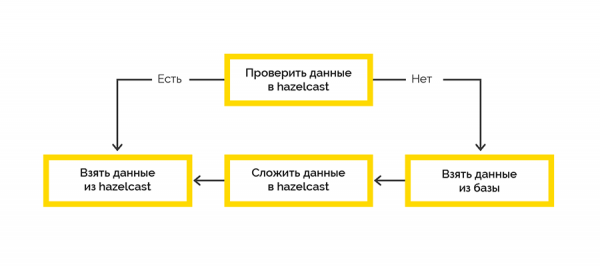
کار با سیستم نهایی در جلسات انجام می شود و حداکثر تعداد محدودیت وجود دارد. اگر مشتری جلسه را نبسته باشد، باید این کار را انجام دهیم.
دادههای جلسه باز از سیستم پایانی میآیند و در ابتدا در سمت Lua پردازش میشوند. ما تصمیم گرفتیم از Hazelcast برای ذخیره این داده ها با یک کار دات نت استفاده کنیم. سپس در فواصل زمانی، حق حیات جلسات باز را بررسی کرده و پوسیده ها را می بندیم.
دسترسی به Hazelcast از Lua و .NET
هیچ مشتری Lua برای کار با Hazelcast وجود ندارد، اما Hazelcast یک REST API دارد که ما تصمیم گرفتیم از آن استفاده کنیم. برای دات نت وجود دارد ، که از طریق آن قصد داشتیم به داده های Hazelcast در سمت دات نت دسترسی داشته باشیم. اما آنجا نبود.
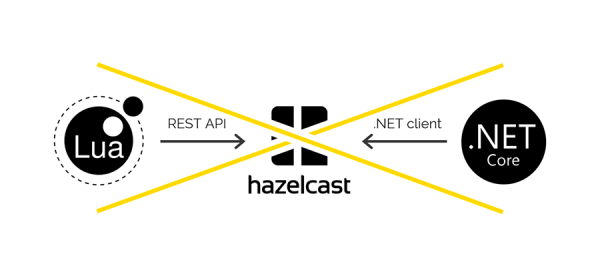
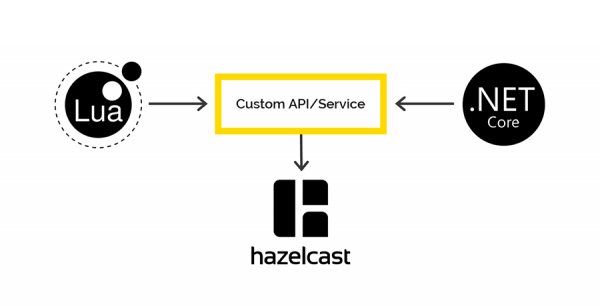
هنگام ذخیره داده ها از طریق REST و بازیابی داده ها از طریق یک کلاینت دات نت، از سریال سازها و deserializers های مختلف استفاده می شود. بنابراین، نمی توان داده ها را از طریق REST قرار داد، اما آن را از طریق کلاینت دات نت دریافت کرد و بالعکس.
اگر علاقه مندی وجود دارد، در مقاله ای جداگانه بیشتر در مورد این مشکل به شما خواهیم گفت. اسپویلر - بر روی شماتیک.
ثبت و نظارت
استاندارد شرکتی ما برای ورود از طریق دات نت Serilog است، همه لاگ ها به Elasticsearch ختم می شوند و ما آنها را از طریق Kibana تجزیه و تحلیل می کنیم. من دوست دارم در این مورد کاری مشابه انجام دهم. تنها برای کار با Elastic در Lua، که پیدا شد، در اولین نیاز شکست خورد. و ما از فلوئنتد استفاده کردیم.
- راه حل منبع باز برای ارائه یک لایه لاگ برنامه. به شما امکان میدهد گزارشها را از لایههای مختلف برنامه جمعآوری کنید و سپس آنها را در یک منبع واحد پخش کنید.
API Gateway در K8S کار میکند، بنابراین ما تصمیم گرفتیم یک کانتینر با fluentd در همان pody اضافه کنیم تا گزارشها را به پورت tcp باز موجود fluentd بنویسیم.
ما همچنین بررسی کردیم که اگر ارتباطی با Elasticsearch نداشته باشد چگونه روان رفتار می کند. به مدت دو روز، درخواست ها به طور مداوم به گیت وی ارسال می شد، لاگ ها به fluentd ارسال می شد، اما fluentd از IP Elastic منع شد. پس از بازیابی اتصال، fluentd کاملاً از تمام سیاهههای مربوط به Elastic سبقت گرفت.
نتیجه
رویکرد انتخاب شده برای پیاده سازی به ما این امکان را می دهد که فقط در 2.5 ماه یک محصول واقعاً کارآمد را به محیط جنگ تحویل دهیم.
اگر روزی چنین کارهایی را انجام دادید، به شما توصیه می کنیم قبل از هر چیز به وضوح متوجه شوید که چه مشکلی را حل می کنید و چه منابعی را در اختیار دارید. از پیچیدگی های یکپارچه سازی با سیستم های مدیریت API موجود آگاه باشید.
خودتان درک کنید که دقیقاً چه چیزی را می خواهید توسعه دهید - فقط منطق تجاری برای پردازش درخواست ها، یا، همانطور که در مورد ما ممکن است، کل پروکسی باشد. فراموش نکنید که هر کاری که خودتان انجام می دهید باید بعداً کاملاً آزمایش شود.
منبع: www.habr.com
