

Salut, Habr ! Chez Dodo Pizza Engineering, nous adorons les données (et qui ne les aime pas de nos jours ?). Voici l'histoire de la façon de rassembler toutes les données du monde Dodo Pizza et de donner à chaque employé de l'entreprise un accès facile à cet ensemble de données. La mission est de garder notre équipe Data Engineering sereine.
Comme de vrais accumulators, nous rassemblons toutes sortes d'informations sur le fonctionnement de nos pizzerias :
- nous nous souvenons de toutes les commandes des utilisateurs ;
- nous savons combien de temps il a fallu pour préparer la première pizza à Syktyvkar ;
- nous voyons combien de temps une pizza refroidit sur l'étagère chauffante à Voronej en ce moment même ;
- nous conservons des données sur l'élimination des produits ;
- et bien plus encore.
Plusieurs équipes sont actuellement responsables de la gestion des données chez Dodo Pizza, l'une d'elles étant l'équipe Data Engineering. Aujourd'hui, nous avons la tâche de donner à chaque employé de l'entreprise un accès facile à cet ensemble de données.
Lorsque nous avons commencé à réfléchir à la façon de procéder et à discuter de la tâche, nous avons trouvé une approche très intéressante de la gestion des données : (lien vers un article magnifique et complet). Ses idées correspondent très bien à notre vision de la manière dont nous souhaitons construire notre système. La suite de l'article présentera notre réinterprétation de l'approche et comment nous envisageons son déploiement chez Dodo Pizza Engineering.
Que voulons-nous dire par « données »
Tout d'abord, clarifions ce que nous entendons par données chez Dodo Pizza Engineering :
- Les événements envoyés par les services (nous avons un bus commun construit avec RabbitMQ) ;
- Les enregistrements dans la base de données (pour nous, c'est MySQL et CosmosDB) ;
- Le Clickstream de l'application mobile et du site Web.
Pour que l'entreprise Dodo Pizza puisse utiliser ces données et s'y fier, il est crucial que les conditions suivantes soient remplies :
- Elles doivent être intègres. Nous devons nous assurer de ne pas modifier les données pendant leur traitement, stockage et affichage. Si l'entreprise ne peut pas faire confiance à nos données, elles n'ont aucune utilité.
- Elles doivent être horodatées et ne pas être écrasées. Cela signifie qu'à tout moment, nous voulons avoir la possibilité de revenir en arrière et de consulter les données de cette période. Par exemple, savoir combien de pizzas ont été vendues le 8 juillet 2018.
- Elles doivent être fiables. Dans le processus de collecte et de stockage des données, nous devons non seulement préserver l'intégrité, mais aussi la fiabilité. Nous ne pouvons pas perdre de données, des tranches temporelles, car avec elles, nous perdons la confiance de nos clients (tant externes qu'internes).
- Ils doivent suivre un schéma stable - nous écrivons des requêtes sur ces données. Nous ne souhaiterions pas qu'avec les modifications du code de l'application et le refactoring, elles changent au point que nos requêtes cessent de fonctionner. Celui qui écrit les requêtes ne saura jamais que vous avez fait un refactoring tant que tout ne s'écroule pas. Nous ne voulons pas l'apprendre par nos clients.
Compte tenu de toutes ces exigences, nous avons conclu que les données chez Dodo sont un produit. Comme une API publique du service. Par conséquent, l'équipe qui possède les données devrait être la même que celle qui possède le service. De plus, les modifications du schéma de données doivent toujours être rétrocompatibles.
Approche traditionnelle - Data Lake
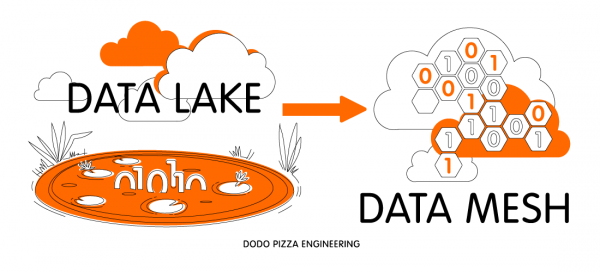
Pour résoudre les défis de stockage et de traitement fiables des grandes données, il existe une approche traditionnelle adoptée par de nombreuses entreprises manipulant une telle quantité d'informations - le Data Lake. Dans le cadre de cette approche, les ingénieurs de données collectent les informations de tous les composants du système et les stockent dans un grand entrepôt (cela peut être, par exemple, Hadoop, Azure Kusto, Apache Cassandra ou même une réplique MySQL, si les données peuvent y être intégrées).
Ensuite, ces mêmes ingénieurs écrivent des requêtes pour cet entrepôt. La mise en œuvre de cette approche dans Dodo Pizza Engineering implique que l'équipe de Data Engineering gère le schéma des données dans l'entrepôt analytique.
Dans ce scénario, l'équipe devient très triste et voici pourquoi :
- Elle doit surveiller les changements dans TOUS les services de l'entreprise. Et il y en a beaucoup, avec de nombreux changements (en moyenne, nous fusionnons environ 100 pull requests par semaine, tandis que beaucoup de services ne font pas de pull requests du tout).
- Lors de la modification du schéma de données, le product owner et l'équipe qui change le schéma de données doivent attendre que Data Engineering termine le code nécessaire pour que les modifications soient supportées. De plus, il y a longtemps que nous avons des fonctionnalités et la situation où une équipe attend l'autre est très rare. Et nous ne voulons pas que cela devienne une partie « normale » du processus de développement.
- Elle doit être immergée dans TOUT Une entreprise de pizzerias. Cela peut sembler être une activité simple, mais en réalité, c'est tout le contraire. Il est très difficile de rassembler dans une même équipe suffisamment de compétences pour construire un modèle de données adéquat pour l'ensemble de l'entreprise.
- Elle constitue un point de défaillance unique. Chaque fois qu'il est nécessaire de modifier les données renvoyées par le service ou d'écrire une requête, toutes ces tâches incombent à l'équipe Data Engineering. Au final, l'équipe se retrouve avec un backlog surchargé.
Cela signifie que l'équipe est à l'intersection d'un grand nombre de besoins et il est peu probable qu'elle puisse tous les satisfaire. De plus, elle se trouvera constamment sous pression et stress. Nous ne souhaitons pas cela. Il est donc essentiel de réfléchir à des solutions à ces problèmes tout en obtenant la capacité d'analyser les données.
En passant du Data Lake au Data Mesh
Heureusement, cette question ne se posait pas seulement pour nous. En réalité, un tel problème a déjà été résolu dans l'industrie (alléluia !). Mais dans un autre domaine : le déploiement d'applications. Oui, je parle de l'approche DevOps, où l'équipe détermine comment déployer le produit qu'elle crée.
Une approche similaire pour résoudre les problèmes liés au Data Lake a été proposée par Zhamak Dehghani, consultante chez ThoughtWorks. En observant comment des entreprises comme Netflix et Spotify abordent de telles questions, elle a rédigé un article fascinant (le lien vers celui-ci était au début de l'article). Les principales idées que nous en avons tirées :
- Diviser un grand Data Lake en domaines de données, qui ressemblent beaucoup aux domaines de la conception pilotée par le domaine (domain-driven design). Chaque domaine est un petit contexte borné.
- Les Feature Teams responsables des domaines DDD sont également en charge des domaines de données correspondants. Elles conservent le schéma, y apportent des modifications, y chargent des données. De plus, elles sont parfaitement conscientes de la manière de modifier le chargement des données sans rien casser lorsque l'application évolue. Les connaissances restent au sein de l'équipe. Pour accéder aux données, elles n'ont pas besoin de se rendre ailleurs. L'équipe gère l'intégralité du cycle de développement, des modifications des données opérationnelles à la fourniture de données analytiques à des tiers. Une équipe détient la propriété de tout ce qui est lié au domaine (tant le domaine commercial que le domaine des données).
- Data Engineer – un rôle au sein de la Feature Team. Ce n'est pas nécessairement une personne distincte, mais il est impératif que l'équipe possède cette compétence.
Et pendant ce temps, l'équipe Data Engineering...
Si l'on imagine que tout cela se réalise d'un simple claquement de doigts, il reste à répondre à deux questions :
Que va faire l'équipe Data Engineering maintenant ? Dans Dodo Pizza Engineering, il existe déjà une équipe plateforme/SRE. Sa mission est de fournir aux développeurs des outils pour un déploiement facile des services. L'équipe Data Engineering jouera le même rôle, mais pour les données.
Transformer des données opérationnelles en données analytiques est un processus complexe. Rendre les données analytiques accessibles à l'ensemble de l'entreprise est encore plus difficile. C'est précisément ces problèmes que l'équipe Data Engineering s'attachera à résoudre.
Nous avons l'intention de fournir à l'équipe Feature une série d'outils et de pratiques qui leur permettront de publier des données de leur service pour le reste de l'entreprise. Nous serons également responsables des parties communes de l'infrastructure du pipeline de données (files d'attente, stockage fiable, clusters pour effectuer des transformations sur les données).
Comment les compétences de Data Engineer apparaîtront-elles au sein de l'équipe Feature ? Avec l'équipe Feature, c'est plus compliqué. Bien sûr, nous pourrions essayer d'embaucher un Data Engineer dans chacune de nos équipes. Mais c'est très difficile. Trouver quelqu'un avec un bon arrière-plan en traitement des données et le convaincre de travailler au sein des équipes produits est un vrai défi.
Un grand avantage de Dodo est que nous aimons la formation interne. Ainsi, notre plan est le suivant : l'équipe Data Engineering commence à publier des données de certains services, pleurant, se piquant, mais continue à manger le cactus. Dès que nous comprendrons que nous avons un processus prêt pour la publication, nous commencerons à en parler à l'équipe Feature.
Nous avons plusieurs façons de procéder :
- , où nous expliquerons à quoi ressemble le processus que nous avons créé, quels outils existent et comment les utiliser le plus efficacement possible.
- Une présentation au DevForum nous aidera à recueillir des retours des développeurs produits. Après cela, nous pourrons nous joindre aux équipes produits et les aider à résoudre des problèmes de publication de données, organiser des formations pour les équipes.
Consommation des données
J'ai beaucoup parlé de la publication de données. Mais il y a aussi la consommation. Qu'en est-il de ce sujet ?
Nous avons une équipe BI fantastique qui rédige des rapports très complexes pour la société de gestion. À l'intérieur de Dodo IS, il y a de nombreux rapports pour nos partenaires qui les aident à gérer les pizzérias. Dans notre nouveau modèle, nous les considérons comme des consommateurs de données ayant leurs propres domaines de données. Et ce sont bien les consommateurs qui seront responsables de leurs propres domaines. Parfois, le domaine d'un consommateur peut être décrit par une seule requête dans l'entrepôt analytique – et c'est bien. Mais nous comprenons que cela ne fonctionnera pas toujours. C'est pourquoi nous voulons que la plateforme que nous créerons pour les équipes produit puisse également être utilisée par les consommateurs de données (car pour les rapports à l'intérieur de Dodo IS, cela concernera les mêmes équipes).
C'est ainsi que nous voyons le travail avec les données chez Dodo Pizza Engineering. Nous serions ravis de lire vos pensées à ce sujet dans les commentaires.
Source : habr.com
