

A funkcionális függőségek keresése az adatok elemzésének különböző területein alkalmazható: adatbázis-kezelés, adatgyűjtés, adatbázisok visszafejtése és adatfeltárás. Magukról a függőségekről már publikáltunk. Anasztázia Birillo és Nyikita Bobrov. Ezúttal Anasztázia — a Computer Science Center idei végzőse — osztja meg ennek a munkának a fejlődését a NIR keretein belül, amelyet a központban védett.
A feladat kiválasztása
A CS központban végzett tanulmányom alatt mélyebben kezdtem el foglalkozni az adatbázisokkal, nevezetesen a funkcionális és különböző függőségek keresésével. Ez a téma kapcsolódott a főiskolai dolgozatom témájához, így a dolgozatom írása során elkezdtem cikkeket olvasni az adatbázisokban található különböző függőségekről. Írtam egy összefoglalót erről a területről — az egyik első írásom angol nyelven, és benyújtottam a SEIM-2017 konferenciára. Nagyon örültem, amikor megtudtam, hogy elfogadták, és úgy döntöttem, hogy mélyebben belemerülök a témába. Maga a koncepció nem új — a '90-es évek óta alkalmazzák, de manapság is sok területen hasznosítják.
A központban eltöltött második félévben tudományos kutatási projektbe kezdtem a funkcionális függőségek keresési algoritmusainak javítására. Ezen dolgoztam Szentpétervári Állami Egyetem PhD hallgatójával, Nyikita Bobrovval, a JetBrains Research keretein belül.
A funkcionális függőségek keresésének számítási nehézsége
A fő probléma a számítási nehézség. A lehetséges minimális és nem trivális függőségek száma fentről a következő értékkel korlátozott  , ahol
 — a táblázat attribútumainak száma. Az algoritmusok futási ideje nemcsak az attribútumok számától, hanem a sorok számától is függ. A '90-es években a funkcionális függőségek keresésére használt algoritmusok egy hagyományos asztali számítógépen akár 20 attribútumot és több tízezer sort tartalmazó adathalmokat dolgozhattak fel, akár több órán keresztül. A modern algoritmusok, amelyek többmagos processzorokon működnek, függőségeket fedeznek fel olyan adathalmazon, amely akár 200 attribútumból és számos százezer sorból áll, körülbelül ugyanannyi idő alatt. Ennek ellenére ez nem elegendő: ez az idő a legtöbb valós alkalmazás számára elfogadhatatlan. Ezért megoldásokat dolgoztunk ki a meglévő algoritmusok felgyorsítására.
Partíciós kereszteződéshez készült cache-elési séma
A munka első részében kifejlesztettük a cache-elési sémákat az algoritmusok osztályához, amelyek a partíciók metódusát alkalmazzák. A partíció egy attribútum számára egy listákból álló halmazt jelent, ahol minden lista azonos értékekkel rendelkező sorok számait tartalmazza az adott attribútum esetében. Minden ilyen listát klaszternek nevezünk. Sok modern algoritmus használ partíciókat annak meghatározásához, hogy a függőség fennmarad-e vagy sem, és követi azt a lemmát: A függőség  fennmarad, ha
 . Itt a partíciót jelöljük, és használjuk a partíció mérete fogalmát – a benne lévő klaszterek számát. Azok az algoritmusok, amelyek partíciókat használnak, ha a függőség megsértésre kerül, további attribútumokat adnak a függőség bal oldalához, majd újraszámolják azt, végrehajtva a partíciók metszése műveletét. Ezt a műveletet az irodalomban specializációnak nevezik. De észrevettük, hogy a függőségekhez tartozó partíciók, amelyek csak néhány kört követően fognak fennmaradni, aktívan újrahasználhatók, ami jelentősen csökkentheti az algoritmusok futási idejét, mivel a művelet költséges.
 Ezért javasoltuk egy heurisztikát, amely Shannon entrópiáján és Ginny bizonytalanságán, valamint a mi metrikánkon alapul, amelyet Visszafelé Entrópiának neveztünk el. Ez egy csekély mértékben módosított Shannon entrópia, és nő, ahogy a adatállomány egyediség növekszik. A javasolt heurisztika a következőképpen néz ki:
— a nemrégiben kiszámolt partíció egyedülállóságának foka

Itt  — a nemrégiben kiszámított partíció egyediségének foka
 , és
 a medián szintje az egyedi attribútumok esetében. Az egyediség mérésére az összes három, korábban említett mutatót kipróbálták. Megjegyzendő, hogy a heurisztikában két módosító is van. Az első megmutatja, mennyire közel áll az aktuális partíció az elsődleges kulcshoz, és lehetővé teszi, hogy nagyobb mértékben gyorsítótárazza azokat a partíciókat, amelyek távol vannak a potenciális kulcstól. A második módosító lehetővé teszi a gyorsítótár foglaltságának nyomon követését, ezáltal ösztönözve a további partíciók gyorsítótárba helyezését, amikor még van szabad hely. E feladat sikeres megoldása 10-40%-kal gyorsította fel a PYRO algoritmust, az adathalmazonként változó mértékben. Érdemes megjegyezni, hogy a PYRO algoritmus a területen a legjobban teljesítő.
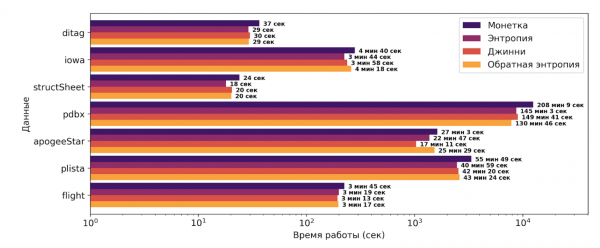
Az alábbi ábrán látható a javasolt heurisztika alkalmazásának eredménye a véletlenszerű mintavételezésen alapuló alapvető megközelítéssel összehasonlítva. Az X tengely logaritmikus.
Alternatív partíciótárolási módszer
Ezután alternatív partíciótárolási módot javasoltunk. A partíciók klaszterek halmazaként működnek, melyekben az azonos attribútumokkal rendelkező tuple-ök számát tárolják. Ezek a klaszterek hosszú tuple számokat tartalmazhatnak, például ha a táblázat adatai rendezettek. Ezért javasoltunk egy tömörítési sémát a partíciók tárolására, nevezetesen az attribútumok klasztereiben lévő értékek intervallumos tárolását:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Első~intervallum}, underbrace{7, 8}_{Második~intervallum}, 10}}\ downarrow{Tömörítés}\ pi(X) = {{underbrace{$, 1, 5}_{Első~intervallum}, underbrace{7, 8}_{Második~intervallum}, 10}}$$display$$
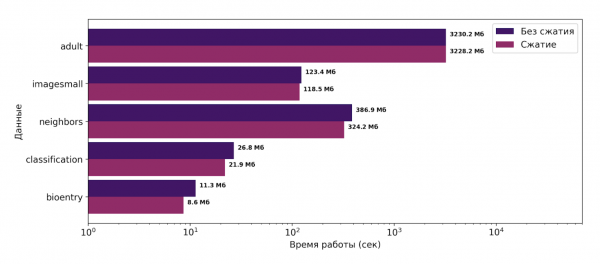
Ez a módszer 1-25% közötti memóriafogyasztás-csökkenést tudott elérni a TANE algoritmus végrehajtása során. A TANE algoritmus egy klasszikus algoritmus a funkcionális függőségek keresésére, amely partíciókat használ a működése során. A gyakorlat során éppen a TANE algoritmust választották, mivel az intervallumos tárolás bevezetése sokkal egyszerűbb volt, mint például a PYRO esetében, hogy felmérjük, működik-e a javasolt megközelítés. Az elért eredmények az alábbi ábrán láthatók. Az X tengely logaritmikus.
ADBIS-2019 konferencia
A 2019 szeptemberi kutatás eredményei alapján egy cikket mutattam be a 23. Európai Adatbázisok és Információs Rendszerek Konferenciáján (ADBIS-2019) bemutatott munka során Bernhard Thalheim, a adatbázisok területének kiemelkedő alakja méltatta a munkát. A kutatási eredmények képezték az alapját a Példány Mesterképzésemhez a SPbGU matematikai és mechanikai karán, ahol mindkét javasolt megközelítést (gyorsítótár-kezelés és tömörítés) beépítettem a TANE és PYRO algoritmusokba. Az eredmények azt mutatták, hogy a javasolt megoldások univerzálisak, mivel mindkét algoritmus esetében jelentős memória-csökkentést és a működési idő jelentős csökkenését figyeltük meg.
Forrás: habr.com
