

Každý hovorí o procesoch vývoja a testovania, školení zamestnancov a zvýšenej motivácii, ale tieto procesy sú nedostatočné, keď minúta výpadku služby stojí premrštené sumy peňazí. Čo by ste mali robiť, keď spracovávate finančné transakcie v rámci prísnej SLA? Ako môžete zlepšiť spoľahlivosť a odolnosť svojich systémov bez zohľadnenia vývoja a testovania?
Ďalšia konferencia HighLoad++ sa bude konať 6. a 7. apríla 2020 v Petrohrade. Podrobnosti a vstupenky sú k dispozícii na 9. novembra, 18:00. HighLoad++ Moskva 2018, Dillí + sála v Kalkate. Abstrakty a .
Evgeny Kuzovlev (ďalej len EK): Ahojte priatelia! Volám sa Evgeny Kuzovlev. Som z EcommPay, konkrétne z EcommPay IT, IT divízie skupiny spoločností. Dnes sa budeme baviť o prestojoch – ako sa im vyhnúť a ako minimalizovať ich následky, ak sa im vyhnúť nedá. Téma znie: „Čo robiť, keď minúta prestoja stojí 100 000 dolárov?“ Do budúcnosti sú naše čísla porovnateľné.
Čo robí EcommPay IT?
Kto sme? Prečo tu stojím pred vami? Prečo mám právo vám tu čokoľvek hovoriť? A o čom tu budeme podrobnejšie diskutovať?
Skupina spoločností EcommPay je medzinárodný acquirer. Spracovávame platby po celom svete – v Rusku, Európe a juhovýchodnej Ázii (ďalej len „All Around the World“). Máme deväť kancelárií a celkovo 500 zamestnancov, z ktorých približne polovica sú IT špecialisti. Všetko, čo robíme, všetko, na čom zarábame peniaze, sme si urobili sami.
Všetky naše produkty sme si napísali sami (a máme ich pomerne dosť – naša rada rozsiahlych IT produktov obsahuje približne 16 rôznych komponentov); píšeme ich sami, vyvíjame ich sami. A v súčasnosti spracovávame približne milión transakcií denne (myslím, že milióny je to správne slovo). Sme relatívne mladá spoločnosť – máme len asi šesť rokov.
Pred šiestimi rokmi to bol startup, kde prišla skupina chalanov s podnikaním. Spojil ich nápad (nič iné, len nápad, nebolo) a my sme sa rozbehli. Ako každý startup, bežali sme rýchlejšie... Rýchlosť bola pre nás dôležitejšia ako kvalita.
V určitom bode sme sa zastavili: uvedomili sme si, že už nedokážeme udržať súčasnú rýchlosť a kvalitu a museli sme uprednostniť kvalitu. V tom momente sme sa rozhodli napísať novú platformu, ktorá by bola robustná, škálovateľná a spoľahlivá. Začali sme túto platformu písať (investovať do nej, vyvíjať ju a testovať), ale v určitom bode sme si uvedomili, že vývoj a testovanie nestačia na dosiahnutie novej úrovne kvality služieb.
Vytvárate nový produkt, uvádzate ho do výroby, ale niekde sa stále niečo pokazí. Dnes si povieme, ako dosiahnuť novú úroveň kvality (ako sme to dokázali a aké sú naše skúsenosti) ignorovaním vývoja a testovania; povieme si, čo je k dispozícii prevádzke – čo dokáže sama prevádzka urobiť, čo môže ponúknuť testovaním na ovplyvnenie kvality.
Prestoje. Prikázania vykorisťovania.
Hlavným kameňom, a o čom si dnes vlastne povieme, je prestoj. Je to strašidelné slovo. Ak dôjde k prestoju, je všetko zlé. Ponáhľame sa, aby sme to spustili, administrátori brzdia server – nedajbože, aby nespadol, ako sa hovorí v tej pesničke. O tom si dnes povieme.
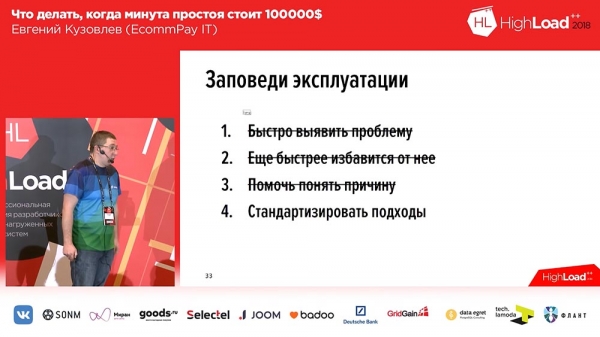
Keď sme začali meniť naše prístupy, vyvinuli sme štyri prikázania. Predstavujem ich na snímkach:
Tieto prikázania sú celkom jednoduché:
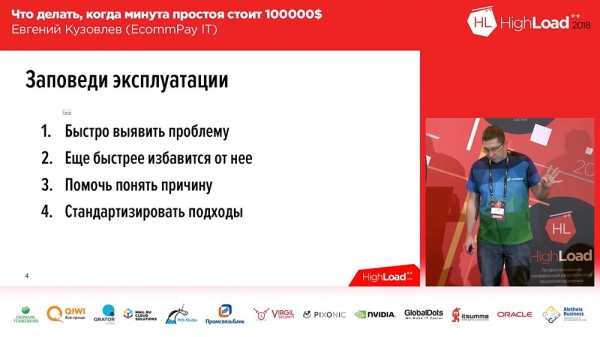
- Rýchlo identifikujte problém.
- Zbavte sa toho ešte rýchlejšie.
- Pomôžte pochopiť dôvod (neskôr, pre vývojárov).
- A štandardizovať prístupy.
Dovoľte mi upriamiť vašu pozornosť na bod č. 2. Problém eliminujeme, nie riešime. Jeho riešenie je druhoradé. Pre nás je primárne, aby bol používateľ pred týmto problémom chránený. Bude existovať v izolovanom prostredí, ale toto prostredie nebude mať s používateľom žiadny kontakt. V skutočnosti si prejdeme tieto štyri skupiny problémov (niektoré podrobnejšie, iné menej) a poviem vám, čo používame a aké máme skúsenosti s ich riešením.
Riešenie problémov: Kedy sa vyskytnú a čo s nimi robiť?
Ale začneme v nepravidelnom poradí. Začneme bodom č. 2: ako sa rýchlo zbaviť problému? Problém existuje – musíme ho vyriešiť. Hlavná otázka je: „Čo s tým urobíme?“. A keď sme začali premýšľať o tom, ako problém vyriešiť, vytvorili sme si pre seba určité požiadavky, ktoré musí riešenie problémov spĺňať.
Aby sme sformulovali tieto požiadavky, rozhodli sme sa položiť si otázku: „Kedy máme problémy?“ A problémy, ako sa ukázalo, sa vyskytujú v štyroch situáciách:
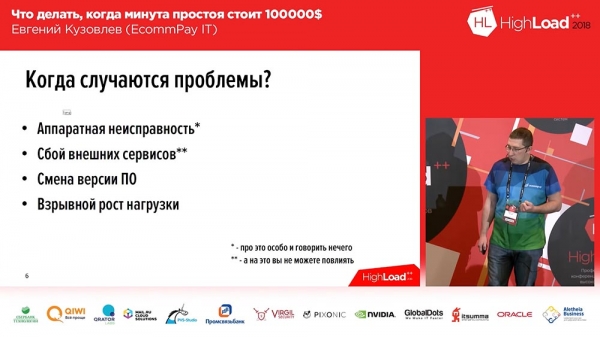
- Porucha hardvéru.
- Zlyhanie externých služieb.
- Zmena verzie softvéru (rovnaké nasadenie).
- Explozívne zvýšenie zaťaženia.
Prvé dve rozoberať nebudeme. Porucha hardvéru sa rieši celkom jednoducho: musíte mať všetko duplikované. Ak ide o disky, mali by byť nakonfigurované v RAID; ak ide o server, mal by byť server duplikovaný; ak máte sieťovú infraštruktúru, mali by ste nainštalovať druhú kópiu sieťovej infraštruktúry – inými slovami, jednoducho všetko duplikujete. A ak niečo zlyhá, prepnete na záložnú kapacitu. Ťažko je o tom povedať viac.
Druhým je zlyhanie externých služieb. Pre väčšinu systémov to vôbec nie je problém, ale pre nás nie. Keďže spracovávame platby, sme agregátorom, ktorý stojí medzi používateľom (ktorý zadáva údaje o svojej karte) a bankami a platobnými systémami (okrem iných Visa, MasterCard a Mira). Naše externé služby (platobné systémy a banky) sú náchylné na zlyhanie. Ani my, ani vy (ak takéto služby máte) to nemôžeme ovplyvniť.
Čo by sme mali potom urobiť? Existujú dve možnosti. Po prvé, ak je to možné, mali by ste túto službu nejako duplikovať. Napríklad, ak je to možné, presmerujeme prevádzku z jednej služby na druhú: napríklad, ak spracovávame karty cez Sberbank a Sberbank má problémy, prevádzku presmerujeme napríklad do Raiffeisen. Druhá vec, ktorú môžeme urobiť, je veľmi rýchlo odhaliť poruchy v externých službách, a preto sa o rýchlosti odozvy budeme venovať v ďalšej časti správy.
V skutočnosti môžeme pomocou týchto štyroch nástrojov konkrétne ovplyvniť zmeny verzií softvéru – podniknúť kroky, ktoré zlepšia situáciu v kontexte nasadenia a v kontexte prudkého rastu záťaže. V skutočnosti sme to urobili. A opäť krátka poznámka…
Z týchto štyroch problémov sa niekoľko okamžite vyrieši, ak máte cloud. Ak používate cloudy Microsoft Azure alebo Ozon, prípadne naše vlastné cloudy, cloudy Yandex alebo Mail.ru, potom sa minimálne ich problémom stane zlyhanie hardvéru a všetko sa pre vás okamžite zlepší, čo sa týka zlyhania hardvéru.
Sme trochu nekonvenčná spoločnosť. Všetci tu hovoria o Kubernetes a cloudoch, ale my nemáme Kubernetes ani cloudy. Máme len hardvérové stojany vo viacerých dátových centrách a sme nútení žiť na tomto hardvéri; sme nútení byť za to všetko zodpovední. Takže, poďme sa porozprávať o problémoch v tejto súvislosti. Prvé dva neprichádzajú do úvahy.
Zmeny verzií softvéru. Základy
Naši vývojári nemajú prístup do produkčného prostredia. Prečo? Sme certifikovaní podľa PCI DSS a naši vývojári jednoducho nemajú právo na prístup do produkčného prostredia. To je všetko, bodka. Rozhodne. Zodpovednosť vývojára preto končí presne v momente vydania zostavy.
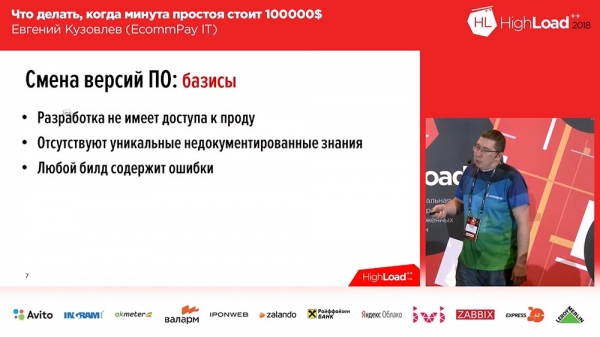
Naším druhým základom, ktorý nám tiež veľmi pomáha, je absencia jedinečných, nezdokumentovaných vedomostí. Dúfam, že ich máte rovnaké. Pretože ak ich nemáte, budete mať problémy. Problémy vznikajú, keď tieto jedinečné, nezdokumentované vedomosti nie sú prítomné na správnom mieste v správnom čase. Povedzme, že máte jednu osobu, ktorá vie, ako nasadiť konkrétny komponent, ale táto osoba tam nie je, je na dovolenke alebo je chorá – to je všetko, máte problémy.
A tretí základ, ku ktorému sme dospeli. Dospeli sme k nemu cez bolesť, krv a slzy – dospeli sme k záveru, že každá zostava, ktorú vytvoríme, obsahuje chyby, aj keď je bezchybná. Rozhodli sme sa takto: keď niečo nasadíme, keď niečo pošleme do produkčného prostredia, máme zostavu s chybami. Definovali sme požiadavky, ktoré musí náš systém spĺňať.
Požiadavky na zmenu verzie softvéru
Existujú tri z týchto požiadaviek:
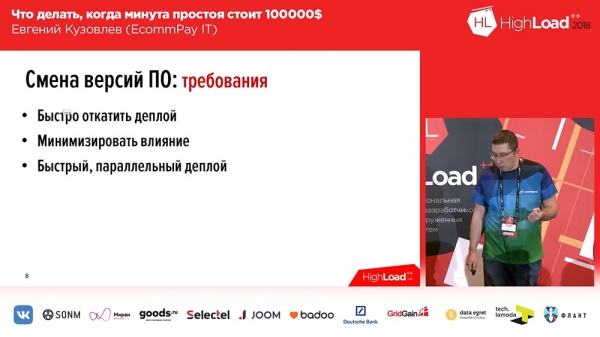
- Musíme rýchlo vrátiť nasadenie späť.
- Musíme minimalizovať dopad neúspešného nasadenia.
- A musíme byť schopní rýchlo nasadiť paralelne.
V tomto poradí! Prečo? Pretože v prvom rade rýchlosť nie je pri nasadzovaní novej verzie dôležitá. Dôležité je, že ak sa niečo pokazí, môžete sa rýchlo vrátiť späť s minimálnym dopadom. Ak však máte sadu produkčných verzií, ktoré sa zrazu ukážu ako obsahujúce chybu (z ničoho nič nebolo vykonané žiadne nasadenie, ale chyba pretrváva), musíte byť schopní rýchlo nasadiť ďalšiu verziu. Čo sme urobili pre splnenie týchto požiadaviek? Použili sme nasledujúcu metodiku:
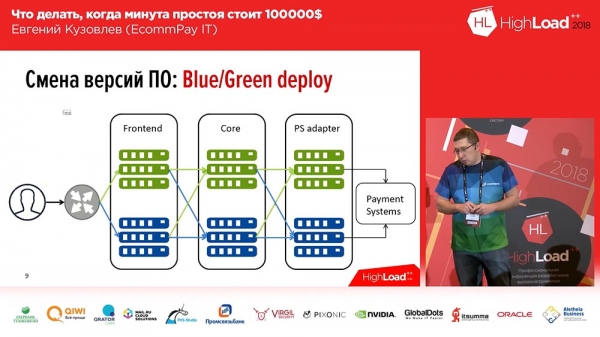
Je to pomerne známe; nevymysleli sme to – volá sa to Blue/Green Deploy. Čo to je? Potrebujete kópiu pre každú skupinu serverov, ktoré hosťujú vaše aplikácie. Táto kópia je „teplá“: neprijíma žiadnu prevádzku, ale túto prevádzku na ňu môžete kedykoľvek presmerovať. Táto kópia obsahuje predchádzajúcu verziu. A počas nasadenia vložíte kód do neaktívnej kópie. Potom prepnete časť (alebo všetku) prevádzku na novú verziu. Preto na zmenu toku prevádzky zo starej verzie na novú stačí vykonať iba jednu akciu: musíte zmeniť vyrovnávač záťaže v upstreame, zmeniť smer – z jedného upstreamu na druhý. Toto je veľmi pohodlné a rieši problém rýchleho prepínania a rýchleho vrátenia zmien.Riešením druhého problému je minimalizácia: na nový riadok, riadok s novým kódom, môžete presmerovať iba časť svojej prevádzky (povedzme 2 %). A tieto 2 % nie sú 100 %! Ak stratíte 100 % svojej prevádzky v dôsledku neúspešného nasadenia, je to desivé; ak stratíte 2 % svojej prevádzky, je to nepríjemné, ale nie desivé. Navyše, používatelia si to pravdepodobne ani nevšimnú, pretože v niektorých prípadoch (nie vo všetkých) bude ten istý používateľ po stlačení klávesu F5 presmerovaný na inú, funkčnú verziu.
Modré/zelené nasadenie. Smerovanie
Nie je to však také jednoduché ako „nasadenie modrej/zelenej“... Všetky naše komponenty možno rozdeliť do troch skupín:
- toto je frontend (platobné stránky, ktoré vidia naši klienti);
- procesorové jadro;
- adaptér pre prácu s platobnými systémami (banky, MasterCard, Visa atď.).
A tu je jeden háčik – háčik spočíva v smerovaní medzi linkami. Ak jednoducho smerujete 100 % prevádzky, tieto problémy nebudete mať. Ak však chcete smerovať 2 %, začnete sa pýtať: „Ako to mám urobiť?“ Najjednoduchším a priamočiarym riešením je nastaviť Round Robin v Nginxe a budete mať 2 % smerovaných doľava a 98 % smerovaných doprava. Ale to nie je vždy tak.
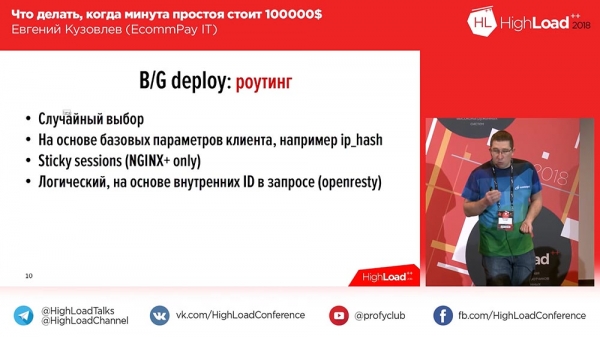
Napríklad v našom prípade používateľ interaguje so systémom s viac ako jednou požiadavkou. To je normálne: 2, 3, 4, 5 požiadaviek – vaše systémy môžu byť podobné. Ak je však pre vás dôležité, aby všetky požiadavky používateľov išli na rovnaký riadok, kde bola prijatá prvá požiadavka, alebo (po druhé), aby všetky požiadavky používateľov išli na nový riadok po prepnutí (mohli začať pracovať so systémom skôr, pred prepnutím), potom toto náhodné rozdelenie pre vás nie je vhodné. V takom prípade sú k dispozícii nasledujúce možnosti:
Prvá možnosť, najjednoduchšia, je založená na základných parametroch klienta (IP Hash). Máte IP adresu a rozdelíte ju zľava a sprava podľa IP adresy. Potom bude fungovať druhý scenár, ktorý som opísal: po nasadení by už používateľ mohol pracovať s vaším systémom a od momentu nasadenia budú všetky požiadavky smerovať na nový riadok (napríklad ten istý).Ak vám to z nejakého dôvodu nevyhovuje a musíte bezpodmienečne posielať požiadavky na linku, kde bola prijatá pôvodná požiadavka používateľa, máte dve možnosti...
Prvá možnosť: môžete použiť platený nginx+. Má mechanizmus Sticky Sessions, ktorý na základe prvej požiadavky používateľa vytvorí pre neho reláciu a naviaže ju na konkrétny upstream. Všetky nasledujúce požiadavky od používateľa počas životnosti relácie budú odoslané na ten istý upstream, na ktorom bola relácia vytvorená.Toto nám nefungovalo, pretože sme už mali bežný Nginx. Prechod na Nginx+ nie je práve drahý, len je trochu bolestivý a nie je pre nás celkom vhodný. Napríklad Sticky Sessions nám nefungoval z jednoduchého dôvodu, že Sticky Sessions neumožňuje smerovanie typu „alebo-alebo“. Môžete určiť, čo má Sticky Sessions robiť, napríklad pomocou IP adresy, pomocou IP adresy a súborov cookie alebo pomocou post-parametra, ale „alebo-alebo“ je zložitejšie.
Takže sme sa dostali k štvrtej možnosti. Použili sme Nginx na steroidoch (tiež známy ako OpenResty) – je to ten istý Nginx, ktorý navyše podporuje last skripty. Môžete napísať last skript, poslať ho do OpenResty a tento last skript sa vykoná, keď príde požiadavka od používateľa.
Takže sme napísali malý skript ako je tento, nastavili sme „openrest“ a v tomto skripte prechádzame šiestimi rôznymi parametrami pomocou zreťazenia „alebo“. V závislosti od prítomnosti konkrétneho parametra vieme, či používateľ pristál na jednej alebo druhej stránke, na jednom alebo druhom riadku.
Modro-zelené nasadenie: Výhody a nevýhody
Samozrejme, mohli by sme to trochu zjednodušiť (napríklad pomocou Sticky Sessions), ale máme aj výhradu, že nie je to len používateľ, ktorý s nami interaguje v kontexte jednej transakcie... Platobné systémy s nami tiež interagujú: po spracovaní transakcie (odoslaním požiadavky do platobného systému) dostaneme spätnú väzbu.
A povedzme, že ak v našom rámci môžeme zahrnúť IP adresu používateľa do všetkých požiadaviek a rozlišovať používateľov na základe tejto IP adresy, nepovieme napríklad spoločnosti Visa: „Chlapi, sme retro spoločnosť, vraj sme medzinárodní (na našej webovej stránke aj v Rusku)... Ale prosím, uveďte IP adresu používateľa v dodatočnom poli, váš protokol je štandardizovaný!“ Je zrejmé, že nebudú súhlasiť.
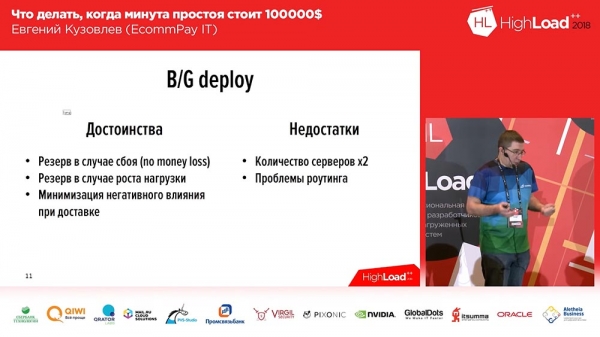
Takže to pre nás nebolo vhodné – zvolili sme openresty. Takže s routovaním sme skončili s týmto:Modro-zelené nasadenie má teda výhody, ktoré som spomenul, aj nevýhody.
Existujú dve nevýhody:
- musíte sa obťažovať s trasovaním;
- Druhou hlavnou nevýhodou sú náklady.
Potrebujete dvakrát toľko serverov, potrebujete dvakrát toľko prevádzkových zdrojov, musíte vynaložiť dvakrát toľko úsilia na údržbu celej tejto zoo.
Mimochodom, jednou z výhod je ďalšia vec, ktorú som ešte nespomenul: máte rezervu pre prípad rastu záťaže. Ak dôjde k náhlemu nárastu záťaže a zahltí sa veľký počet používateľov, jednoducho zahrniete druhý riadok do rozdelenia 50/50 – a okamžite máte v klastri dvojnásobný počet serverov, kým nevyriešite problém s ďalšími servermi.
Ako vykonať rýchle nasadenie?
Diskutovali sme o tom, ako vyriešiť problém minimalizácie a rýchleho vrátenia zmien, ale otázka zostáva: „Ako rýchlo nasadiť?“
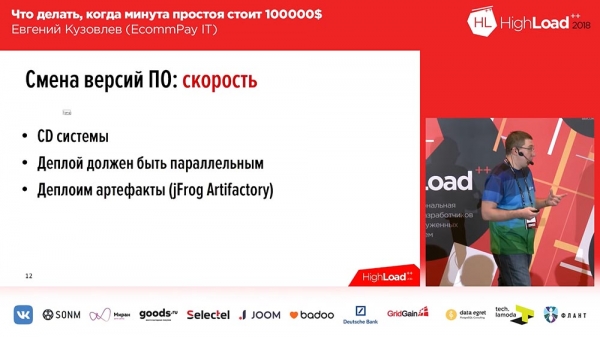
Tu je všetko stručné a jednoduché.- Potrebujete systém CD (Continuous Delivery) – bez neho sa nezaobídete. Ak máte jeden server, môžete ho nasadiť manuálne. Máme približne 1 500 serverov a 1 500 potrebujeme manuálne, takže je jasné, že na nasadenie by sme mohli použiť oddelenie veľkosti tejto miestnosti.
- Nasadenie musí byť paralelné. Ak je vaše nasadenie sekvenčné, je to zlé. Jeden server je v poriadku, ale budete nasadzovať 1 500 serverov celý deň.
- Opäť platí, že kvôli rýchlosti to už pravdepodobne nie je potrebné. Nasadenie zvyčajne zahŕňa zostavenie projektu. Máte webový projekt, frontend (vytvoríte webpack, zostavíte ho pomocou npm alebo niečoho podobného) a tento proces nie je nijako zvlášť dlhý – 5 minút, ale týchto 5 minút môže byť kritických. Preto to napríklad my nerobíme: tých 5 minút sme eliminovali a nasadili sme artefakty.
Čo je artefakt? Artefakt je skompilovaná zostava, v ktorej už boli všetky kroky zostavenia dokončené. Tento artefakt ukladáme do repozitára artefaktov. Používali sme dva takéto repozitáre naraz: Nexus a teraz jFrog Artifactory. Spočiatku sme používali Nexus, pretože sme tento prístup začali praktizovať v Java aplikáciách (bol na to vhodný). Potom sme do toho istého repozitára pridali niekoľko PHP aplikácií; Nexus už nebol vhodný, tak sme zvolili jFrog Artifactory, ktorý dokáže artefaktorizovať takmer čokoľvek. Dokonca sme tento repozitár artefaktov použili na ukladanie vlastných binárnych balíkov, ktoré vytvárame pre naše servery.
Explozívne zvýšenie zaťaženia
Hovorili sme o aktualizácii softvérovej verzie. Ďalšia vec, ktorú máme, je explozívny nárast záťaže. Tu si asi zle vykladám, čo myslím pod pojmom „explozívny nárast záťaže“...
Napísali sme nový systém – je orientovaný na služby, štýlový a krásny. Pracovníci sú všade, fronty sú všade a asynchrónne spracovanie je všade. A v takýchto systémoch môžu dáta prúdiť rôznymi tokmi. Prvá transakcia môže zahŕňať prvého, tretieho alebo desiateho pracovníka, zatiaľ čo druhá transakcia môže zahŕňať druhého, štvrtého alebo piateho. Povedzme teda, že máte ráno tok dát, ktorý zahŕňa prvých troch pracovníkov, ale večer sa zrazu zmení a všetko využíva ostatných troch pracovníkov.
A tu sa ukazuje, že musíte nejako škálovať pracovníkov, musíte nejako škálovať svoje služby, ale zároveň nedovoliť, aby sa zdroje nafúkli.
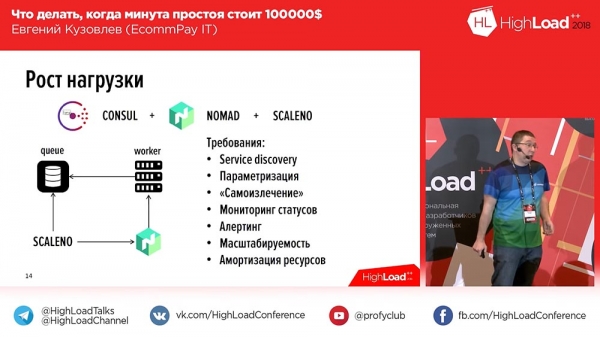
Definovali sme si naše požiadavky. Tieto požiadavky sú pomerne jednoduché: vyhľadávanie služieb, parametrizácia – všetko je štandardné pre budovanie takýchto škálovateľných systémov, okrem jedného bodu: amortizácia zdrojov. Povedali sme, že nie sme pripravení amortizovať zdroje len preto, aby servery udržiavali vzduch teplý. Vybrali sme si Consul a vybrali sme si Nomad, ktorý spravuje našich pracovníkov.Prečo je to pre nás problém? Dovoľte mi trochu sa vrátiť späť. Momentálne máme za sebou približne 70 platobných systémov. Ráno prevádzka prechádza cez Sberbank, potom napríklad Sberbank prestane fungovať a prepneme ju na iný platobný systém. Pred Sberbank sme mali spustených 100 pracovníkov a potom musíme rýchlo zvýšiť počet pracovníkov pre druhý platobný systém. A to všetko by sa ideálne malo diať bez ľudského zásahu. Pretože ak dôjde k ľudskému zásahu, musí byť k dispozícii technik v službe 24 hodín denne, 7 dní v týždni, ktorý je za to výlučne zodpovedný, pretože k týmto výpadkom dochádza pravidelne, keď máte za sebou 70 systémov.
Pozreli sme sa teda na Nomad, ktorý má otvorenú IP adresu, a napísali sme si vlastnú vec, Scale-Nomad – ScaleNo, ktorá robí niečo takéto: monitoruje rast frontu a znižuje alebo zvyšuje počet pracovníkov v závislosti od dynamiky frontu. Keď sme skončili, pomysleli sme si: „Možno by sme to mali sprístupniť ako open source?“ Potom sme sa na to pozreli – je to jednoduché ako facka.
Zatiaľ sme to síce nesprístupnili ako open-source, ale ak si po tejto prezentácii uvedomíte, že niečo také potrebujete a zrazu sa ocitnete v situácii, keď to budete potrebovať, moje kontaktné informácie sú na poslednom slajde – napíšte mi, prosím. Ak sa zapojí aspoň 3 – 5 ľudí, sprístupníme to ako open-source.
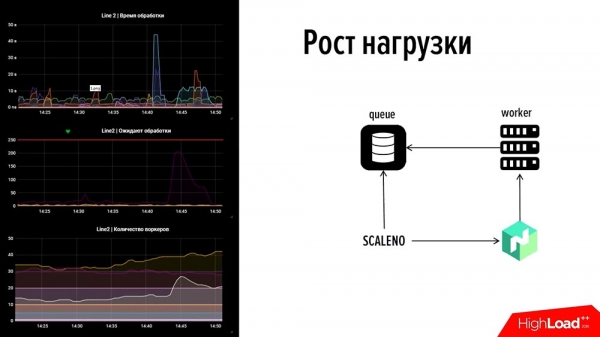
Ako to funguje? Pozrime sa na to! Poskočme dopredu: na ľavej strane je časť nášho monitorovania: je to jeden riadok s časom spracovania udalostí v hornej časti, počtom transakcií v strede a počtom pracovníkov v dolnej časti.Ak sa pozriete pozorne, na tomto obrázku je chyba. V hornom grafe jeden z grafov spadol po 45 sekundách – jeden z platobných systémov spadol. Prevádzka bola tiež pridaná o dve minúty a rad na druhom platobnom systéme, ktorý nemal žiadnych pracovníkov, začal rásť (nevyužívali sme zdroje – v skutočnosti sme ich využívali správne). Nechceli sme ich preťažovať – mali minimálny počet, asi 5 – 10 pracovníkov, ale nedokázali si poradiť.
Posledný graf zobrazuje „hrb“, ktorý naznačuje, že Scaleno toto číslo zdvojnásobil. A potom, keď graf trochu klesol, mierne sa znížil – počet pracovníkov sa automaticky zmenil. Takto to funguje. Diskutovali sme o bode č. 2 – „Ako rýchlo odstrániť príčiny“.
Monitorovanie. Ako rýchlo identifikovať problém?
Prvým bodom je: „Ako môžem rýchlo identifikovať problém?“ Monitorovanie! Musíme rýchlo pochopiť určité veci. Čomu musíme rýchlo porozumieť?
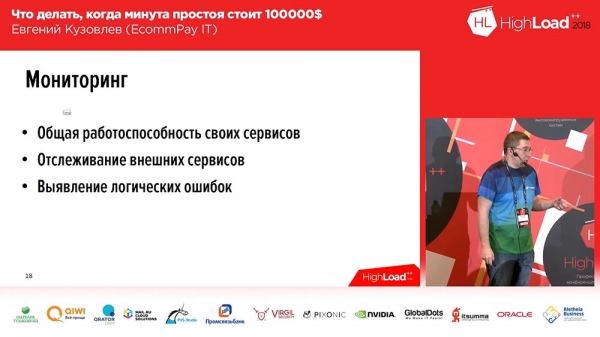
Tri veci!- Musíme rýchlo pochopiť a rýchlo pochopiť výkonnosť našich vlastných zdrojov.
- Musíme rýchlo pochopiť zlyhania a monitorovať výkon systémov, ktoré sú mimo nás.
- Tretím bodom je identifikácia logických chýb. Vtedy systém funguje správne a podľa všetkých indikácií je všetko v poriadku, ale niečo sa pokazí.
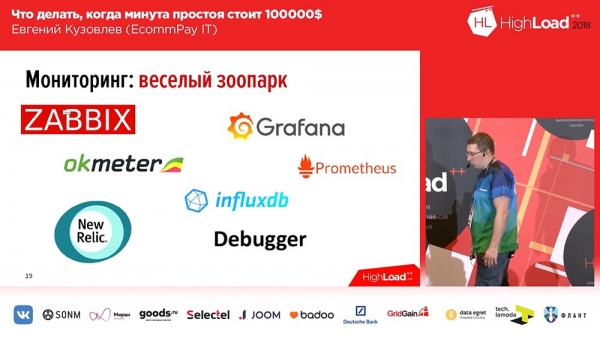
Asi tu nebudem mať veľa čo povedať, čo by bolo obzvlášť vzrušujúce. Budem len Kapitán Zrejmý. Pozerali sme sa, čo bolo dostupné na trhu. Nakoniec sme mali „zábavnú zoo“. Toto je to, čo teraz máme:
Na monitorovanie hardvéru a základné metriky serverov používame Zabbix. Pre databázy používame OkMeter. Pre všetky ostatné metriky, ktoré nezapadajú do prvých dvoch, používame Grafanu a Prometheus, niektoré s Grafanou a Prometheusom a niektoré s Grafanou, Influxom a Telegrafom.Pred rokom sme chceli použiť New Relic. Je to skvelá vec; dokáže všetko. Ale aj keď je schopný, je aj drahý. Keď sme narástli na 1 500 serverov, prišiel za nami dodávateľ a povedal: „Podpíšme zmluvu na budúci rok.“ Pozreli sme sa na cenu a povedali sme: „Nie, to neurobíme.“ Teraz New Relic rušíme; pod monitorovaním New Relic nám zostalo asi 1,5 serverov. Cena sa ukázala byť absolútne premrštená.
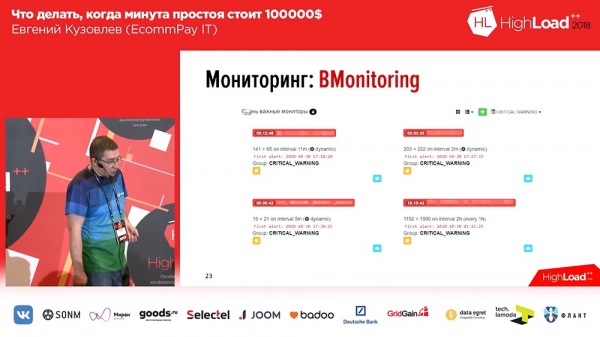
A jeden nástroj sme si sami implementovali – Debugger. Spočiatku sme ho volali „Bagger“, ale potom okolo prešiel náš učiteľ angličtiny, vybuchol smiechom a premenoval ho na „Debugger“. Čo to je? Je to nástroj, ktorý v podstate spúšťa testy každého komponentu, ako „čiernu skrinku“ systému, za 15 – 30 sekúnd, aby sa zabezpečila jeho celková funkčnosť.
Napríklad, ak ide o externú stránku (platobnú stránku), jednoducho ju otvorí a skontroluje, ako by mala vyzerať. Ak sa spracováva, spustí sa testovacia transakcia a skontroluje sa, či prejde. Ak ide o pripojenie k platobným systémom, v prípade možnosti sa spustí testovacia požiadavka a skontroluje sa, či všetko funguje správne.
Aké ukazovatele je dôležité sledovať?
Čo primárne monitorujeme? Ktoré ukazovatele sú pre nás dôležité?
- Doba odozvy / RPS na front-endoch je veľmi dôležitá metrika. Okamžite vám prezradí, či niečo nie je v poriadku.
- Počet správ spracovaných vo všetkých frontoch.
- Počet pracovníkov.
- Základné metriky správnosti.
Posledným bodom je „obchodná“ metrika. Ak chcete sledovať tú istú vec, musíte identifikovať jednu alebo dve metriky, ktoré sú vašimi kľúčovými ukazovateľmi. Pre nás je touto metrikou priepustnosť (pomer úspešných transakcií k celkovému toku transakcií). Ak sa v tejto metrike niečo zmení v intervale 5-10-15 minút, máme problém (ak sa to zmení výrazne).
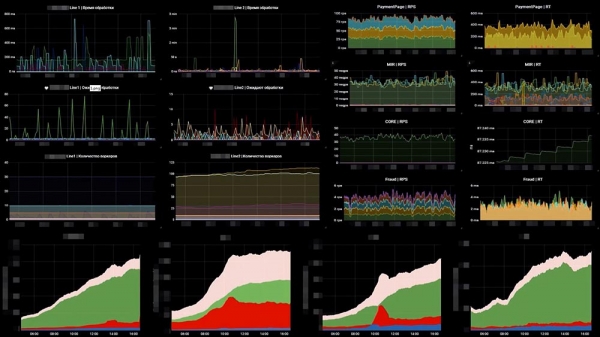
Ako to u nás vyzerá, je príklad jednej z našich dosiek:
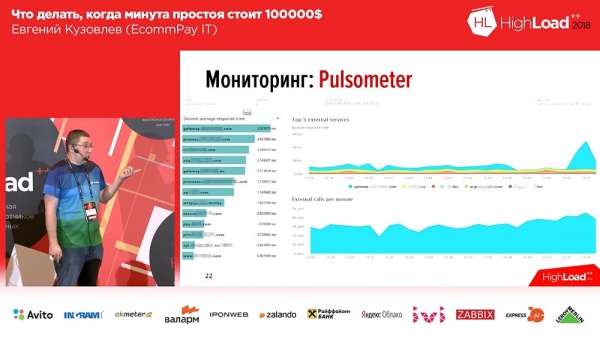
Na ľavej strane je šesť grafov, ktoré predstavujú počet pracovníkov a počet správ vo frontoch. Na pravej strane sú RPS a RTS. Nižšie je tá istá metrika „business“. A v metrike „business“ hneď vidíme, že v dvoch prostredných grafoch sa niečo pokazilo... Len sa zrútil iný systém za nami.Druhou vecou, ktorú sme museli urobiť, bolo monitorovať zlyhanie externých platobných systémov. V tomto prípade sme vzali OpenTracing – mechanizmus, štandard a paradigmu, ktorá umožňuje sledovanie distribuovaných systémov – a mierne sme ho upravili. Štandardná paradigma OpenTracing diktuje, že sledujeme každú jednotlivú požiadavku. Toto sme nepotrebovali, a tak sme to zabalili do súhrnného, agregačného sledovania. Vytvorili sme nástroj, ktorý nám umožňuje monitorovať výkon systémov za nami.
Graf ukazuje, že jeden z platobných systémov začal reagovať do 3 sekúnd – mali sme problémy. Tento systém však reagoval do 20 – 30 sekúnd od začiatku problémov.A treťou triedou chýb monitorovania, ktoré existujú, je logické monitorovanie.
Úprimne povedané, nevedel som, čo dať na túto snímku, pretože sme dlho hľadali na trhu niečo, čo by nám vyhovovalo. Nič sme nenašli, tak sme si to museli vytvoriť sami.
Čo myslím pod pojmom logické monitorovanie? Predstavte si toto: budujete systém (napríklad klon Tinderu); vytvorili ste ho a spustili. Úspešný manažér Vasja Pupkin si ho nainštaluje do telefónu, uvidí tam dievča, páči sa mu... ale lajk nepatrí dievčaťu – padá k strážnikovi Michalyčovi z toho istého obchodného centra. Manažér ide dole schodmi a potom sa čuduje: „Prečo sa naňho ten strážnik Michalyč tak milo usmieva?“V takýchto situáciách... Pre nás táto situácia znie trochu inak, pretože (ako som písal) ide o stratu reputácie, ktorá nepriamo vedie k finančným stratám. Naša situácia je opačná: môžeme utrpieť priame finančné straty – napríklad, ak sme transakciu uviedli ako úspešnú, ale bola neúspešná (alebo naopak). Museli sme si napísať vlastný nástroj, ktorý sleduje počet úspešných transakcií v priebehu času na základe obchodných metrík. Na trhu sme nič nenašli! Presne to som sa snažil povedať. Na trhu nie je nič, čo by dokázalo vyriešiť tento druh problému.
Išlo o to, ako rýchlo identifikovať problém.
Ako určiť dôvody nasadenia
Tretia skupina úloh, ktoré riešime, je po identifikácii problému a jeho odstránení. Bolo by dobré pochopiť dôvod vývoja, testovania a niečo s tým urobiť. Preto musíme preskúmať a načítať protokoly.
Keď už hovoríme o protokoloch (hlavným dôvodom sú protokoly), väčšina našich protokolov je v ELK Stack – to platí pre takmer každého. Pre niektorých to nemusí byť v ELK, ale ak píšete protokoly v gigabajtoch, nakoniec skončíte s použitím ELK. My ich píšeme v terabajtoch.
Tu je problém. Opravili sme ho, opravili sme chybu pre používateľa, začali sme pátrať, aby sme zistili, čo sa deje, vošli sme do Kibany, zadali ID transakcie a dostali sme tento protokol (ukazuje toho veľa). A absolútne nič v tomto protokole nie je jasné. Prečo? Pretože nie je jasné, ktorá časť patrí ktorému pracovníkovi, ktorá časť patrí ktorému komponentu. A vtedy sme si uvedomili, že potrebujeme sledovanie – ten istý OpenTracing, o ktorom som hovoril.Premýšľali sme o tom pred rokom, obrátili sme svoju pozornosť na trh a našli sme dva nástroje: Zipkin a Jaeger. Jaeger je v podstate akýmsi ideologickým nástupcom Zipkinu. Všetko na Zipkine je dobré, okrem toho, že nedokáže agregovať, nedokáže zahrnúť protokoly do sledovania, iba sledovanie času. Jaeger to podporil.
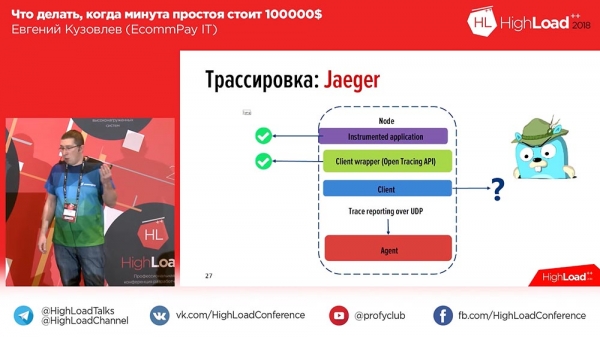
Pozreli sme sa na Eger: vedel vylepšovať aplikácie, vedel písať v API (štandard API pre PHP však v tom čase nebol schválený – to bolo pred rokom a teraz je schválený), ale nemal absolútne žiadny klient. „Dobre,“ pomysleli sme si a napísali sme si vlastného klienta. Čo sme vymysleli? Vyzerá to zhruba takto:
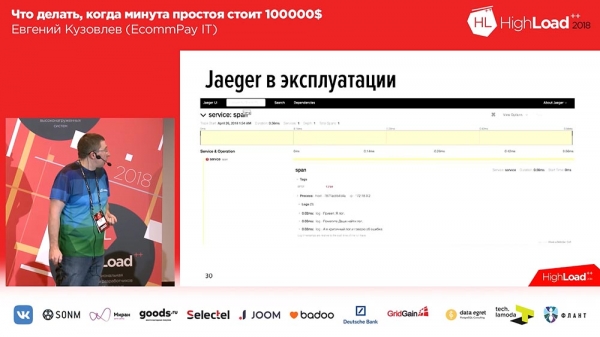
V Egeri sa pre každú správu vytvárajú intervaly (spany). To znamená, že keď používateľ otvorí systém, uvidí jeden alebo dva bloky pre každú prichádzajúcu požiadavku (1-2-3 – počet blokov zodpovedá počtu prichádzajúcich požiadaviek od používateľa). Pre uľahčenie práce pre používateľov sme do protokolov a časového záznamu pridali značky. V prípade chyby naša aplikácia označí protokol zodpovedajúcou značkou „Chyba“. Môžete filtrovať podľa značky „Chyba“ a zobrazia sa iba intervaly obsahujúce daný blok chyby. Takto to vyzerá, ak interval rozbalíme:
Vo vnútri rozsahu sa nachádza sada stôp. V tomto prípade sú to tri testovacie stopy a tretia stopa nám hovorí, že sa vyskytla chyba. Vidíme aj časovú stopu: v hornej časti máme časovú os a vidíme, v akom časovom intervale bol každý záznam zapísaný.Takže, všetko pre nás išlo dobre. Napísali sme si vlastné rozšírenie a sprístupnili sme ho ako open-source. Ak chcete pracovať s trasovaním, ak chcete pracovať s Jaegerom v PHP, je tu naše rozšírenie, vítané na použitie, ako sa hovorí:
Pre nás je toto rozšírenie klientom pre OpenTracing API, zostaveným ako rozšírenie PHP, čo znamená, že ho budete musieť skompilovať a implementovať systém. Pred rokom neexistovalo nič iné. Teraz sa objavili iní klienti, napríklad komponenty. Je to na vás: buď si komponenty stiahnete pomocou Composera, alebo použijete rozšírenie zostavené priamo pre vás.Firemné štandardy
Hovorili sme o troch prikázaniach. Štvrté prikázanie hovorí o štandardizácii prístupov. Čo to znamená? Znie približne takto:
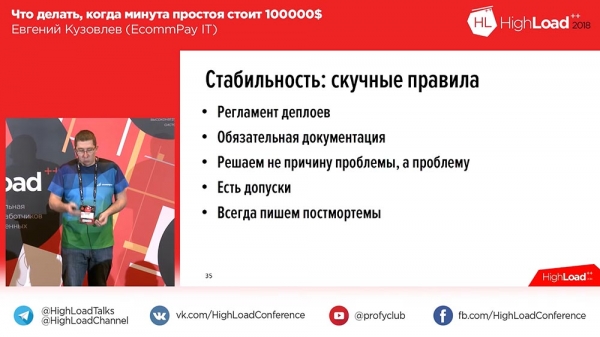
Prečo tu slovo „korporátny“? Nie preto, že by sme bola veľká alebo byrokratická spoločnosť, nie! Chcel som tu použiť slovo „korporátny“ v kontexte, že každá spoločnosť, každý produkt by mal mať svoje vlastné štandardy a ten váš nie je výnimkou. Aké štandardy máme?- Máme politiku nasadzovania. Bez nej sa nemôžeme pohnúť vpred. Nasadzujeme približne 60-krát týždenne, čo znamená, že nasadzujeme prakticky neustále. Naša politika nasadzovania však napríklad zakazuje nasadzovanie v piatok – v podstate nenasadzujeme.
- Dokumentácia je pre nás povinná. Žiadny nový komponent sa nedostane do produkcie bez dokumentácie, ani keď ju vytvoril náš tím pre výskum a vývoj. Požadujeme pokyny na nasadenie, mapu monitorovania a hrubý popis (čo najlepšie, ako to programátori dokážu napísať) fungovania komponentu a riešenia problémov.
- Riešime problém, nie príčinu – to, čo som už spomenul. Je pre nás dôležité chrániť používateľa pred problémami.
- Máme tolerancie. Napríklad, ak stratíme 2 % prevádzky počas dvoch minút, nepovažujeme to za prestoj. Toto sa nezapočítava do našich štatistík. Ak je strata väčšia v percentách alebo čase, berieme to do úvahy.
- A vždy píšeme záverečné správy. Nech sa stane čokoľvek, každá situácia, keď sa vo výrobe niečo pokazilo, sa odrazí v záverečnej správe. Záznamová správa je dokument, v ktorom popíšete, čo sa stalo, podrobný časový rozvrh, čo ste urobili pre nápravu a (toto je povinné!), čo urobíte, aby ste zabránili opakovaniu sa situácie. Toto je povinné a potrebné pre následnú analýzu.
Čo sa považuje za prestoj?
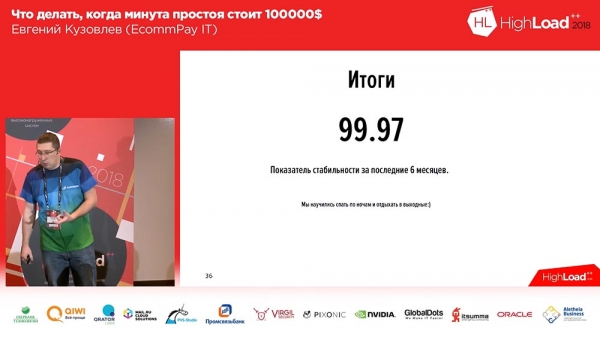
K čomu to všetko viedlo?To viedlo k situácii, keď (mali sme určité problémy so stabilitou, s ktorými sme nespokojní ani našich klientov, ani nás samých) bolo naše skóre stability za posledných šesť mesiacov 99,97. Dalo by sa povedať, že to nie je veľmi vysoké. Áno, máme priestor na zlepšenie. Z tohto skóre je približne polovica spôsobená stabilitou nášho webového aplikačného firewallu, ktorý je nainštalovaný pred nami a používa sa ako služba, ale našim klientom je to jedno.
Naučili sme sa v noci spať. Konečne! Pred šiestimi mesiacmi sme nemohli. A k tejto téme by som chcel urobiť ešte jednu poslednú poznámku. Včera večer bola skvelá prezentácia o systéme riadenia jadrového reaktora. Ak ma ľudia, ktorí tento systém navrhli, počúvajú, nech prosím zabudnú na to, čo som povedal o tom, že „2 % nie sú prestoje“. Pre vás sú 2 % prestoje, aj keby to bolo len na dve minúty!
To je zatiaľ všetko! Vaše otázky.
O vyrovnávačoch záťaže a migrácii databáz
Otázka z publika (ďalej len „O“): Dobrý večer. Ďakujem veľmi pekne za takúto prezentáciu zameranú na administráciu! Rýchla otázka ohľadom vašich vyrovnávačov záťaže. Spomenuli ste, že máte WAF, takže ak tomu rozumiem, používate nejaký externý vyrovnávač záťaže…
ES: – Nie, ako vyrovnávač záťaže používame vlastné služby. V tomto prípade je pre nás WAF čisto nástrojom na ochranu pred DDoS útokmi.
in: – Môžete povedať pár slov o balanceroch?
ES: „Ako som už povedal, ide o skupinu serverov v OpenReste. Momentálne máme päť redundantných skupín, ktoré spracovávajú výhradne... teda server bežiaci výhradne na OpenReste, ktorý iba proxyuje prevádzku. Takže, aby ste mali predstavu o tom, koľko toho spracovávame: náš súčasný štandardný tok prevádzky je niekoľko stoviek megabitov. Zvládajú to dobre, darí sa im úplne v poriadku, ani sa nenamáhajú.“
in: – Ešte jedna jednoduchá otázka. Existuje modré/zelené nasadenie. Čo robíte napríklad s migráciami databáz?
ES: – Dobrá otázka! Pozrite, v našom nasadení Blue/Green máme pre každý pruh samostatné fronty. To znamená, že ak hovoríme o frontoch udalostí, ktoré sa prenášajú z pracovníka na pracovníka, existujú samostatné fronty pre modrý a zelený pruh. Čo sa týka samotnej databázy, zámerne sme ju čo najviac zúžili a takmer všetko sme presunuli do frontov. Databáza uchováva iba zásobník transakcií. A zásobník transakcií je rovnaký pre všetky pruhy. Pokiaľ ide o databázu v tomto kontexte: neoddeľujeme ju pre modrý a zelený pruh, pretože obe verzie kódu potrebujú vedieť, čo sa s transakciou deje.
Priatelia, mám pre vás ďalšiu malú cenu, ktorú by som vám mohol ponúknuť – knihu. A chcem ju dať za najlepšiu otázku.
in: Dobrý deň. Ďakujem za vašu správu. Tu je moja otázka. Monitorujete platby, monitorujete služby, s ktorými interagujete... Ale ako zabezpečíte, aby niekto nejako prešiel na vašu platobnú stránku, vykonal platbu a projekt mu pripísal kredit? To znamená, ako zabezpečíte, aby bol Marchant k dispozícii a prijal vaše spätné volanie?
ES: „Pre nás je obchodník v tomto prípade rovnako externou službou ako platobný systém. Monitorujeme reakčnú dobu obchodníka.“
O šifrovaní databázy
in: Dobrý deň. Mám trochu súvisiacu otázku. Máte citlivé údaje PCI DSS. Chcel by som vedieť, ako ukladáte čísla PAN vo frontoch, do ktorých ich potrebujete odovzdať? Používate nejaké šifrovanie? To vedie k druhej otázke: PCI DSS vyžaduje pravidelné opätovné šifrovanie databázy v prípade zmien (prepustenie administrátora atď.) – ako to ovplyvňuje dostupnosť?
ES: „To je skvelá otázka! V prvom rade neukladáme čísla PAN do frontov. V princípe nesmieme ukladať čísla PAN nikde v otvorenom texte, takže používame špeciálnu službu (nazývame ju „Keydemon“) – službu, ktorá robí iba jednu vec: prijíma správu ako vstup a vracia zašifrovanú správu. A všetko ukladáme pomocou tejto zašifrovanej správy. Dĺžka nášho kľúča je teda menšia ako kilobajt, aby sme zabezpečili úplnú spoľahlivosť.“in: – Potrebujete teraz 2 kilobajty?
ES: – Zdá sa, akoby ich ešte včera bolo 256... No a kde inde?!
To je teda prvá vec. Po druhé, existujúce riešenie podporuje postup opätovného šifrovania – existujú dva páry „kekov“ (kľúčov), ktoré dávajú „balíčky“, ktoré šifrujú (kľúče sú kľúče, deky sú deriváty kľúčov, ktoré šifrujú). Keď sa postup spustí (čo sa stáva pravidelne, od troch mesiacov do ± približne), načítame nový pár „kekov“ a dáta sa opätovne zašifrujú. Máme samostatné služby, ktoré extrahujú všetky dáta a opätovne ich šifrujú; dáta ukladajú identifikátor kľúča, ktorým boli zašifrované. Preto hneď ako sú dáta zašifrované novými kľúčmi, staré kľúče vymažeme.
Niekedy je potrebné platby vykonať manuálne…
in: – Takže, ak dostanete vrátenie peňazí za nejakú transakciu, zatiaľ ju dešifrujete starým kľúčom?
ES: - Áno.
in: – Potom ešte jedna rýchla otázka. Keď dôjde k nejakému zlyhaniu, havárii alebo incidentu, transakciu je potrebné pretlačiť manuálne. Takéto situácie sa stávajú.
ES: - Áno, stáva sa to.
in: – Odkiaľ získavate tieto údaje? Alebo k tomuto úložisku pristupujete sami?
ES: „Nie, no, samozrejme – máme back-office systém, ktorý obsahuje rozhranie pre náš tím podpory. Ak nepoznáme stav transakcie (napríklad preto, že platobný systém ešte nevypršal), nepoznáme ho a priori, čo znamená, že konečný stav priradíme až vtedy, keď si budeme úplne istí. V takom prípade transakcii priradíme špeciálny stav na manuálne spracovanie. Ráno, na druhý deň, hneď ako podpora dostane informáciu, že určité transakcie zostávajú v platobnom systéme, spracuje ich manuálne v tomto rozhraní.“
in: Mám pár otázok. Jedna sa týka rozšírenia zóny PCI DSS: ako exportujete protokoly z tejto oblasti? Je to preto, že vývojár mohol do protokolov vložiť čokoľvek! Druhá otázka znie: ako nasadzujete rýchle opravy? Jednou z možností je manuálne nasadenie do databázy, ale môžu existovať aj bezplatné rýchle opravy – aký je postup? A tretia otázka sa pravdepodobne týka RTO a RPO. Vaša dostupnosť bola 99,97, takmer štyri deviatky, ale ak som pochopil, máte druhé dátové centrum, tretie dátové centrum a piate dátové centrum... Ako riešite ich synchronizáciu, replikáciu a všetko ostatné?ES: Začnime prvou otázkou. Bola prvá otázka o protokoloch? Keď zapisujeme protokoly, máme vrstvu, ktorá maskuje všetky citlivé údaje. Kontroluje masku a ďalšie polia. Naše protokoly sú teda už maskované a sú v súlade s PCI DSS. Toto je jedna z bežných úloh pridelených testovaciemu oddeleniu. Sú povinní skontrolovať každú úlohu, a to aj oproti protokolom, ktoré zapisujú, a to je bežná úloha počas kontroly kódu, aby sa zabezpečilo, že vývojár nič nezapísal. Následné kontroly vykonáva oddelenie informačnej bezpečnosti pravidelne približne raz týždenne: vzorka protokolov z posledného dňa sa odoberie a porovná sa cez špeciálny skener/analyzátor z testovacích serverov, aby sa všetko overilo.
Čo sa týka rýchlych opráv. Toto je zahrnuté v našich zásadách nasadzovania. Máme samostatnú klauzulu o rýchlych opravách. Veríme, že rýchle opravy nasadzujeme 24 hodín denne, 7 dní v týždni, kedykoľvek ich potrebujeme. Hneď ako je verzia zostavená, hneď ako je spustená, hneď ako máme artefakt, podpora zavolá nášho službukonajúceho správcu systému a ten ho nasadí podľa potreby.Čo sa týka „štyroch deviatok“. Číslo, ktoré teraz máme, bolo skutočne dosiahnuté a usilovali sme sa oň s ďalším dátovým centrom. Teraz máme druhé dátové centrum a začíname medzi nimi smerovať a problém replikácie medzi dátovými centrami je skutočne netriviálny. V tom čase sme sa ho snažili vyriešiť rôznymi spôsobmi: skúšali sme napríklad použiť Tarantulu, ale hneď to poviem. Takže sme nakoniec objednávali „sens“ manuálne. Každá aplikácia sa v podstate posiela medzi dátovými centrami v asynchrónnom režime kvôli požadovanej synchronizácii „zmena – hotovo“.
in: „Ak máš druhý, prečo si nemal tretí? Pretože Rozštiepený mozog ho nemá…“
ES: „Nemáme rozdelený mozog.“ Keďže každá aplikácia beží na multimaster serveri, je nám jedno, do ktorého centra sa požiadavka odošle. Sme pripravení na to, že ak jedno dátové centrum vypadne (na to kladieme) a uprostred požiadavky používateľa sa prepne na druhé dátové centrum, sme pripravení daného používateľa stratiť; ale tých bude veľmi, veľmi málo.“
in: – Dobrý večer. Ďakujem za prezentáciu. Hovorili ste o vašom debuggeri, ktorý spúšťa niektoré testovacie transakcie v produkcii. Povedzte mi o testovacích transakciách! Ako hlboko to siaha?
ES: „Prechádza celým cyklom komponentu. Pre komponent nie je rozdiel medzi testovacou a produkčnou transakciou. Logicky ide jednoducho o samostatný projekt v rámci systému, ktorý spúšťa iba testovacie transakcie.“
in: – Kde to odrežete? Jadro odoslané…
ES: – V tomto prípade používame Kor na testovacie transakcie... Máme koncept s názvom smerovanie: Kor vie, do ktorého platobného systému má poslať – my posielame do falošného platobného systému, ktorý jednoducho poskytne HTTP odpoveď a to je všetko.
in: – Povedzte mi, prosím, bola vaša aplikácia napísaná ako jeden obrovský monolit, alebo ste ju rozdelili na rôzne služby alebo dokonca mikroslužby?
ES: „Samozrejme, nemáme monolit; máme aplikáciu orientovanú na služby. Žartujeme, že naša služba sa skladá z monolitov – sú naozaj dosť veľké. Je ťažké ich nazvať mikroslužbami, ale sú to služby, v rámci ktorých bežia distribuovaní strojoví pracovníci.“
Ak je služba na serveri ohrozená…
in: „Potom mám ďalšiu otázku. Aj keby to bol monolit, stále ste povedali, že máte veľa takýchto okamžitých serverov, ktoré v podstate všetky spracovávajú dáta. Otázka teda znie: ‚Ak je jeden z okamžitých serverov alebo aplikácia, alebo akákoľvek jednotlivá súčasť napadnutá, majú nejaký druh kontroly prístupu? Ktorý z nich môže čo robiť? Koho by sme mali kontaktovať a ohľadom akých údajov?‘“
ES: „Áno, určite. Bezpečnostné požiadavky sú dosť prísne. Po prvé, máme otvorené toky dát a budú použité iba porty, ktoré predpokladáme. Ak komponent komunikuje s databázou (napríklad s Muskulom) cez 5-4-3-2, otvorený bude iba 5-4-3-2 a ostatné porty a smery prevádzky nebudú k dispozícii. Okrem toho musíme pochopiť, že v produkčnom prostredí máme približne 10 rôznych bezpečnostných slučiek. A aj keby bola aplikácia nejako ohrozená, nedajbože, útočník by nemal prístup ku konzole pre správu servera, pretože sa nachádza v inej zóne sieťového zabezpečenia.“in: „V tejto súvislosti ma viac zaujíma fakt, že máte s danými službami určité zmluvy – čo môžu robiť, aké akcie môžu použiť na vzájomnú komunikáciu... A v bežnom procese určité služby požadujú od inej služby určitý súbor akcií. Zvyčajne nekontaktujú ostatné a majú rôzne oblasti zodpovednosti. Ak je jedna z nich ohrozená, bude môcť spustiť akcie danej služby?...“
ES: „Chápem. Ak by bola komunikácia s druhým serverom povolená za normálnych okolností, tak áno. Podľa SLA nemonitorujeme, či máte povolené iba prvé tri akcie, ale nie štvrtú. To je pre nás asi prehnané, pretože už máme štvorvrstvový bezpečnostný systém pre okraje siete. Radšej sa chránime okrajmi siete, nie internými komponentmi.“
Ako fungujú karty Visa, MasterCard a Sberbank
in: Chcel by som objasniť jednu vec týkajúcu sa prevodov používateľov z jedného dátového centra do druhého. Pokiaľ viem, Visa a MasterCard fungujú pomocou binárneho synchrónneho protokolu 8583 s kombináciami. A zaujímalo by ma, či máte na mysli prevody priamo medzi Visou a MasterCard, alebo prevody do platobných systémov, do spracovateľských centier?
ES: – To je pred mixami. Naše mixy sa nachádzajú v tom istom dátovom centre.
in: – Zhruba povedané, máte jeden spojovací bod?
ES: „Visa a MasterCard – áno. Jednoducho preto, že Visa a MasterCard vyžadujú značné investície do infraštruktúry na podpísanie samostatných zmlúv napríklad pre druhý pár mixov. Sú zálohované v jednom dátovom centre, ale ak, nedajbože, dátové centrum, kde sa nachádzajú mixy na pripojenie k Vise a MasterCard, zlyhá, stratíme pripojenie k Vise a MasterCard...“
in: „Ako sa dajú zálohovať? Viem, že Visa povoľuje naraz iba jedno pripojenie!“
ES: „Vybavenie dodávajú sami. Aspoň my sme dostali vybavenie, ktoré je úplne nadbytočné.“
in: - Takže stojan je z ich Connects Orange?..
ES: - Áno.
in: – Čo sa teda stane v tomto prípade: ak vaše dátové centrum prestane fungovať, ako ho budete ďalej používať? Alebo sa prevádzka jednoducho zastaví?
ES: „Nie. V takom prípade jednoducho presmerujeme prevádzku na iný kanál, čo bude prirodzene drahšie pre nás aj pre našich klientov. Prevádzka však nebude prechádzať cez naše priame prepojenie s Visa alebo MasterCard, ale povedzme cez Sberbank (veľmi prehnaný príklad).“
Úprimne sa ospravedlňujem, ak som urazil zamestnancov Sberbanky. Ale podľa našich štatistík je Sberbank ruská banka, ktorá najčastejšie krachuje. Neuplynie mesiac bez toho, aby sa v Sberbanke niečo nepokazilo.

Nejaké inzeráty 🙂
Ďakujeme, že ste zostali s nami. Páčia sa vám naše články? Chcete vidieť viac zaujímavého obsahu? Podporte nás zadaním objednávky alebo odporučením priateľom, , jedinečný analóg serverov základnej úrovne, ktorý sme pre vás vymysleli: (k dispozícii s RAID1 a RAID10, až 24 jadier a až 40 GB DDR4).
Dell R730xd 2 krát lacnejší v dátovom centre Equinix Tier IV v Amsterdame? Len tu v Holandsku! Dell R420 – 2x E5-2430 2.2 GHz 6C 128 GB DDR3 2 x 960 GB SSD 1 Gb/s 100 TB – od 99 USD! Čítať o
Zdroj: hab.com
