

Hej, Habr! Vi har levt i en mycket intressant situation de senaste månaderna och jag skulle vilja dela med mig av vår infrastrukturskalningshistoria. Under denna tid har SberMarket vuxit i beställningar 4 gånger och lanserat tjänsten i 17 nya städer. Den explosiva tillväxten i efterfrågan på matleveranser krävde att vi skulle skala vår infrastruktur. Läs om de mest intressanta och användbara slutsatserna under snittet.
Jag heter Dima Bobylev, jag är teknisk chef för SberMarket. Eftersom detta är det första inlägget på vår blogg ska jag säga några ord om mig själv och företaget. I höstas deltog jag i en tävling för unga Runetledare. Till tävlingen I om hur vi på SberMarket ser på den interna kulturen och förhållningssättet till tjänsteutveckling. Och även om jag inte lyckades vinna tävlingen formulerade jag för mig själv de grundläggande principerna för utvecklingen av IT-ekosystemet.
När man leder ett team är det viktigt att förstå och hitta en balans mellan vad verksamheten behöver och varje enskild utvecklares behov. Nu växer SberMarket 13 gånger från år till år, och detta påverkar produkten, vilket kräver att den hela tiden ökar volymen och utvecklingstakten. Trots detta avsätter vi tillräckligt med tid till utvecklare för preliminär analys och kvalitetskodning. Det formade tillvägagångssättet hjälper inte bara att skapa en fungerande produkt, utan också i dess vidare skalning och utveckling. Som ett resultat av denna tillväxt har SberMarket redan blivit ledande bland livsmedelsleveranstjänster: vi levererar cirka 18 tusen beställningar om dagen varje dag, även om det i början av februari fanns cirka 3500 XNUMX.
En dag bad en kund en SberMarket-bud att leverera matvaror till honom kontaktlöst - ända till balkongen
Men låt oss gå vidare till detaljerna. Under de senaste månaderna har vi aktivt skalat upp vårt företags infrastruktur. Detta behov förklarades av externa och interna faktorer. I takt med att kundbasen utökades växte antalet anslutna butiker från 90 i början av året till över 200 i mitten av maj. Vi var naturligtvis förberedda, reserverade huvudinfrastrukturen, plus att vi räknade med möjligheten till vertikal och horisontell skalning av alla virtuella maskiner som är värd i Yandex-molnet. Men praxis har visat: "Allt som kan gå fel kommer att gå fel." Och idag vill jag dela med mig av de mest intressanta situationerna som har hänt under dessa veckor. Jag hoppas att vår erfarenhet kommer att vara användbar för dig.
Slaven är i full stridsberedskap
Redan innan pandemin började ställdes vi inför en ökning av antalet förfrågningar till våra backend-servrar. Trenden med att beställa matvaror för hemleverans började ta fart, och med införandet av de första självisoleringsåtgärderna på grund av COVID-19 växte arbetsbördan dramatiskt under dagen. Det fanns ett behov av att snabbt avlasta huvudservrarna i huvuddatabasen och överföra några av läsbegäranden till replikservrar (slav).
Vi förberedde oss för detta steg i förväg, och två slavservrar har redan lanserats för en sådan manöver. De använde huvudsakligen batchuppgifter för att generera informationsflöden för utbyte av data med partners. Dessa processer skapade en extra börda och togs helt riktigt ur ekvationen ett par månader tidigare.
Eftersom replikering inträffade på slaven, höll vi oss till konceptet att applikationer bara kunde arbeta med dem i skrivskyddat läge. Katastrofåterställningsplanen antog att vi i händelse av en katastrof helt enkelt kunde montera Slaven i stället för Mastern och byta alla skriv- och läsbegäranden till Slaven. Men vi ville också använda repliker för analysavdelningens behov, så servrarna byttes inte helt om till skrivskyddad status, utan varje värd hade sin egen uppsättning användare, och några hade skrivrättigheter för att spara mellanliggande beräkningsresultat.
Upp till en viss belastningsnivå hade vi tillräckligt med master för både att skriva och läsa vid bearbetning av http-förfrågningar. I mitten av mars, precis när Sbermarket bestämde sig för att helt gå över till distansarbete, började vår RPS växa exponentiellt. Fler och fler av våra kunder gick i självisolering eller arbetade hemifrån, vilket påverkade våra arbetsbelastningsindikatorer.
Prestandan för "mästaren" var inte längre tillräcklig, så vi började överföra några av de tyngsta läsbegärandena till repliken. För att på ett transparent sätt dirigera skrivförfrågningar till befälhavaren och läsa förfrågningar till slaven, använde vi rubinpärlan "" Vi skapade en speciell användare med postfixen _readonly utan skrivrättigheter. Men på grund av ett fel i konfigurationen av en av värdarna gick en del av skrivförfrågningarna till slavservern på uppdrag av en användare som hade lämpliga rättigheter.
Problemet visade sig inte direkt, eftersom... den ökade belastningen ökade slavarnas eftersläpning. Inkonsekvensen i uppgifterna upptäcktes på morgonen när slavarna efter nattliga importer inte "kom ikapp" befälhavaren. Vi tillskrev detta till den höga belastningen på själva tjänsten och importen i samband med lanseringen av nya butiker. Men att skicka data med flera timmars fördröjning var oacceptabelt, och vi bytte processer till den andra analytiska slaven, eftersom den hade enоstörre resurser och var inte laddad med läsbegäranden (vilket är hur vi förklarade för oss själva bristen på replikeringsfördröjning).
När vi kom på orsakerna till "spridningen" av huvudslaven, hade den analytiska redan misslyckats av samma anledning. Trots närvaron av ytterligare två servrar till vilka vi planerade att överföra lasten i händelse av ett masterfel, visade det sig på grund av ett olyckligt fel att det inte fanns några tillgängliga i det kritiska ögonblicket.
Men eftersom vi inte bara dumpade databasen (återställningen vid den tiden tog cirka 5 timmar), utan också en ögonblicksbild av masterservern, lyckades vi starta repliken inom 2 timmar. Det är sant, efter detta stod vi inför replikeringsloggen som rullade över under lång tid (eftersom processen körs i enkeltrådsläge, men det är en helt annan historia).
Slutsats: Efter en sådan incident blev det klart att det var nödvändigt att överge bruket att begränsa skrivningen för användare och förklara hela servern skrivskyddad. Med detta tillvägagångssätt råder det ingen tvekan om att repliker kommer att finnas tillgängliga vid kritiska tidpunkter.
Att optimera även en tung fråga kan ge databasen liv igen
Även om vi ständigt uppdaterar katalogen på webbplatsen, tillät förfrågningarna som vi skickade till slavservrarna en liten fördröjning från Mastern. Den tid under vilken vi upptäckte och eliminerade problemet med slavar som "plötsligt lämnar avståndet" var mer än den "psykologiska barriären" (under denna tid kunde priserna ha uppdaterats och kunderna skulle ha sett föråldrade data), och vi var tvungna att växla alla förfrågningar till huvuddatabasservern. Som ett resultat var sajten långsam... men den fungerade åtminstone. Och medan Slave återhämtade sig hade vi inget annat val än optimering.
Medan slavservrarna återhämtade sig gick minuterna långsamt, Mastern förblev överbelastad och vi gjorde alla våra ansträngningar för att optimera aktiva uppgifter enligt "Pareto-regeln": vi valde de TOP-förfrågningar som genererar majoriteten av belastningen och började ställa in . Detta gjordes direkt i farten.
En intressant effekt var att MySQL, laddat till kapacitet, svarade på även en liten förbättring av processerna. Att optimera ett par frågor som endast producerade 5 % av den totala belastningen har redan visat en märkbar CPU-belastning. Som ett resultat kunde vi tillhandahålla ett acceptabelt utbud av resurser för mästaren att arbeta med databasen och få den tid som krävs för att återställa repliker.
Slutsats: Även en liten optimering gör att du kan "överleva" under överbelastning i flera timmar. Detta var precis tillräckligt för att vi skulle återställa servrarna med repliker. Förresten kommer vi att diskutera den tekniska sidan av frågeoptimering i ett av följande inlägg. Så prenumerera gärna på vår blogg om du tycker att den är användbar.
Organisera övervakning av prestanda för partnertjänster
Vi behandlar beställningar från kunder, och därför interagerar våra tjänster ständigt med tredje parts API:er - dessa är gateways för att skicka SMS, betalningsplattformar, routingsystem, geokoder, Federal Tax Service och många andra system. Och när belastningen började växa snabbt började vi stöta på API-begränsningar för våra partnertjänster, som vi inte ens hade tänkt på tidigare.
Att oväntat överskrida kvoterna för partnertjänster kan leda till din egen driftstopp. Många API:er blockerar klienter som överskrider gränserna, och i vissa fall kan för många förfrågningar överbelasta en partners produktion.
Till exempel, när antalet leveranser växte, kunde de medföljande tjänsterna inte klara av uppgifterna att distribuera dem och bestämma rutter. Som ett resultat visade det sig att beställningar gjordes, men tjänsten som skapade rutten fungerade inte. Det måste sägas att våra logistiker gjorde det nästan omöjliga under dessa förhållanden, och det tydliga samspelet mellan teamet hjälpte till att kompensera för tillfälliga servicefel. Men det är orealistiskt att hantera en sådan ordervolym manuellt hela tiden, och efter en tid skulle vi stå inför ett oacceptabelt gap mellan order och deras utförande.
Ett antal organisatoriska åtgärder vidtogs och teamets välkoordinerade arbete bidrog till att vinna tid samtidigt som vi kom överens om nya villkor och väntade på modernisering av tjänster från några partners. Det finns andra API:er som har hög uthållighet och upprörande priser i händelse av hög trafik. Till exempel använde vi i början ett välkänt mappnings-API för att fastställa adressen till leveransstället. Men i slutet av månaden fick vi en snygg räkning på nästan 2 miljoner rubel. Efter det bestämde de sig för att snabbt byta ut den. Jag kommer inte att ägna mig åt reklam, men jag kommer att säga att våra utgifter har minskat avsevärt.
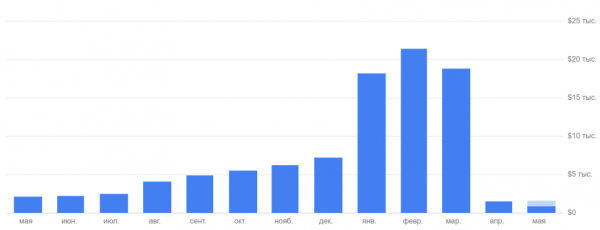
Slutsats: Det är absolut nödvändigt att övervaka driftsförhållandena för alla partnertjänster och ha dem i åtanke. Även om det idag verkar som att de har "stor marginal" för dig, betyder det inte att de i morgon inte kommer att bli ett hinder för tillväxt. Och naturligtvis är det bättre att komma överens om de ekonomiska villkoren för ökade förfrågningar om tjänsten i förväg.
Ibland visar det sig att ""(c) hjälper inte
Vi är vana vid "gags" i huvuddatabasen eller på applikationsservrar, men vid skalning kan problem uppstå där de inte förväntades. För fulltextsökning på webbplatsen använder vi Apache Solr-motorn. När belastningen ökade noterade vi en minskning av svarstiden och serverprocessorbelastningen nådde redan 100 %. Vad kan vara enklare – låt oss ge containern med Solr fler resurser.
Istället för den förväntade prestandaökningen "döde servern helt enkelt". Den laddade omedelbart till 100 % och svarade ännu långsammare. Från början hade vi 2 kärnor och 2 GB RAM. Vi bestämde oss för att göra det som brukar hjälpa - vi gav servern 8 kärnor och 32 GB. Allt blev mycket värre (vi berättar exakt hur och varför i ett separat inlägg).
Under loppet av några dagar kom vi på det här problemets krångligheter och uppnådde optimal prestanda med 8 kärnor och 32 GB. Denna konfiguration gör att vi kan fortsätta att öka belastningen idag, vilket är mycket viktigt, eftersom tillväxten inte bara sker hos kunder utan också i antalet anslutna butiker - på två månader har deras antal fördubblats.
Slutsats: Standardmetoder som "lägg till mer järn" fungerar inte alltid. Så när du skalar en tjänst måste du ha en god förståelse för hur den använder resurser och testa dess funktion under nya förhållanden i förväg.
Stateless är nyckeln till enkel horisontell skalning
I allmänhet följer vårt team ett välkänt tillvägagångssätt: tjänster bör inte ha ett internt tillstånd (statlöst) och bör vara oberoende av exekveringsmiljön. Detta gjorde det möjligt för oss att klara av lasttillväxt genom enkel horisontell skalning. Men vi hade en undantagstjänst - en hanterare för långa bakgrundsuppgifter. Han var involverad i att skicka e-post och sms, bearbeta händelser, generera flöden, importera priser och lager samt bearbeta bilder. Det hände så att det berodde på lokal fillagring och fanns i en enda kopia.
När antalet uppgifter i processorkön ökade (och detta skedde naturligtvis med ett ökat antal order) blev prestandan hos den värd där processorn och fillagringen fanns en begränsande faktor. Som ett resultat avbröts uppdatering av sortiment och priser, skicka aviseringar till användare och många andra viktiga funktioner som fastnade i kön. Ops-teamet migrerade snabbt fillagring till S3-liknande nätverkslagring, och detta gjorde det möjligt för oss att höja flera kraftfulla maskiner för att skala bakgrundsuppgiftsprocessorn.
Slutsats: Regeln om statslösa måste följas för alla komponenter utan undantag, även om det verkar "vi definitivt inte kommer att kunna motstå här." Det är bättre att lägga lite tid på att korrekt organisera driften av alla system än att hastigt skriva om koden och fixa en överbelastad tjänst.
7 principer för intensiv tillväxt
Trots tillgången på ytterligare kapacitet har vi trampat på flera misstag i tillväxtprocessen. Under denna tid ökade antalet beställningar mer än 4 gånger. Nu levererar vi redan mer än 17 000 beställningar per dag i 62 städer och planerar att utöka geografin ytterligare – under första halvåret 2020 förväntas tjänsten lanseras i hela Ryssland. För att klara av den växande arbetsbelastningen, med hänsyn till våra redan fulla kottar, har vi utvecklat 7 grundläggande principer för att arbeta under förhållanden med konstant tillväxt:
- Incidenthantering. Vi skapade en tavla i Jira, där varje incident återspeglas i form av en biljett. Detta kommer att hjälpa till att faktiskt prioritera och utföra incidentrelaterade uppgifter. När allt kommer omkring, i huvudsak är det inte läskigt att göra misstag, men det är läskigt att göra misstag två gånger vid samma tillfälle. För de fall incidenter återkommer innan orsaken kan åtgärdas bör åtgärdsanvisningar vara klara, eftersom det under tider med hög belastning är viktigt att reagera blixtsnabbt.
- övervakning krävs för alla infrastrukturelement utan undantag. Det var tack vare honom som vi kunde förutsäga lastens tillväxt och korrekt välja "flaskhalsar" för att prioritera eliminering. Troligtvis, under hög belastning, kommer allt som du aldrig tänkt på att gå sönder eller börja sakta ner. Därför är det bäst att skapa nya varningar direkt efter att de första incidenterna inträffat för att övervaka och förutse dem.
- Korrekt varningar helt enkelt nödvändigt när belastningen ökar kraftigt. Först måste de rapportera exakt vad som är trasigt. För det andra bör det inte finnas många varningar, eftersom överflöd av icke-kritiska varningar leder till att alla varningar ignoreras helt och hållet.
- Ansökningar måste vara statslösa. Vi är övertygade om att det inte bör finnas några undantag från denna regel. Vi behöver fullständigt oberoende från runtime-miljön. För att göra detta kan du lagra delad data i en databas eller till exempel direkt i S3. Ännu bättre, följ reglerna.. Under en kraftig ökning av tiden finns det helt enkelt inget sätt att optimera koden, och du kommer att behöva klara av belastningen genom att direkt öka beräkningsresurserna och horisontell skalning.
- Kvoter och utförande av externa tjänster. Med snabb tillväxt kan ett problem uppstå inte bara i din infrastruktur, utan även i en extern tjänst. Det mest irriterande är när detta inte händer på grund av ett misslyckande, utan på grund av att man har nått kvoter eller gränser. Så externa tjänster bör skalas lika bra som du gör.
- Separata processer och köer. Detta hjälper mycket när det finns en blockering vid en av gateways. Vi skulle inte stöta på förseningar i dataöverföringen om fullständiga SMS-sändningsköer inte störde utbytet av meddelanden mellan informationssystem. Och det skulle vara lättare att öka antalet arbetare om de arbetade separat.
- Finansiella realiteter. När det sker en explosiv tillväxt i dataflöden finns det ingen tid att tänka på tariffer och abonnemang. Men du måste komma ihåg dem, särskilt om du är ett litet företag. Ägaren av ett API, såväl som din värdleverantör, kan ådra sig en stor räkning. Så du måste läsa kontrakten noggrant.
Slutsats
Inte utan förluster, men vi överlevde det här stadiet, och idag försöker vi följa alla principer som hittats, och varje maskin har förmågan att enkelt öka x4-prestanda för att klara av några oväntade händelser.
I följande inlägg kommer vi att dela med oss av vår erfarenhet av att undersöka prestandaförsämring i Apache Solr, och även prata om frågeoptimering och hur interaktion med Federal Tax Service hjälper företaget att spara pengar. Prenumerera på vår blogg så att du inte missar något, och berätta i kommentarerna om du hade liknande problem under trafiktillväxten.
Endast registrerade användare kan delta i undersökningen. , Snälla du.
Har du någonsin upplevt en avmattning/nedgång i service på grund av en kraftig ökning av belastningen på grund av:
55,6%Oförmåga att snabbt lägga till datorresurser10
16,7%Infrastrukturgränser för värdleverantörer3
33,3%Begränsningar för tredje parts API:er6
27,8%Brott mot de statslösa principerna för deras tillämpningar5
88,9%Icke-optimal kod för egna tjänster16
18 användare röstade. 6 användare avstod från att rösta.
Källa: will.com
