

Hej alla.
Jag är en Linux-administratör som flyttade från Ryssland till Australien på ett oberoende professionellt visum 2015, men den här artikeln handlar inte om hur en gris kan starta en traktor. Det finns redan tillräckligt med sådana här artiklar (men om det finns intresse kommer jag att skriva om detta också), så jag skulle vilja berätta om hur jag, på mitt jobb i Australien som linux-ops-ingenjör, initierade en migrering från ett övervakningssystem till ett annat. Närmare bestämt - Nagios => Icinga2.
Artikeln handlar dels teknisk och dels om att kommunicera med människor och de problem som är förknippade med skillnader i kultur och arbetssätt.
Tyvärr markerar inte "code"-taggen Puppet och yaml code, så jag var tvungen att använda "plaintext".
Det fanns inga tecken på problem på morgonen den 21 december 2016. Som vanligt läste jag Habr som en oregistrerad anonym användare under arbetsdagens första halvtimme, drack kaffe och stötte på .
Eftersom mitt företag just råkade använda Nagios, tänkte jag inte två gånger på att skapa en biljett i Redmine och skicka länken till den allmänna chatten, eftersom jag ansåg det viktigt. Initiativ är straffbart även i Australien, så huvudingenjören fäste problemet på mig sedan jag upptäckte det.
Skärmdump från Redmine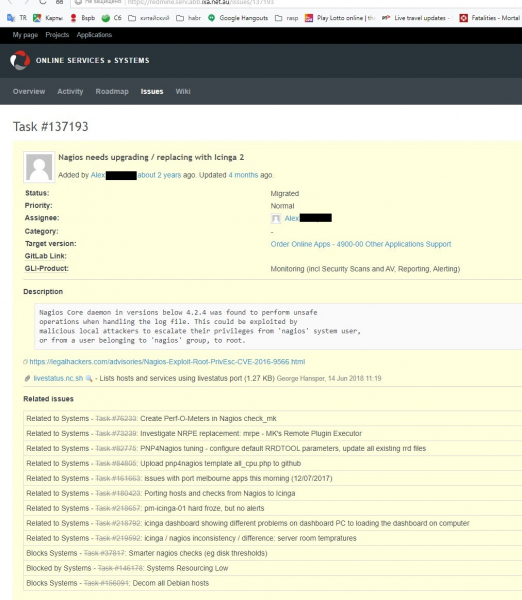
På vår avdelning, innan du uttalar din åsikt, är det vanligt att erbjuda minst ett alternativ, även om valet är uppenbart, så jag började med att googla vilka övervakningssystem som för närvarande är relevanta, eftersom jag i Ryssland, på min sista arbetsplats, hade mitt eget hemgjorda system, mycket primitivt, men ändå ganska funktionellt och fullföljde alla uppgifter som tilldelats det. Python, St. Petersburg Polytechnic University och tunnelbaneregeln. Nej, tunnelbanan suger. Detta är personligt (11 års arbete) och är värt en separat artikel, men inte nu.
Lite om reglerna för att göra ändringar i infrastrukturkonfigurationen på min nuvarande plats. Vi använder Puppet, Gitlab och Infrastructure som en kod, så:
- Inga manuella ändringar via SSH genom att manuellt ändra några filer på de virtuella maskinerna. Under tre års arbete har jag blivit tillrättavisad för detta många gånger, senast var för en vecka sedan och jag tror inte att det var sista gången. Tja, verkligen - korrigera en rad i konfigurationen, starta om tjänsten och se om problemet är löst - 10 sekunder. Skapa en ny gren i Gitlab, tryck på ändringarna, vänta tills r10k körs på Puppetmaster, kör Puppet --environment=mybranch och vänta ett par minuter till för att allt ska köras - minst 5 minuter.
- Eventuella ändringar görs genom att skapa en sammanslagningsförfrågan i Gitlab och kräver godkännande från minst en gruppmedlem. Större förändringar som beslutas av teamledaren kräver två eller tre godkännanden.
- Alla ändringar är textmässiga på något sätt (eftersom Puppet-manifest, skript och Hiera-data är text), avråds binära filer starkt och det måste finnas en god anledning att godkänna sådana filer.
Så alternativen jag övervägde var:
- Munin - om det finns fler än 10 servrar i infrastrukturen förvandlas administrationen till ett helvete (från . Jag hade ingen speciell lust att testa detta, så jag tog hans ord för det).
- Zabbix – Jag har tittat på det länge, tillbaka i Ryssland, men då var det för mycket för mina uppgifter. Här - fick kasseras på grund av användningen av Puppet som konfigurationshanterare och Gitlab som versionskontrollsystem. På den tiden lagrar Zabbix, så vitt jag förstått, hela konfigurationen i databasen, och därför var det oklart hur man skulle hantera konfigurationen under rådande förhållanden och hur man skulle spåra ändringar.
- Prometheus är vad vi så småningom kommer fram till, att döma av stämningen på avdelningen, men på den tiden behärskade jag det inte och kunde inte demonstrera ett riktigt fungerande prov (Proof of Concept), så jag var tvungen att överge det.
- Det fanns också flera andra alternativ som antingen krävde en fullständig omdesign av systemet, eller var i sin linda/övergivna tillstånd och avvisades av samma anledning.
Till slut bestämde jag mig för Icinga2 av tre anledningar:
1 - kompatibilitet med Nrpe (en klienttjänst som kör kontroller av kommandon från Nagios). Detta var väldigt viktigt, för vid den tiden hade vi 135 (nu 2019 finns det 165) virtuella maskiner med en massa anpassade tjänster/kontroller, och att göra om allt detta skulle ha varit en enorm smärta i röven.
2 - alla konfigurationsfiler är text, vilket gör det enkelt att redigera denna fråga, skapa sammanslagningsförfrågningar med möjligheten att se vad som har lagts till eller tagits bort.
3 är ett levande och växande OpenSource-projekt. Vi älskar OpenSource och bidrar till det så mycket vi kan genom att skapa Pull Requests och Issues för att lösa problem.
Så här går vi, Icinga2.
Det första jag var tvungen att ta itu med var mina kollegors tröghet. Alla är vana vid Nagios/Nadjios (även om de inte ens här kunde komma till en kompromiss om hur man uttalar det) och CheckMK-gränssnittet. Icingas gränssnitt ser helt annorlunda ut (detta var ett minus), men det är möjligt att flexibelt anpassa vad du behöver se med hjälp av filter för bokstavligen vilken parameter som helst (detta var ett plus, men jag kämpade hårt för det).
filter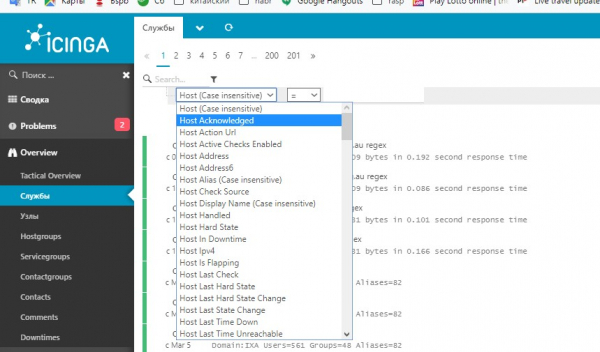
Utvärdera förhållandet mellan rullningslistens storlek och rullningsfältets storlek.
För det andra är alla vana vid att se hela infrastrukturen på en bildskärm, eftersom CheckMk låter dig arbeta med flera Nagios-värdar, men Icinga-gränssnittet kunde inte göra detta (faktiskt kunde det, men mer om det nedan). Alternativet var något som hette Thruk, men dess design fick alla i laget att gagga utom en – den som föreslog det (inte jag).
Kasta Thruk i elden - enhälligt beslut av laget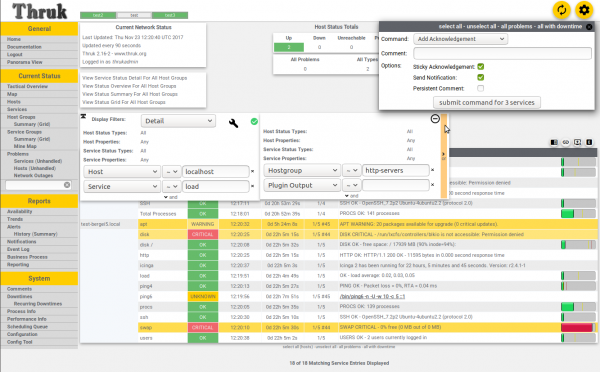
Efter ett par dagars brainstorming kom jag på idén om klusterövervakning, där det finns en mastervärd i produktionszonen och två slavar - en i dev/test och en extern värd placerad hos en annan leverantör med syftet att övervaka våra tjänster från kundens eller en extern observatörs synvinkel. Denna konfiguration gjorde det möjligt för oss att se alla problem i ett webbgränssnitt och fungerade ganska bra, men Puppet... Problemet med Puppet var att huvudvärden nu var tvungen att känna till alla värdar och tjänster/kontroller i systemet och var tvungen att distribuera dem mellan zoner (dev-test, staging-prod, ext), men att skicka ett par ändringar via Icinga API tar ett par sekunder att katalogisera alla Puppet-tjänsterna, medan alla Puppet-tjänster tar ett par sekunder. minuter. Jag får fortfarande skulden för detta, även om jag redan flera gånger har förklarat hur allt fungerar och varför det tar så lång tid.
För det tredje finns det ett gäng SnowFlakes - saker som sticker ut från det allmänna systemet eftersom de har något speciellt över sig, så de allmänna reglerna gäller inte för dem. Det löstes genom en frontalattack - om det finns larm, men i själva verket är allt bra, här måste du gräva djupare och ta reda på varför det varnar mig, även om det inte borde. Eller vice versa - varför får Nagios panik, men Icinga är det inte.
För det fjärde hade Nagios arbetat här i tre år före mig, och han litades till en början mer på än mitt nymodiga hipstersystem, så varje gång Icinga började få panik gjorde ingen något förrän Nagios blev upphetsad över samma problem. Men mycket sällan utfärdade Icinga riktiga larm före Nagios och jag anser att detta är ett allvarligt fel, som jag kommer att prata om i avsnittet "Slutsatser".
Till slut försenades driftsättningen i mer än 5 månader (planerad till den 28 juni 2018, faktiskt - den 3 december 2018), främst på grund av "paritetskontrollen" - det där skitet när det finns flera tjänster i Nagios, som ingen har hört något om de senaste åren, men JUST NU hade de, fan det, jag hade ingen anledning att förklara, varför och inte hade någon anledning att förklara. för att lägga till dem i Icinga så att "paritetskontrollen är klar" (Alla tjänster/kontroller i Nagios motsvarar tjänster/kontroller i Icinga)
Genomförande:
Det första är Code vs Data-kriget, som Puppet Style. All data, absolut allt, måste finnas i Hiera och inget annat. All kod finns i .pp-filer. Variabler, abstraktioner, funktioner - allt går i pp.
Som ett resultat har vi ett gäng virtuella maskiner (165 i skrivande stund) och 68 webbapplikationer som behöver övervakas för funktionalitet och giltighet av SSL-certifikat. Men på grund av historiskt krångel tas information för övervakning av applikationer från ett separat gitlab-förråd och dataformatet har inte ändrats sedan Puppet 3, vilket skapar ytterligare svårigheter i konfigurationen.
Dockkod för applikationer, skydda dina ögon
define profiles::services::monitoring::docker_apps(
  Hash $app_list,
  Hash $apps_accessible_from,
  Hash $apps_access_list,
  Hash $webhost_defaults,
  Hash $webcheck_defaults,
  Hash $service_overrides,
  Hash $targets,
  Hash $app_checks,
  )
{
#### APPS ####
  $zone = $name
  $app_list.each | String $app_name, Hash $app_data |
  {

    $notify_group = { 'notify_group' => ($webcheck_defaults[$zone]['notify_group'] + pick($app_data['notify_group'], {} )) } # adds notifications for default group (systems) + any group defined in int/pm_docker_apps.eyaml

    $data = merge($webhost_defaults, $apps_accessible_from, $app_data)

    $site_domain = $app_data['site_domain']

    $regexp = pick($app_data['check_regex'], 'html')        # Pick a regex to check

    $check_url = $app_data['check_url'] ? {
      undef   => { 'http_uri' => '/' },
      default => { 'http_uri' => $app_data['check_url'] }
    }

    $check_regex = $regexp ?{
      'absent' => {},
      default  => {'http_expect_body_regex' => $regexp}
    }

    $site_domain.each | String $vhost, Hash $vdata | {        # Split an app by domains if there are two or more
      $vhost_name = {'http_vhost' => $vhost}

      $vars = $data['vars'] + $vhost_name + $check_regex + $check_url

      $web_ipaddress = is_array($vdata['web_ipaddress']) ? {  # Make IP-address an array if it's not, because askizzy has 2 ips and it's an array
        true  => $vdata['web_ipaddress'],
        false => [$vdata['web_ipaddress']],
      }

      $access_from_zones = [$zone] + $apps_access_list[$data['accessible_from']] # Merge default zone (where the app is defined) and extra zones if they exist
      $web_ipaddress.each | String $ip_address | {            # For each IP (if we have multiple)
        $suffix = length($web_ipaddress) ? {                  # If we have more than one - add IP as a suffix to this hostname to avoid duplicating resources
          1       => '',
          default => "_${ip_address}"
        }
        $octets = split($ip_address, '.')
        $ip_tag = "${octets[2]}.${octets[3]}" # Using last octet only causes a collision between nginx-vip 203.15.70.94 and ext. ip 49.255.194.94

        $access_from_zones.each | $zone_prefix |{
          $zone_target = $targets[$zone_prefix]

          $nginx_vip_name = "${zone_prefix}_nginx-vip-${ip_tag}" # If it's a host for ext - prefix becomes 'ext_' (ext_nginx-vip...)
          $nginx_host_vip = {
            $nginx_vip_name => {
              ensure        => present,
              target        => $zone_target,
              address       => $ip_address,
              check_command => 'hostalive',
              groups        => ['nginx_vip',],
            }
          }

          $ssl_vars = $app_checks['ssl']
          $regex_vars = $app_checks['http'] + $vars + $webcheck_defaults[$zone] + $notify_group

          if !defined( Profiles::Services::Monitoring::Host[$nginx_vip_name] ) {
          ensure_resources('profiles::services::monitoring::host', $nginx_host_vip)
          }

          if !defined( Icinga2::Object::Service["${nginx_vip_name}_ssl"] ) {
            icinga2::object::service {"${nginx_vip_name}_ssl":
              ensure         => $data['ensure'],
              assign         => ["host.name == $nginx_vip_name",],
              groups         => ['webchecks',],
              check_command  => 'ssl',
              check_interval => $service_overrides['ssl']['check_interval'],
              target         => $targets['services'],
              apply          => true,
              vars           => $ssl_vars
            }
          }
          if $regexp != 'absent'{
            if !defined(Icinga2::Object::Service["${vhost}${$suffix} regex"]){
              icinga2::object::service {"${vhost}${$suffix} regex":
                ensure          => $data['ensure'],
                assign          => ["match(*_nginx-vip-${ip_tag}, host.name)",],
                groups          => ['webchecks',],
                check_command   => 'http',
                check_interval  => $service_overrides['regex']['check_interval'],
                target          => $targets['services'],
                enable_flapping => true,
                apply           => true,
                vars            => $regex_vars
              }
            }
          }
        }
      }
    }
  }
}
Värd- och tjänstkonfigurationskoden ser också hemsk ut:
monitoring/config.pp
class profiles::services::monitoring::config(
  Array $default_config,
  Array $hostgroups,
  Hash $hosts = {},
  Hash $host_defaults,
  Hash $services,
  Hash $service_defaults,
  Hash $service_overrides,
  Hash $webcheck_defaults,
  Hash $servicegroups,
  String $servicegroup_target,
  Hash $user_defaults,
  Hash $users,
  Hash $oncall,
  Hash $usergroup_defaults,
  Hash $usergroups,
  Hash $notifications,
  Hash $notification_defaults,
  Hash $notification_commands,
  Hash $timeperiods,
  Hash $webhost_defaults,
  Hash $apps_access_list,
  Hash $check_commands,
  Hash $hosts_api = {},
  Hash $targets = {},
  Hash $host_api_defaults = {},
)
{

  # Profiles::Services::Monitoring::Hostgroup <<| |>> # will be enabled when we move to icinga completely
#### APPS ####
  case $location {
    'int', 'ext': {
      $apps_by_zone = {}
    }
    'pm': {
      $int_apps         = hiera('int_docker_apps')
      $int_app_defaults = hiera('int_docker_app_common')

      $st_apps          = hiera('staging_docker_apps')
      $srs_apps         = hiera('pm_docker_apps_srs')
      $pm_apps          = hiera('pm_docker_apps') + $st_apps + $srs_apps
      $pm_app_defaults  = hiera('pm_docker_app_common')

      $apps_by_zone = {
        'int' => $int_apps,
        'pm'  => $pm_apps,
      }

      $app_access_by_zone = {
        'int' => {'accessible_from' => $int_app_defaults['accessible_from']},
        'pm'  => {'accessible_from' => $pm_app_defaults['accessible_from']},
      }
    }

    default: {
      fail('Please ensure the node has $location fact set (int, pm, ext)')
    }
  }

  file { '/etc/icinga2/conf.d/':
    ensure  => directory,
    recurse => true,
    purge   => true,
    owner   => 'icinga',
    group   => 'icinga',
    mode    => '0750',
    notify  => Service['icinga2'],
  }

  $default_config.each | String $file_name |{
    file {"/etc/icinga2/conf.d/${file_name}":
      ensure => present,
      source => "puppet:///modules/profiles/services/monitoring/default_config/${file_name}",
      owner  => 'icinga',
      group  => 'icinga',
      mode    => '0640',
    }
  }

  $app_checks = {
    'ssl' => $services['webchecks']['checks']['ssl']['vars'],
    'http' => $services['webchecks']['checks']['http_regexp']['vars']
  }

  $apps_by_zone.each | String $zone, Hash $app_list | {
    profiles::services::monitoring::docker_apps{$zone:
      app_list             => $app_list,
      apps_accessible_from => $app_access_by_zone[$zone],
      apps_access_list     => $apps_access_list,
      webhost_defaults     => $webhost_defaults,
      webcheck_defaults    => $webcheck_defaults,
      service_overrides    => $service_overrides,
      targets              => $targets,
      app_checks           => $app_checks,
    }
  }

####    HOSTS    ####

  # Profiles::Services::Monitoring::Host <<| |>> # This is for spaceship invasion when it's ready.
  $hosts_has_large_disks = query_nodes('mountpoints.*.size_bytes >= 1099511627776')

  $hosts.each | String $hostgroup, Hash $list_of_hosts_with_settings | {           # Splitting site lists by hostgroups - docker_host/gluster_host/etc
    $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
    $hostgroup_settings     = $list_of_hosts_with_settings['settings']
    $merged_hostgroup_settings = deep_merge($host_defaults, $list_of_hosts_with_settings['settings'])
    $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{  # Splitting grouplists by hosts
      # Is this host in the array $hosts_has_large_disks ? If so set host.vars.has_large_disks
      if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
        $vars_has_large_disks = { 'has_large_disks' => true }
      } else {
        $vars_has_large_disks = {}
      }
      $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
      $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})
      $host_settings_vars = pick($host_settings['vars'], {})
      $host_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
      $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_notify_group}, $vars_has_large_disks)) # Merging vars separately

      $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

      profiles::services::monitoring::host{$host_name:
        ensure             => $host_data['ensure'],
        display_name       => $host_data['display_name'],
        address            => $host_data['address'],
        groups             => $hostgroups,
        target             => $host_data['target'],
        check_command      => $host_data['check_command'],
        check_interval     => $host_data['check_interval'],
        max_check_attempts => $host_data['max_check_attempts'],
        vars               => $host_data_vars,
        template           => $host_data['template'],
      }
    }
  }
  if !empty($hosts_api){                                                                # All hosts managed by API
    $hosts_api.each | String $zone, Hash $hosts_api_zone | {                            # Split api hosts by zones
      $hosts_api_zone.each | String $hostgroup, Hash $list_of_hosts_with_settings | {   # Splitting site lists by hostgroups - docker_host/gluster_host/etc
        $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
        $hostgroup_settings     = $list_of_hosts_with_settings['settings']
        $merged_hostgroup_settings = deep_merge($host_api_defaults, $list_of_hosts_with_settings['settings'])
        $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{        # Splitting grouplists by hosts
          # Is this host in the array $hosts_has_large_disks ? If so set host.vars.has_large_disks
          if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
            $vars_has_large_disks = { 'has_large_disks' => true }
          } else {
            $vars_has_large_disks = {}
          }
          $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
          $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})

          $host_settings_vars = pick($host_settings['vars'], {})
          $host_api_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
          $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_api_notify_group}, $vars_has_large_disks))
          $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

          if defined(Profiles::Services::Monitoring::Host[$host_name]){
            $hostname = "${host_name}_from_${zone}"
          }
          else
          {
            $hostname = $host_name
          }
          profiles::services::monitoring::host{$hostname:
            ensure             => $host_data['ensure'],
            display_name       => $host_data['display_name'],
            address            => $host_data['address'],
            groups             => $hostgroups,
            target             => "${host_data['target_base']}/${zone}/hosts.conf",
            check_command      => $host_data['check_command'],
            check_interval     => $host_data['check_interval'],
            max_check_attempts => $host_data['max_check_attempts'],
            vars               => $host_data_vars,
            template           => $host_data['template'],
          }
        }
      }
    }
  }

#### END OF HOSTS ####

####   SERVICES   ####

  $services.each | String $service_group, Hash $s_list |{             # Service_group and list of services in that group
    $service_list = $s_list['checks']                                 # List of actual checks, separately from SG settings
    $service_list.each | String $service_name, Hash $data |{

      $merged_defaults = merge($service_defaults, $s_list['settings']) # global service defaults + service group defaults
      $merged_data = merge($merged_defaults, $data)

      $settings_vars = pick($s_list['settings']['vars'], {})
      $this_service_vars = pick($data['vars'], {})
      $all_service_vars = delete_undef_values($service_defaults['vars'] + $settings_vars + $this_service_vars)

      # If we override default check_timeout, but not nrpe_timeout, make nrpe_timeout the same as check_timeout
      if ( $merged_data['check_timeout'] and ! $this_service_vars['nrpe_timeout'] ) {
        # NB: Icinga will convert 1m to 60 automatically!
        $nrpe = { 'nrpe_timeout' => $merged_data['check_timeout'] }
      } else {
        $nrpe = {}
      }

      # By default we use nrpe and all commands are run via nrpe. So vars.nrpe_command = $service_name is a default value
      # If it's server-side Icinga command - we don't need 'nrpe_command'
      # but there is no harm to have that var and the code is shorter

      if $merged_data['check_command'] == 'nrpe'{
        $check_command = $merged_data['vars']['nrpe_command'] ? {
          undef   => { 'nrpe_command' => $service_name },
          default => { 'nrpe_command' => $merged_data['vars']['nrpe_command'] }
        }
      }else{
        $check_command = {}
      }

      # Assembling $vars from Global Default service settings, servicegroup settings, this particular check settings and let's not forget nrpe settings.
      if $all_service_vars['graphite_template'] {
        $graphite_template = {'check_command' => $all_service_vars['graphite_template']}
      }else{
        $graphite_template = {'check_command' => $service_name}
      }
      $service_notify = [] + pick($settings_vars['notify_group'], []) + pick($this_service_vars['notify_group'], []) # pick is required everywhere, otherwise becomes "The value '' cannot be converted to Numeric"

      $service_notify_group = $service_notify ? {
        []      => $service_defaults['vars']['notify_group'],
        default => $service_notify
      } # Assing default group (systems) if no other groups are defined

      $vars = $all_service_vars + $nrpe + $check_command + $graphite_template + {'notify_group' => $service_notify_group}

      # This needs to be merged separately, because merging it as part of MERGED_DATA overwrites arrays instead of merging them, so we lose some "assign" and "ignore" values

      $assign = delete_undef_values($service_defaults['assign'] + $s_list['settings']['assign'] + $data['assign'])
      $ignore = delete_undef_values($service_defaults['ignore'] + $s_list['settings']['ignore'] + $data['ignore'])

      icinga2::object::service {$service_name:
        ensure             => $merged_data['ensure'],
        apply              => $merged_data['apply'],
        enable_flapping    => $merged_data['enable_flapping'],
        assign             => $assign,
        ignore             => $ignore,
        groups             => [$service_group],
        check_command      => $merged_data['check_command'],
        check_interval     => $merged_data['check_interval'],
        check_timeout      => $merged_data['check_timeout'],
        check_period       => $merged_data['check_period'],
        display_name       => $merged_data['display_name'],
        event_command      => $merged_data['event_command'],
        retry_interval     => $merged_data['retry_interval'],
        max_check_attempts => $merged_data['max_check_attempts'],
        target             => $merged_data['target'],
        vars               => $vars,
        template           => $merged_data['template'],
      }
    }
  }
#### END OF SERVICES ####

#### OTHER BORING STUFF ####

  $servicegroups.each | $servicegroup, $description |{
    icinga2::object::servicegroup{ $servicegroup:
      target       => $servicegroup_target,
      display_name => $description
    }
  }

  $hostgroups.each| String $hostgroup |{
    profiles::services::monitoring::hostgroup { $hostgroup:}
  }

  $notifications.each | String $name, Hash $settings |{

    $assign = pick($notification_defaults['assign'], []) + $settings['assign']
    $ignore = pick($notification_defaults['ignore'], []) + $settings['ignore']

    $merged_settings = $settings + $notification_defaults

    icinga2::object::notification{$name:
      target       => $merged_settings['target'],
      apply        => $merged_settings['apply'],
      apply_target => $merged_settings['apply_target'],
      command      => $merged_settings['command'],
      interval     => $merged_settings['interval'],
      states       => $merged_settings['states'],
      types        => $merged_settings['types'],
      assign       => delete_undef_values($assign),
      ignore       => delete_undef_values($ignore),
      user_groups  => $merged_settings['user_groups'],
      period       => $merged_settings['period'],
      vars         => $merged_settings['vars'],
    }
  }

  # Merging notification settings for users with other settings
  $users_oncall = deep_merge($users, $oncall)
  # Magic. Do not touch.
  create_resources('icinga2::object::user', $users_oncall, $user_defaults)
  create_resources('icinga2::object::usergroup', $usergroups, $usergroup_defaults)
  create_resources('icinga2::object::timeperiod',$timeperiods)
  create_resources('icinga2::object::checkcommand', $check_commands)
  create_resources('icinga2::object::notificationcommand', $notification_commands)

  profiles::services::sudoers { 'icinga_runs_ping_l2':
    ensure            => present,
    sudoersd_template => 'profiles/os/redhat/centos7/sudoers/icinga.erb',
  }

}
Jag jobbar fortfarande på dessa nudlar och förbättrar dem så mycket jag kan. Det var dock den här koden som gjorde att vi kunde använda enkel och tydlig syntax i Hiera:
Data
profiles::services::monitoring::config::services:
  perf_checks:
    settings:
      check_interval: '2m'
      assign:
        - 'host.vars.type == linux'
    checks:
      procs: {}
      load: {}
      memory: {}
      disk:
        check_interval: '5m'
        vars:
          notification_period: '24x7'
      disk_iops:
        vars:
          notifications:
            - 'silent'
      cpu:
        vars:
          notifications:
            - 'silent'
      dns_fqdn:
        check_interval: '15m'
        ignore:
          - 'xenserver in host.groups'
        vars:
          notifications:
            - 'silent'
      iftraffic_nrpe:
        vars:
          notifications:
            - 'silent'
  logging:
    settings:
      assign:
        - 'logserver in host.groups'
    checks:
       rsyslog: {}
      nginx_limit_req_other: {}
      nginx_limit_req_s2s: {}
      nginx_limit_req_s2x: {}
      nginx_limit_req_srs: {}
     logstash: {}
      logstash_api:
        vars:
          notifications:
            - 'silent'
Alla kontroller är indelade i grupper, varje grupp har standardinställningar som var och hur ofta dessa kontroller ska köras, vilka aviseringar som ska skickas och till vem.
I varje kontroll kan du omdefiniera vilket alternativ som helst, och allt detta lägger till slut upp till standardinställningarna för alla kontroller som helhet. Det är därför sådant nonsens skrivs i config.pp - det är en sammanslagning av alla standardinställningar med gruppinställningar och sedan med varje enskild kontroll.
En annan mycket viktig förändring var möjligheten att använda funktioner i inställningarna, till exempel funktionen att ersätta port, adress och url för att kontrollera http_regex.
http_regexp:
  assign:
    - 'host.vars.http_regex'
    - 'static_sites in host.groups'
  check_command: 'http'
  check_interval: '1m'
  retry_interval: '20s'
  max_check_attempts: 6
  http_port: '{{ if(host.vars.http_port) { return host.vars.http_port } else { return 443 } }}'
  vars:
    notification_period: 'host.vars.notification_period'
    http_vhost: '{{ if(host.vars.http_vhost) { return host.vars.http_vhost } else { return host.name } }}'
    http_ssl: '{{ if(host.vars.http_ssl) { return false } else { return true } }}'
    http_expect_body_regex: 'host.vars.http_regex'
    http_uri: '{{ if(host.vars.http_uri) { return host.vars.http_uri } else { return "/" } }}'
    http_onredirect: 'follow'
    http_warn_time: 8
    http_critical_time: 15
    http_timeout: 30
    http_sni: true
Detta betyder att om det finns en variabel i värddefinitionen http_port — använd det, annars 443. Till exempel hänger jabber-webbgränssnittet på 9090 och Unifi — på 7443.
http_vhost betyder att ignorera DNS och ta denna adress.
Om värden anger en uri, följ den, annars ta "/".
En rolig historia hände med http_ssl - den här infektionen ville bara inte stänga av på begäran. Jag var fast på den här raden under en lång tid tills det gick upp för mig att variabeln i värddefinitionen:
http_ssl: falseErsätts i uttrycket
if(host.vars.http_ssl) { return false } else { return true }как falsk och till slut visar det sig
if(false) { return false } else { return true }det vill säga, SSL-kontrollen är alltid aktiv. Det löstes genom att ändra syntaxen:
http_ssl: noResultat:
Fördelar:
- Vi har nu ett övervakningssystem, inte två, som vi hade de senaste 7-8 månaderna, eller ett, föråldrat och sårbart.
- Datastrukturen för värdar/tjänster (kontroller) är nu (enligt min mening) mycket mer läsbar och begriplig. För andra var det inte så självklart, så jag var tvungen att göra ett par sidor i den lokala wikin för att förklara hur det hela fungerar och vad man skulle redigera var.
- Det finns en möjlighet till flexibel konfiguration av kontroller med hjälp av variabler och funktioner, till exempel för http_regexp check kan det sökta mönstret, returkoden, url och port anges i värdinställningarna.
- Det finns flera instrumentpaneler, för var och en kan du definiera din egen lista över visade larm och hantera allt detta via Puppet och sammanslagningsförfrågningar.
Nackdelar:
- Teammedlemmarnas tröghet - Nagios arbetade, arbetade och arbetade, och den här Isingaen din stör hela tiden och saktar ner. Hur kan jag se historiken här? Åh, fan, den uppdateras inte... (Det verkliga problemet är att larmhistoriken inte uppdateras automatiskt, bara med F5)
- Systemtröghet - när jag klickar på "uppdatera" (kolla nu) i webbgränssnittet - beror resultatet av exekveringen på vädret på Mars, speciellt på komplexa tjänster som kräver tiotals sekunder att köra. Den här typen av resultat är normalt.

- Sammantaget, enligt sexmånadersstatistiken för de två systemen som arbetar sida vid sida, fungerade Nagios alltid snabbare än Icinga, och detta irriterade mig verkligen. Det verkar för mig som att de trasslat till något med timern och kontrollen var femte minut sker faktiskt var 5:30 eller något liknande.
- Om du startar om tjänsten när som helst (systemctl omstart icinga2) - kommer alla kontroller som pågick vid den tidpunkten att generera ett kritiskt larm på skärmen och från sidan ser det ut som om allt ramlade ner ().
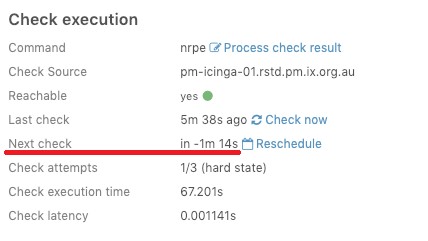
Men överlag fungerar det.
Källa: will.com
