

Fortsättning på översättningen av en liten bok:
«Understanding Message Brokers»
författare: Jakub Korab, förlag: O’Reilly Media, Inc., utgivningsdatum: juni 2017, ISBN: 9781492049296.
Tidigare översatt del:
KAPITEL 3
Kafka
Kafka utvecklades av LinkedIn för att kringgå vissa begränsningar hos traditionella meddelandebrokers och för att undvika behovet av att konfigurera flera meddelandebrokers för olika "punkt-till-punkt"-interaktioner, vilket beskrivs i denna bok i avsnittet om "Vertikal och horisontell skalning" på sida 28. Användningsscenarierna på LinkedIn baserades huvudsakligen på ensidig insamling av mycket stora datamängder, såsom klick på sidor och åtkomstloggar, samtidigt som dessa data tillät användning av flera system utan att påverka prestandan hos producenter eller andra konsumenter. Faktum är att anledningen till att Kafka existerar är för att uppnå den meddelandeutbytesarkitektur som beskrivs i Universal Data Pipeline.
Med detta slutmål i åtanke uppstod naturligtvis andra krav. Kafka måste:
- Var extremt snabb
- Erbjuda hög kapacitet vid meddelandehantering
- Stötta 'Utgivare-Prenumerant'- och 'Punkt-Punkt'-modeller
- Inte saktas ner vid tillägg av konsumenter. Till exempel, prestandan för både köer och ämnen i ActiveMQ försämras med ökat antal konsumenter på mottagarens sida
- Vara horisontellt skalbar; om en broker som lagrar (persisterar) meddelanden kan göra detta endast i maximal hastighet för disken, är det meningsfullt att gå bortom en enda brokerinstans för att öka kapaciteten
- Avgränsa åtkomst till lagring och återvinning av meddelanden
För att uppnå allt detta har Kafka antagit en arkitektur som omdefinierar rollerna och ansvaret för klienter och meddelandebrokers. JMS-modellen är mycket inriktad på brokern, där denna ansvarar för distributionen av meddelanden, och klienterna behöver bara oroa sig för att skicka och ta emot meddelanden. Kafka, å sin sida, är klientcentrerad, där klienten tar på sig många av de traditionella broker-funktionerna, såsom rättvis fördelning av relevanta meddelanden bland konsumenter, i utbyte mot att få en extremt snabb och skalbar broker. För människor som har arbetat med traditionella meddelandesystem kräver arbete med Kafka fundamentala förändringar i synsättet.
Denna ingenjörsmässig inriktning har lett till skapandet av en meddelandeinfrastruktur som kan öka genomströmningen med flera storleksordningar jämfört med en vanlig broker. Som vi kommer att se medför detta tillvägagångssätt kompromisser som innebär att Kafka inte är lämplig för vissa typer av belastningar och installerad programvara.
Enhetlig mottagarmodell
För att uppfylla kraven som nämnts ovan har Kafka kombinerat meddelandetyperna 'publikation-prenumeration' och 'punkt-till-punkt' inom en enda typ av mottagare - ämnet. Detta kan förvirra personer som har arbetat med meddelandesystem där termen 'ämne' hänvisar till en sändlistemechanism, från vilken (från ämnet) läsning inte är pålitlig (är icke-varaktig). Kafka-ämnen bör betraktas som en hybridtyp av mottagare, i enlighet med den definition som ges i inledningen till denna bok.
I resten av detta kapitel, om vi inte uttryckligen anger annat, kommer termen "ämne" att hänvisa till Kafka-ämnet.
För att helt förstå hur ämnen fungerar och vilka garantier de erbjuder, måste vi först titta på hur de är implementerade i Kafka.
Varje ämne i Kafka har sin egen logg.
Producenter som skickar meddelanden till Kafka skriver till denna logg, medan konsumenter läser från loggen med hjälp av pekare som ständigt flyttas framåt. Med jämna mellanrum tar Kafka bort de äldsta delarna av loggen, oavsett om meddelandena i dessa delar har lästs eller inte. En central aspekt av Kafka-designen är att brokern inte bryr sig om meddelandena har lästs eller inte — det är klientens ansvar.
Termerna "logg" och "pekare" förekommer inte i . Dessa välkända termer används här för att underlätta förståelsen.
Denna modell skiljer sig helt från ActiveMQ, där meddelanden från alla köer lagras i en enda logg, och brokern markerar meddelanden som raderade efter att de har lästs.
Låt oss nu dyka djupare ner och titta närmare på ämnets logg.
Kafka-loggen består av flera partitioner (). Kafka garanterar strikt ordning i varje partition. Det innebär att meddelanden som skrivs till en partition i en viss ordning kommer att läsas i samma ordning. Varje partition implementeras som en cyklisk (rolling) loggfil som innehåller ett delmängd (subset) av alla meddelanden som skickats till ämnet av dess producenter. Det skapade ämnet innehåller som standard en partition. Idén med partitioner är en central idé för Kafka för horisontell skalning.
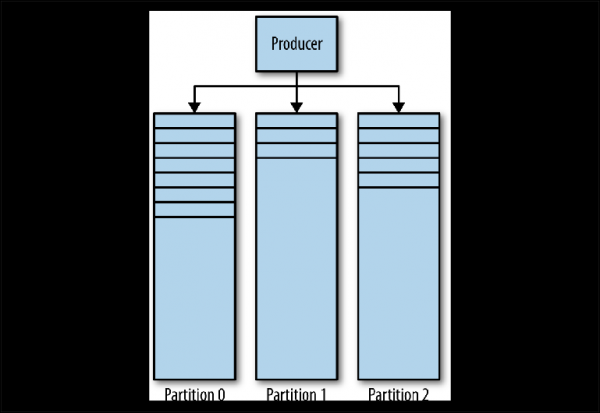
Figur 3-1. Kafka-partitioner
När en producent skickar ett meddelande till ett Kafka-ämne bestämmer han vilken partition som meddelandet ska skickas till. Vi kommer att titta närmare på detta senare.
Läsa meddelanden
En klient som vill läsa meddelanden hanterar en namngiven pekare som kallas konsumentgrupp (consumer group), som pekar på offset för meddelandet i partitionen. Offset är en position med ett växande nummer som börjar vid 0 i början av partitionen. Denna konsumentgrupp, som refereras till i API:et via en användardefinierad identifierare group_id, motsvarar en logisk konsument eller system.
De flesta system som använder meddelandeutbyte läser data från mottagaren genom flera instanser och flöden för parallell meddelandehantering. På så sätt kommer det vanligtvis finnas många instanser av konsumenter som delar en och samma konsumentgrupp.
Problemet med läsning kan beskrivas på följande sätt:
- Ämnet har flera partitioner
- Flera konsumentgrupper kan använda ämnet samtidigt
- En konsumentgrupp kan ha flera separata instanser
Detta är ett icke-trivialt problem av "många till många". För att förstå hur Kafka hanterar relationerna mellan konsumentgrupper, konsumentinstanser och partitioner, låt oss överväga en serie gradvis mer komplexa läsningsscenarier.
Konsumenter och konsumentgrupper
Låt oss ta som utgångspunkt ett ämne med en partition ().
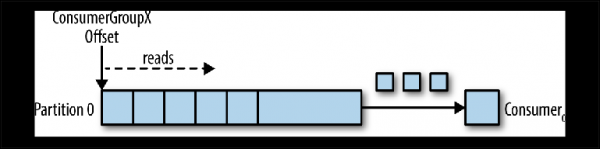
Figure 3-2. Konsumenten läser från partitionen
När en instans av konsumenten ansluter med sitt eget group_id till detta ämne tilldelas den en partition för läsning och en offset i denna partition. Positionen för denna offset konfigureras i klienten, som en pekare till den senaste positionen (det nyaste meddelandet) eller den tidigaste positionen (det äldsta meddelandet). Konsumenten begär (polls) meddelanden från ämnet, vilket leder till sekventiell läsning från loggen.
Offsetpositionen kommitteras regelbundet tillbaka till Kafka och sparas som meddelanden i den interna ämnet _consumer_offsets. De lästa meddelandena raderas inte, till skillnad från en vanlig broker, och klienten kan spola tillbaka (rewind) offseten för att bearbeta redan visade meddelanden igen.
När en andra logisk konsument ansluter, med en annan group_id, hanterar den en andra pekare som inte är beroende av den första (). På så sätt fungerar Kafka-ämnet som en kö, där det finns en konsument och, som ett vanligt pub-sub-ämne, där flera konsumenter är prenumererade, med den extra fördelen att alla meddelanden sparas och kan bearbetas flera gånger.
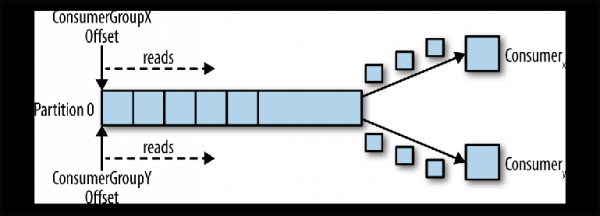
Figure 3-3. Två konsumenter i olika konsumentgrupper läser från en partition
Konsumenter i konsumentgruppen
När en instans av en konsument läser data från en partition kontrollerar den helt pekaren och behandlar meddelandena som beskrivs i föregående avsnitt.
Om flera instanser av konsumenter har anslutits med samma group_id till en topic med en partition, kommer den instans som anslöt sig sist att få kontroll över pekaren och från och med nu ta emot alla meddelanden ().
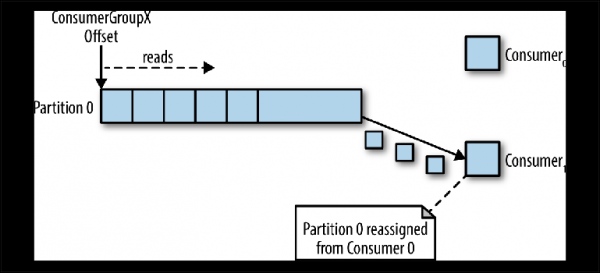
Figur 3-4. Två konsumenter i samma konsumentgrupp läser från en partition
Denna bearbetningsläge, där antalet konsumentinstanser överstiger antalet partitioner, kan ses som en typ av monopolistisk konsumtion. Detta kan vara användbart om du behöver en "aktiv-passiv" (eller "het-varm") klusterbildning av dina konsumentinstanser, även om parallell drift av flera konsumenter ("aktiv-aktiv" eller "het-het") är mycket mer typiskt än inaktiva konsumenter.
Sådant meddelandefördelande beteende, som beskrivits ovan, kan verka förvånande i jämförelse med hur en typisk JMS-kö beter sig. I den här modellen kommer meddelanden som skickas till köer att fördelas jämnt mellan två konsumenter.
Mest vanligt när vi skapar flera instanser av konsumenter gör vi det antingen för parallell bearbetning av meddelanden, för att öka läshastigheten, eller för att öka läsningssystemets motståndskraft. Eftersom endast en instans av en konsument kan läsa data från en partition samtidigt, hur uppnås detta i Kafka?
Ett sätt att göra detta är att använda en instans av en konsument för att läsa alla meddelanden och vidarebefordra dem till en trådpool. Även om denna metod ökar bearbetningens genomströmning, ökar den logikens komplexitet för konsumenterna och gör inget för att öka systemets läsresiliens. Om en instans av konsumenten stängs av på grund av strömavbrott eller en liknande händelse, stoppas läsningen.
Det kanoniska sättet att lösa detta problem i Kafka är att använda fler partitioner.Tillflera partitioner.
Partitionering
Partitioner är den huvudsakliga mekanismen för att parallellisera läsningen och skala ämnen utöver kapaciteten hos en enda brokerinstans. För att bättre förstå detta, låt oss överväga ett scenario där det finns ett ämne med två partitioner och en konsument prenumererar på detta ämne ().
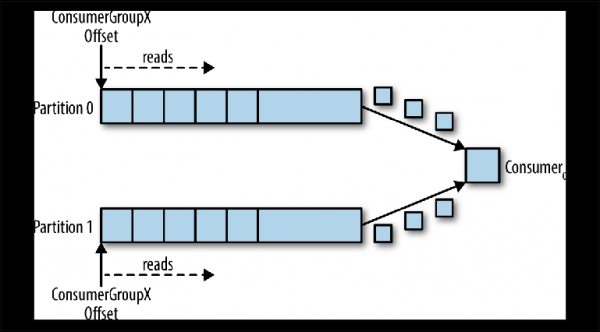
Figur 3-5. En konsument läser från flera partitioner
I detta scenario får konsumenten kontroll över pekarna som motsvarar hans group_id i båda partitionerna och börjar läsa meddelanden från båda partitionerna.
När en extra konsument läggs till för samma group_id, omfördelar Kafka (reallocates) en av partitionerna från den första till den andra konsumenten. Därefter kommer varje konsumentinstans att läsa från en partition av ämnet ().
För att möjliggöra bearbetning av meddelanden parallellt i 20 trådar behöver du minst 20 partitioner. Om det finns färre partitioner kommer du att ha konsumenter som inte har något att arbeta med, vilket tidigare beskrevs i diskussionen om monopolkonsumenter.
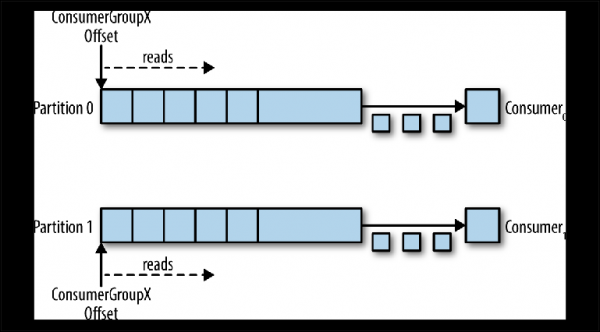
Figur 3-6. Två konsumenter i samma konsumentgrupp läser från olika partitioner
Detta schema minskar avsevärt komplexiteten i hur Kafka-brokern arbetar jämfört med den meddelandefördelning som krävs för att stödja JMS-köer. Här behöver man inte bekymra sig om följande punkter:
- Vilken konsument som ska få nästa meddelande baserat på rund-robin-fördelning, nuvarande kapacitet hos buffertarna för förhandsupphämtning eller tidigare meddelanden (som för JMS meddelandegrupper).
- Vilka meddelanden som har skickats till vilka konsumenter och om de ska levereras igen i händelse av ett fel.
Allt som broker Kafka behöver göra är att konsekvent överföra meddelanden till konsumenten när den senare begär dem.
Dock försvinner inte kraven på parallell läsning och omleverans av misslyckade meddelanden — ansvaret för dessa övergår bara från brokern till klienten. Detta innebär att de behöver beaktas i din kod.
Skicka meddelanden
Ansvarsfrågan för beslutet om vilken partition ett meddelande ska skickas till faller på producenten av det meddelandet. För att förstå den mekanism som detta görs med, behöver vi först titta på vad vi faktiskt skickar.
Medan vi i JMS använder en meddelandestruktur med metadata (huvuden och egenskaper) och en kropp som innehåller nyttolasten (payload), är meddelandet i Kafka ett par "nyckel-värde". Nyttolasten av meddelandet skickas som värde (value). Nyckeln används å sin sida främst för partitionering och bör innehålla en nyckel specifik för affärslogiken, för att placera relaterade meddelanden i samma partition.
I kapitel 2 diskuterade vi scenariot med online-betting när relaterade händelser måste bearbetas i ordning av en konsument:
- Användarkontot är inställt.
- Pengarna sätts in på kontot.
- En insats görs, vilket drar pengar från kontot.
Om varje händelse representerar ett meddelande som skickas till en topic, skulle den naturliga nyckeln i detta fall vara kontots identifierare.
När ett meddelande skickas med Kafka Producer API, överlämnas det till partitioneringsfunktionen, som, med hänsyn till meddelandet och det aktuella tillståndet i Kafka-klustret, returnerar identifieraren för den partition där meddelandet ska skickas. Denna funktion implementeras i Java genom gränssnittet Partitioner.
Detta gränssnitt ser ut som följer:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
Implementeringen av Partitioner för att bestämma partitionen använder standardalgoritmen för nyckelhackning (general-purpose hashing algorithm over the key) eller rond-robin, om nyckeln inte anges. Detta standardvärde fungerar bra i de flesta fall. Men i framtiden kanske du vill skriva din egen.
Skriva en egen partitioneringsstrategi
Låt oss överväga ett exempel där du vill skicka metadata tillsammans med nyttolasten av meddelandet. Nyttolasten i vårt exempel är en instruktion för att sätta in pengar på spelkontot. Instruktionen är något som vi vill garantera att inte modifieras vid överföring och vi vill vara säkra på att endast ett betrott överordnat system kan initiera denna instruktion. I detta fall överenskommer sändande och mottagande system om att använda en signatur för att verifiera meddelandets äkthet.
I ett vanligt JMS definierar vi helt enkelt egenskapen "meddelandesignatur" och lägger till den i meddelandet. Däremot tillhandahåller Kafka ingen mekanism för att skicka metadata — endast nyckel och värde.
Eftersom värdet är nyttolasten för en banköverföring (bank transfer payload), vars integritet vi vill bevara, har vi inget annat val än att definiera datakonstruktionen som ska användas i nyckeln. Förutsatt att vi behöver ett konto-ID för partionering, eftersom alla meddelanden som rör kontot måste behandlas i ordning, kommer vi att konstruera följande JSON-struktur:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Eftersom värdet av signaturen kommer att variera beroende på nyttolasten, kommer standardhashningsstrategin för Partitioner-gränssnittet inte att på ett tillförlitligt sätt gruppera relaterade meddelanden. Därför behöver vi skriva en egen strategi som analyserar denna nyckel och partitionerar värdet av accountId.
Kafka inkluderar kontrollsummor för att upptäcka skador på meddelanden i lagret och har en full uppsättning säkerhetsfunktioner. Trots detta dyker det ibland upp specifika branschkrav, som exemplifierat ovan.
Den anpassade partitioneringsstrategin måste garantera att alla relaterade meddelanden hamnar i samma partition. Även om detta verkar enkelt kan kravet kompliceras av vikten av att ordna relaterade meddelanden och hur fast antal partitioner som finns i ämnet.
Antalet partitioner i ett ämne kan förändras över tid, eftersom de kan läggas till om trafiken överskrider de ursprungliga förväntningarna. Därför kan meddelandenycklar vara kopplade till den partition som de ursprungligen skickades till, vilket implicerar en del av tillståndet som måste fördelas mellan producenter-instansarna.
En annan faktor att ta hänsyn till är even distributionen av meddelanden mellan partitioner. Generellt fördelas nycklar inte jämnt bland meddelandena, och hash-funktioner garanterar inte en rättvis fördelning av meddelanden för ett litet antal nycklar.
Det är viktigt att notera att oavsett hur du väljer att dela meddelanden, kan avgränsaren behöva användas om igen.
Låt oss överväga kravet på datareplication mellan Kafka-kluster på olika geografiska platser. För detta ändamål levereras Kafka med ett kommandoradsverktyg som heter MirrorMaker, vilket används för att läsa meddelanden från ett kluster och överföra dem till ett annat.
MirrorMaker måste förstå nycklarna för det replikerade ämnet för att bibehålla ordningen mellan meddelanden vid replikering mellan kluster, eftersom antalet partitioner för detta ämne kan variera mellan de två klustren.
Anpassade partitioneringsstrategier förekommer relativt sällan, eftersom de standardmässiga hash- eller cykelfördelningarna fungerar framgångsrikt i de flesta scenarier. Men om du behöver strikta garantier för ordning eller om du måste extrahera metadata från nyttolaster, är partitionering något du bör titta närmare på.
Fördelarna med Kafka:s skalbarhet och prestanda beror på att vissa uppgifter för en traditionell broker flyttas till klienten. I detta fall görs beslutet att fördela potentiellt relaterade meddelanden till flera konsumenter som arbetar parallellt.
JMS-brokers måste också hantera sådana krav. Intressant nog kräver mekanismen för att skicka relaterade meddelanden till samma konsument, som realiseras genom JMS Message Groups (en typ av strategi för klibbig belastningsbalansering), att avsändaren markerar meddelanden som relaterade. I JMS:s fall ansvarar brokern för att skicka den gruppen av relaterade meddelanden till en konsument av flera och överföra äganderätten till gruppen om konsumenten avbryts.
Överenskommelser för producenter
Partionering är inte det enda att tänka på när man skickar meddelanden. Låt oss titta på metoderna send() i Producer-klassen i Java API:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Det bör noteras att båda metoderna returnerar Future, vilket indikerar att sändningsoperationen inte utförs omedelbart. Resultatet blir att meddelandet (ProducerRecord) skrivs till sändningsbufferten för varje aktiv partition och överförs till mäklaren av en bakgrundstråd i Kafka-klientbiblioteket. Även om detta gör arbetet otroligt snabbt, betyder det att ett oprofessionellt skrivet program kan förlora meddelanden om dess process stoppas.
Som alltid finns det ett sätt att göra sändningsoperationen mer pålitlig genom att kompromissa med prestandan. Storleken på denna buffert kan ställas in till 0, vilket tvingar sändande applikationsström att vänta tills överföringen av meddelandet till mäklaren är slutförd, på följande sätt:
RecordMetadata metadata = producer.send(record).get();Mer om att läsa meddelanden
Att läsa meddelanden har ytterligare utmaningar som är värda att överväga. Till skillnad från JMS API, som kan starta en meddelandelistor (message listener) som svar på inkommande meddelanden, så använder gränssnittet Consumer Kafka använder endast polling. Låt oss titta närmare på metoden poll (), som används för detta ändamål:
ConsumerRecords poll(long timeout);Returvärdet av metoden är en behållarstruktur som innehåller flera objekt ConsumerRecord från potentiellt flera partitioner. ConsumerRecord är själv en objektbehållare för ett nyckel-värde-par med motsvarande metadata, såsom partitionen det har hämtats från.
Som diskuterades i kapitel 2 måste vi ständigt hålla i åtanke vad som händer med meddelandena efter att de har har hanterats framgångsrikt eller misslyckats, till exempel om klienten inte kan bearbeta meddelandet eller om den kraschar. I JMS hanterades detta genom bekräftelseläge (acknowledgement mode). Mäklaren tar antingen bort det framgångsrikt hanterade meddelandet eller omdistribuerar det ohanterade eller misslyckade (under förutsättning att transaktioner har använts).
Kafka fungerar helt annorlunda. Meddelanden tas inte bort från mäklaren efter att de har lästs och ansvaret för vad som händer vid ett fel ligger på den läsande koden.
Som vi redan har nämnt är en konsumentgrupp kopplad till en förskjutning i loggen. Positionen i loggen kopplad till denna förskjutning motsvarar nästa meddelande som kommer att ges som svar. poll ()Tidpunkten när denna förskjutning ökar är avgörande för läsning.
Återvänder vi till läsningsmodellen som diskuterats tidigare, består bearbetningen av meddelandet av tre steg:
- Extrahera meddelandet för läsning.
- Bearbeta meddelandet.
- Bekräfta meddelandet.
Kafka-konsumenten levereras med en konfigurationsalternativ enable.auto.commit. Detta är en ofta använd standardinställning, som vanligtvis är fallet med inställningar som innehåller ordet 'auto'.
Fram till Kafka 0.10 skickade klienten som använde denna parameter förskjutningen av det senaste lästa meddelandet vid nästa anrop poll () efter bearbetning. Det betydde att eventuella meddelanden som redan hade extraherats (fetched) kunde behandlas på nytt om klienten redan hade bearbetat dem men oväntat stängdes av innan anropet. poll (). Eftersom mäklaren inte sparar något tillstånd beträffande hur många gånger ett meddelande har lästs, kommer nästa konsument som extraherar detta meddelande inte veta att något gick fel. Detta beteende var pseudotransaktionellt. Förskjutningen bekräftades endast efter framgångsrik bearbetning av meddelandet, men om klienten avbröts skickade mäklaren samma meddelande till en annan klient. Detta beteende stämde överens med garantin för meddelandeförsändelse 'minst en gång«.
I Kafka 0.10 ändrades klientkoden så att bekräftelsen nu startades periodiskt av klientbiblioteket, i enlighet med inställningen auto.commit.interval.ms. Detta beteende ligger någonstans mellan lägena JMS AUTO_ACKNOWLEDGE och DUPS_OK_ACKNOWLEDGE. Vid användning av autocommit kunde meddelanden bekräftas oavsett om de faktiskt hade bearbetats - detta kunde inträffa vid en långsam konsument. Om konsumenten stängdes av, extraherades meddelandena av nästa konsument, som började från den bekräftade positionen, vilket kunde leda till att meddelanden gick förlorade. I detta fall förlorade Kafka inte meddelanden, koden som läste dem bearbetade helt enkelt inte dem.
Detta läge har samma perspektiv som i version 0.9: meddelanden kan bearbetas, men vid ett fel kan förskjutningen kanske inte ha bekräftats, vilket potentiellt kan leda till dubblerad leverans. Ju fler meddelanden du extraherar samtidigt poll (), desto större är detta problem.
Som diskuterats i avsnittet "Läsa meddelanden från kön" på sida 21, finns det inget begrepp som engångsleverans av ett meddelande i meddelandesystemet, med tanke på felhanteringslägen.
I Kafka finns det två sätt att registrera (committa) en offset: automatiskt och manuellt. I båda fallen kan meddelanden behandlas flera gånger om ett meddelande har bearbetats, men ett fel inträffade innan det blev committat. Du kan även helt låta bli att behandla ett meddelande om commit ägde rum i bakgrunden och din kod har avslutats innan den påbörjade behandlingen (möjligen i Kafka 0.9 och tidigare versioner).
Du kan styra processen för manuell commit av offset i Kafka-konsumerarens API genom att ställa in parameter enable.auto.commit till false och explícit anropa en av följande metoder:
void commitSync();
void commitAsync();
Om du strävar efter att behandla ett meddelande "åtmintone en gång" måste du committa offset manuellt med commitSync (), genom att köra detta kommando omedelbart efter att ha behandlat meddelandena.
Dessa metoder tillåter inte bekräftelse (acknowledged) av meddelanden innan de har behandlats, men de gör inget för att förhindra potentiell dubbelbehandling, samtidigt som de skapar en illusion av transaktionalitet. Det finns inga transaktioner i Kafka. Klienten har inte möjlighet att göra följande:
- Automatiskt rulla tillbaka (roll back) ett misslyckat meddelande. Konsumenter måste själva hantera undantag som uppstår på grund av problematiska payloads och backend-avbrott, eftersom de inte kan lita på att broker levererar meddelanden på nytt.
- Skicka meddelanden till flera ämnen som en enda atomär operation. Som vi snart kommer att se, kan kontrollen över olika ämnen och partitioner befinna sig på olika maskiner i Kafka-klustret, som inte koordinerar transaktioner vid avsändning. Vid tidpunkten för denna artikels skrivande har det gjorts viss forskning för att möjliggöra detta med hjälp av KIP-98.
- Koppla läsning av ett meddelande från ett ämne med att skicka ett annat meddelande till ett annat ämne. Återigen, Kafka-arkitekturen är beroende av många oberoende maskiner som fungerar som en enda buss och gör inga försök att dölja detta. Till exempel finns det inga API-komponenter som tillåter att koppla ihop Konsument och Producent i transaktionen. I JMS säkerställs detta av objektet Session, från vilket de skapas MessageProducers och MessageConsumers.
Om vi inte kan lita på transaktioner, hur kan vi säkerställa en semantik som är närmare den som traditionella meddelandesystem erbjuder?
Om det finns en möjlighet att konsumentens offset kan öka före meddelandet har behandlats, till exempel vid ett konsumentfel, så finns det inget sätt för konsumenten att veta om hans konsumentgrupp har missat meddelanden när den tilldelas en partition. En av strategierna är därför att spola tillbaka offset till en tidigare position. Kafka-konsumentens API tillhandahåller följande metoder för detta:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Metod seek () kan användas med metoden
offsetsForTimes (Map timestampsToSearch) för att spola tillbaka till ett tillstånd vid en specifik tidpunkt i det förflutna.
Implicit betyder användningen av denna metod att det ganska troligt är att vissa meddelanden som har behandlats tidigare kommer att läsas och behandlas igen. För att undvika detta kan vi använda idempotent läsning, som beskrivs i Kapitlet 4, för att spåra tidigare visade meddelanden och utesluta dubbletter.
Som ett alternativ kan koden för din konsument vara enkel om förlust eller dubblett av meddelanden är acceptabel. När vi överväger användningsscenarier där Kafka vanligtvis används, som logg-, metrik- och klickspårning, förstår vi att förlust av enskilda meddelanden sällan har en betydande påverkan på omgivande applikationer. I sådana fall är standardvärden helt acceptabla. Å andra sidan, om din applikation behöver överföra betalningar måste du noga se till varje enskilt meddelande. Allt beror på sammanhanget.
Personliga observationer visar att med ökande meddelandeintensitet minskar värdet av varje enskilt meddelande. Stora mängder meddelanden blir vanligtvis värdefulla om de betraktas i aggregerad form.
Hög tillgänglighet (High Availability)
Kafkas tillvägagångssätt för hög tillgänglighet skiljer sig väsentligt från ActiveMQ:s. Kafka är designad för att fungera på horisontellt skalbara kluster där alla broker-exemplar tar emot och distribuerar meddelanden samtidigt.
Ett Kafka-kluster består av flera broker-exemplar som körs på olika servrar. Kafka är utformad för att fungera på vanlig autonom hårdvara där varje nod har sin egen dedikerade lagring. Användning av nätverkslagring (SAN) rekommenderas inte, eftersom flera beräkningsnoder kan konkurrera om lagringens tidsintervall och skapa konflikter.Ölagra intervall och skapa konflikter.
Kafka är en alltid aktiv system. Många stora användare av Kafka stänger aldrig ner sina kluster och mjukvaran säkerställer alltid uppdatering genom sekventiell omstart. Detta uppnås genom att garantera bakåtkompatibilitet för meddelanden och interaktioner mellan broker-exemplaren.
Brokers är anslutna till ett kluster av servrar , som fungerar som ett register för konfigurationsinformation och används för att koordinera rollerna för varje broker. ZooKeeper är själv en distribuerad system som säkerställer hög tillgänglighet genom att replikera information genom att upprätta kvorum..
I grundfall skapas en topic i Kafka-klustret med följande egenskaper:
- Antal partitioner. Som diskuterats tidigare beror det exakta värdet som används här på önskad nivå av parallell läsning.
- Replikationsfaktorn definierar hur många broker-exemplar i klustret som ska innehålla loggar för denna partition.
Genom att använda ZooKeeper för koordinering försöker Kafka rättvist fördela nya partitioner mellan broker-exemplaren i klustret. Detta görs av ett exemplar som fungerar som kontroller.
Vid körning för varje partition av en topic Kontroller tilldelar en broker roller ledare (leader, master, huvud) och följare. (följare, slavar, underordnade). En broker som fungerar som ledare för denna partition ansvarar för att ta emot alla meddelanden som skickas till honom av producenter och sprida meddelanden till konsumenterna. När meddelanden skickas till en partitionsämne replikeras de på alla broker-noder som fungerar som följare för denna partition. Varje nod som har loggar för partitionen kallas replik. En broker kan fungera som ledare för vissa partitioner och som följare för andra.
Följaren som innehåller alla meddelanden som lagras hos ledaren kallas synkroniserad replik (in-sync replica). Om en broker som fungerar som ledare för en partition stängs av, kan vilken broker som helst som är i uppdaterat eller synkroniserat tillstånd för denna partition ta över rollen som ledare. Detta är en otroligt robust design.
En del av producentens konfiguration är parametern acks, som bestämmer hur många repliker som måste bekräfta (acknowledge) mottagandet av meddelandet innan applikationsströmmen fortsätter med att skicka: 0, 1 eller alla. Om värdet allanges, kommer ledaren att skicka en bekräftelse (confirmation) tillbaka till producenten så snart den får bekräftelser (acknowledgements) för skrivningen från fler repliker (inklusive sig själv), som anges av inställningen för ämnet min.insync.replicas (standard är 1). Om meddelandet inte kan replikeras framgångsrikt kommer producenten att utlösa ett undantag för applikationen (NotEnoughReplicas eller NotEnoughReplicasAfterAppend).
I en typisk konfiguration skapas ett ämne med en replikeringsfaktor på 3 (1 ledare, 2 följare för varje partition) och parametern min.insync.replicas ställer in värdet 2. I detta fall kommer klustret att tillåta att en av brokerna som hanterar ämnespartitionen kan stängas av utan att påverka klientapplikationerna.
Det här för oss tillbaka till den bekanta kompromissen mellan prestanda och tillförlitlighet. Replikering sker genom ytterligare väntetid för bekräftelser (acknowledgments) från efterföljare. Men eftersom det görs parallellt, har replikering, åtminstone över tre noder, samma prestanda som med två (ignorerar ökat nätverksbandbredd).
Genom att använda detta replikering schema undviker Kafka smidigt behovet av att säkerställa fysisk skrivning av varje meddelande till disk via operationen sync (). Varje meddelande som skickas av producenten kommer att skrivas till partitionens logg, men som diskuterat i Kapitel 2, utförs skrivningen till fil initialt i operativsystemets buffer. Om detta meddelande replikerats till en annan instans av Kafka och finns i dess minne, betyder förlust av ledaren inte att själva meddelandet har gått förlorat - det kan tas över av en synkroniserad replik.
Avståndet från att behöva utföra operationen sync () betyder att Kafka kan ta emot meddelanden i den takt den kan skriva dem i minnet. Och tvärtom, ju längre man kan undvika att tömma (flushing) minnet till disk, desto bättre. Av denna anledning är det inte ovanligt att Kafka-brokers får 64 GB minne eller mer. Denna minnesanvändning innebär att en instans av Kafka kan arbeta i hastigheter som är tusentals gånger snabbare än en traditionell meddelandebroker.
Kafka kan också konfigureras för att tillämpa operationen sync () på meddelandepaket. Eftersom allt i Kafka är inriktat på att arbeta med paket fungerar detta faktiskt ganska bra för många användningsfall och är ett nyttigt verktyg för användare som kräver mycket starka garantier. Största delen av Kafkas rena prestanda relaterar till meddelanden som skickas till brokern i form av paket och att dessa meddelanden läses från brokern i sekventiella block med hjälp av operationer (med operationer där uppgiften att kopiera data från ett minne till ett annat inte utförs). Detta är en stor vinst när det gäller prestanda och resurser och är möjligt tack vare användningen av den underliggande loggdatastrukturen, som definierar partitionsschemat.
I en Kafka-kluster är det möjligt att uppnå mycket högre prestanda än med en enda Kafka-broker, eftersom partitionerna i en topic kan skalas horisontellt över flera separata maskiner.
Sammanfattning
I detta kapitel har vi undersökt hur Kafka-arkitekturen omformulerar relationerna mellan klienter och brokers för att säkerställa en oerhört robust meddelandekanal, med en bandbredd som är många gånger högre än en vanlig meddelandebroker. Vi har diskuterat de funktioner som den använder för att uppnå detta mål, och kortfattat betraktat arkitekturen för de applikationer som tillhandahåller dessa funktioner. I nästa kapitel kommer vi att diskutera vanliga problem som meddelandebaserade applikationer måste hantera, och vi kommer att diskutera strategier för att lösa dessa. Vi avslutar kapitlet med att skissa på hur man resonerar kring meddelandeteknologier i allmänhet, så att du kan bedöma deras lämplighet för dina användningsscenarier.
Tidigare översatt del:
Översättning utförd av:
Fortsättning följer…
Endast registrerade användare kan delta i omröstningen. , tack.
Används Kafka i din organisation?
Ja
Ingen
Användes tidigare, gör det inte nu
Planerar att använda
38 användare röstade. 8 användare avstod.
Källa: habr.com
