

Entry
I den här artikeln kommer jag att prata om den berömda Huffman-algoritmen och dess tillämpning i datakomprimering.
Som ett resultat kommer vi att skriva ett enkelt arkiv. Detta har redan diskuterats men utan praktiskt genomförande. Det teoretiska materialet för den aktuella posten är hämtat från skolans datavetenskapslektioner och Robert Laforets bok "Data Structures and Algorithms in Java". Så, låt oss komma till det!
Några tankar
I en vanlig textfil kodas ett tecken med 8 bitar (ASCII-kodning) eller 16 (Unicode-kodning). Därefter kommer vi att överväga ASCII-kodning. Ta till exempel raden s1 = "SUSIE SÄGER DET ÄR LÄTT". Det finns 22 tecken på en rad, naturligtvis inklusive mellanslag och nyradstecknet 'n'. Filen som innehåller denna rad kommer att väga 22*8 = 176 bitar. Frågan uppstår omedelbart: är det rationellt att använda alla 8 bitar för att koda 1 tecken? Vi använder inte alla ASCII-tecken. Även om de användes skulle det vara mer rationellt att ge den kortaste möjliga koden till den vanligaste bokstaven - S, och att ge en längre kod till den sällsynta bokstaven - T (eller U, eller 'n'). Det här är vad Huffman-algoritmen handlar om: att hitta det optimala kodningsalternativet som ger filen minsta vikt. Det är ganska normalt att olika symboler har olika kodlängd – det är detta som algoritmen bygger på.
kodande
Varför inte ge symbolen 'S' en kod, till exempel med 1 bits längd: 0 eller 1. Låt det vara 1. Låt oss sedan ge den näst vanligaste symbolen - ' ' (mellanslag) - 0. Föreställ dig att du började avkoda ditt meddelande - den kodade strängen s1 - och du ser att koden börjar med 1. Så vad ska du göra: eller är det någon annan symbol, till exempel? Därför uppstår en viktig regel:
Ingen kod ska vara ett prefix till en annan.
Denna regel är nyckeln till algoritmen. Därför börjar skapandet av koden med en frekvenstabell, som anger frekvensen (antal förekomster) för varje symbol:
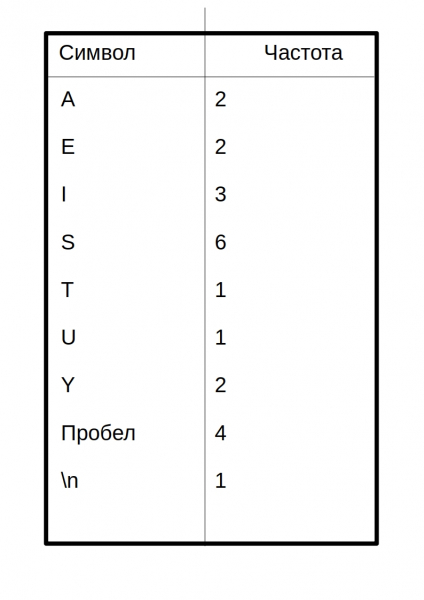 Symboler med flest förekomster bör kodas med minst möjlig antal bitar. Låt mig ge ett exempel på en av de möjliga kodtabellerna:
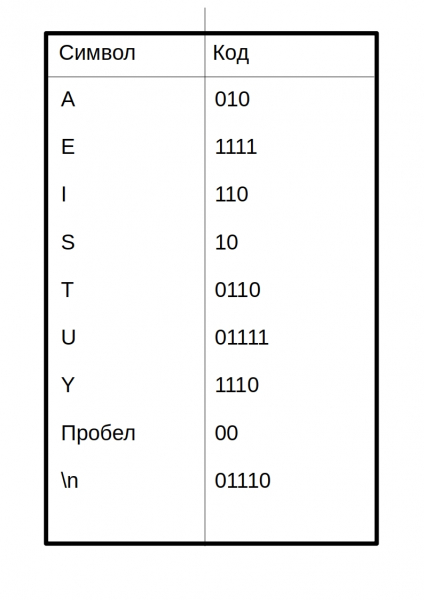 Så det kodade meddelandet kommer att se ut så här:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Jag separerade koden för varje symbol med ett mellanslag. I verkligheten kommer detta inte att hända i en komprimerad fil!
Frågan uppstår: hur kom det här grönhornet på koden för att skapa en kodtabell? Detta kommer att diskuteras nedan.
Att bygga ett Huffman-träd
Det är här binära sökträd kommer till undsättning. Oroa dig inte, du behöver inte söka, infoga och ta bort metoderna här. Här är trädstrukturen i java:
public class Node {
    private int frequence;
    private char letter;
    private Node leftChild;
    private Node rightChild;
    ...
}
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }
    public BinaryTree(Node root) {
        this.root = root;
    }
    ...
}
Detta är inte hela koden, den fullständiga koden kommer att finnas nedan.
Här är algoritmen för att konstruera trädet:
- Skapa ett nodobjekt för varje tecken från meddelandet (rad s1). I vårt fall kommer det att finnas 9 noder (Nodobjekt). Varje nod består av två datafält: symbol och frekvens.
- Skapa ett BinaryTree-objekt för varje nod. Noden blir trädets rot.
- Infoga dessa träd i prioritetskön. Ju lägre frekvens, desto högre prioritet. Vid extrahering väljs alltså alltid trädet med den lägsta frekvensen.
Därefter måste du göra följande cykliskt:
- Ta bort två träd från prioritetskön och gör dem till barn till den nya noden (den nyskapade noden utan bokstav). Frekvensen för den nya noden är lika med summan av frekvenserna för de två efterkommande träden.
- För den här noden skapar du ett träd som är rotat vid denna nod. Infoga detta träd tillbaka i prioritetskön. (Eftersom trädet har en ny frekvens kommer det med största sannolikhet att ta en ny plats i kön)
- Fortsätt steg 1 och 2 tills det bara finns ett träd kvar i kön - Huffman-trädet
Låt oss betrakta denna algoritm på rad s1:
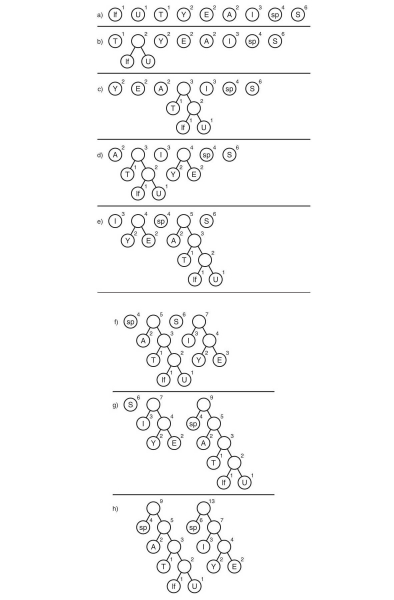
Här betyder symbolen "lf" (linefeed) en ny rad, "sp" (mellanslag) är ett mellanslag.
Och vad är nästa?
Vi har ett Huffman-träd. Okej. Och vad ska man göra med det? De tar det inte gratis heller. Och sedan måste du spåra alla möjliga vägar från roten till trädets löv. Låt oss komma överens om att beteckna en kant som 0 om den leder till vänster ättling och som 1 om den leder till höger ättling. Strängt taget, i dessa notationer, är koden för en symbol vägen från trädets rot till bladet som innehåller just den symbolen.
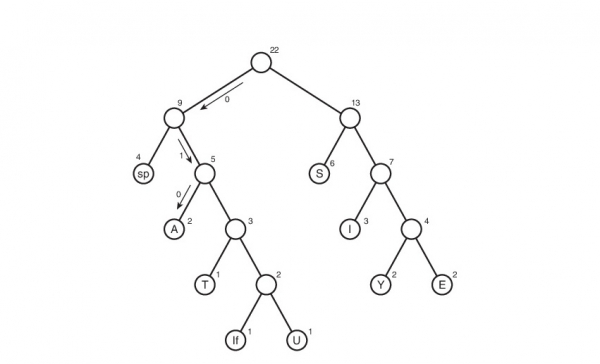
Så här skapades kodtabellen. Observera att om du tittar på den här tabellen kan du dra en slutsats om "vikten" för varje symbol - det här är längden på dess kod. Sedan, i komprimerad form, kommer originalfilen att väga: 2 * 3 + 2*4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bitar. Först vägde den 176 bitar. Därför minskade vi den med så mycket som 176/65 = 2.7 gånger! Men detta är en utopi. En sådan koefficient kommer sannolikt inte att erhållas. Varför? Vi kommer att prata om detta lite senare.
Avkodning
Tja, det enklaste återstår kanske – avkodning. Jag tror att många av er har gissat att vi inte bara kan skapa en komprimerad fil utan några tips om hur den kodades - vi kommer inte att kunna avkoda den! Ja, ja, det var svårt för mig att inse detta, men jag måste skapa en textfil table.txt med komprimeringstabellen:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
Tabellinmatning i formen "symbol" "symbolkod". Varför 01110 utan symbol? Faktum är att det är med en symbol, det är bara så att Java-verktygen som jag använder när jag matar ut till en fil konverterar nyradstecknet - 'n' - till en nyrad (hur dumt det än låter). Därför är den tomma raden högst upp symbolen för koden 01110. För koden 00 är symbolen utrymmet i början av raden. Jag ska genast säga att vår koefficient är skruvad; denna metod för att lagra bordet kan göra anspråk på att vara den mest irrationella. Men det är lätt att förstå och implementera. Jag skulle gärna höra dina rekommendationer i kommentarerna angående optimering.
Med denna tabell är det mycket lätt att avkoda. Låt oss komma ihåg vilken regel vi följde när vi skapade kodningen:
Ingen kod ska vara ett prefix till en annan.
Det är här det spelar en underlättande roll. Vi läser sekventiellt bit för bit, och så snart den resulterande strängen d, som består av de lästa bitarna, matchar kodningen som motsvarar tecknet, vet vi omedelbart att tecknet (och bara det!) kodades. Därefter skriver vi tecken till avkodningssträngen (strängen som innehåller det avkodade meddelandet), nollställer strängen d och fortsätter att läsa den kodade filen.
genomförande
Det är dags att förödmjuka min kod genom att skriva ett arkiv. Låt oss kalla det kompressor.
Låt oss börja från början. Först skriver vi Node-klassen:
public class Node {
    private int frequence;//частота
    private char letter;//буква
    private Node leftChild;//левый потомок
    private Node rightChild;//правый потомок


    public Node(char letter, int frequence) { //собственно, конструктор
        this.letter = letter;
        this.frequence = frequence;
    }

    public Node() {}//перегрузка конструтора для безымянных узлов(см. выше в разделе о построении дерева Хаффмана)
    public void addChild(Node newNode) {//добавить потомка
        if (leftChild == null)//если левый пустой=> правый тоже=> добавляем в левый
            leftChild = newNode;
        else {
            if (leftChild.getFrequence() <= newNode.getFrequence()) //в общем, левым потомком
                rightChild = newNode;//станет тот, у кого меньше частота
            else {
                rightChild = leftChild;
                leftChild = newNode;
            }
        }

        frequence += newNode.getFrequence();//итоговая частота
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public int getFrequence() {
        return frequence;
    }

    public char getLetter() {
        return letter;
    }

    public boolean isLeaf() {//проверка на лист
        return leftChild == null && rightChild == null;
    }
}
Nu trädet:
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }

    public BinaryTree(Node root) {
        this.root = root;
    }

    public int getFrequence() {
        return root.getFrequence();
    }

    public Node getRoot() {
        return root;
    }
}
Prioriterad kö:
import java.util.ArrayList;//да-да, очередь будет на базе списка

class PriorityQueue {
    private ArrayList<BinaryTree> data;//список очереди
    private int nElems;//кол-во элементов в очереди

    public PriorityQueue() {
        data = new ArrayList<BinaryTree>();
        nElems = 0;
    }

    public void insert(BinaryTree newTree) {//вставка
        if (nElems == 0)
            data.add(newTree);
        else {
            for (int i = 0; i < nElems; i++) {
                if (data.get(i).getFrequence() > newTree.getFrequence()) {//если частота вставляемого дерева меньше
                    data.add(i, newTree);//чем част. текущего, то cдвигаем все деревья на позициях справа на 1 ячейку
                    break;//затем ставим новое дерево на позицию текущего
                }
                if (i == nElems - 1)
                    data.add(newTree);
            }
        }
        nElems++;//увеличиваем кол-во элементов на 1
    }

    public BinaryTree remove() {//удаление из очереди
        BinaryTree tmp = data.get(0);//копируем удаляемый элемент
        data.remove(0);//собственно, удаляем
        nElems--;//уменьшаем кол-во элементов на 1
        return tmp;//возвращаем удаленный элемент(элемент с наименьшей частотой)
    }
}
Klass som skapar ett Huffman-träd:
public class HuffmanTree {
    private final byte ENCODING_TABLE_SIZE = 127;//длина кодировочной таблицы
    private String myString;//сообщение
    private BinaryTree huffmanTree;//дерево Хаффмана
    private int[] freqArray;//частотная таблица
    private String[] encodingArray;//кодировочная таблица


    //----------------constructor----------------------
    public HuffmanTree(String newString) {
        myString = newString;

        freqArray = new int[ENCODING_TABLE_SIZE];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = new String[ENCODING_TABLE_SIZE];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    //--------------------frequence array------------------------
    private void fillFrequenceArray() {
        for (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    public int[] getFrequenceArray() {
        return freqArray;
    }

    //------------------------huffman tree creation------------------
    private BinaryTree getHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        //алгоритм описан выше
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {//если символ существует в строке
                Node newNode = new Node((char) i, freqArray[i]);//то создать для него Node
                BinaryTree newTree = new BinaryTree(newNode);//а для Node создать BinaryTree
                pq.insert(newTree);//вставить в очередь
            }
        }

        while (true) {
            BinaryTree tree1 = pq.remove();//извлечь из очереди первое дерево.

            try {
                BinaryTree tree2 = pq.remove();//извлечь из очереди второе дерево

                Node newNode = new Node();//создать новый Node
                newNode.addChild(tree1.getRoot());//сделать его потомками два извлеченных дерева
                newNode.addChild(tree2.getRoot());

                pq.insert(new BinaryTree(newNode);
            } catch (IndexOutOfBoundsException e) {//осталось одно дерево в очереди
                return tree1;
            }
        }
    }

    public BinaryTree getTree() {
        return huffmanTree;
    }

    //-------------------encoding array------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) {//заполнить кодировочную таблицу
        if (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } else {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        return encodingArray;
    }

    public void displayEncodingArray() {//для отладки
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Encoding table====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    //-----------------------------------------------------
    String getOriginalString() {
        return myString;
    }
}
Klass som innehåller som kodar/avkodar:
public class HuffmanOperator {
    private final byte ENCODING_TABLE_SIZE = 127;//длина таблицы
    private HuffmanTree mainHuffmanTree;//дерево Хаффмана (используется только для сжатия)
    private String myString;//исходное сообщение
    private int[] freqArray;//частотаная таблица
    private String[] encodingArray;//кодировочная таблица
    private double ratio;//коэффициент сжатия


    public HuffmanOperator(HuffmanTree MainHuffmanTree) {//for compress
        this.mainHuffmanTree = MainHuffmanTree;

        myString = mainHuffmanTree.getOriginalString();

        encodingArray = mainHuffmanTree.getEncodingArray();

        freqArray = mainHuffmanTree.getFrequenceArray();
    }

    public HuffmanOperator() {}//for extract;

    //---------------------------------------compression-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermidiate = "";//промежуточная строка(без добавочных нулей)
        //System.out.println("=============================Compression=======================");
        //displayEncodingArray();
        for (int i = 0; i < myString.length(); i++) {
            intermidiate += encodingArray[myString.charAt(i)];
        }
        //Мы не можем писать бит в файл. Поэтому нужно сделать длину сообщения кратной 8=>
        //нужно добавить нули в конец(можно 1, нет разницы)
        byte counter = 0;//количество добавленных в конец нулей (байта в полне хватит: 0<=counter<8<127)
        for (int length = intermidiate.length(), delta = 8 - length % 8;
        		counter < delta ; counter++) {//delta - количество добавленных нулей
            intermidiate += "0";
        }

        //склеить кол-во добавочных нулей в бинарном предаствлении и промежуточную строку
        compressed = String.format("%8s", Integer.toBinaryString(counter & 0xff)).replace(" ", "0") + intermidiate;

        //идеализированный коэффициент
        setCompressionRatio();
        //System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() {//посчитать идеализированный коэффициент
        double sumA = 0, sumB = 0;//A-the original sum
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                sumA += 8 * freqArray[i];
                sumB += encodingArray[i].length() * freqArray[i];
            }
        }
        ratio = sumA / sumB;
    }

    public byte[] getBytedMsg() {//final compression
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] compressedBytes = new byte[compressedString.length() / 8];
        for (int i = 0; i < compressedBytes.length; i++) {
                compressedBytes[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return compressedBytes;
    }
    //---------------------------------------end of compression----------------------------------------------------------------
    //------------------------------------------------------------extract-----------------------------------------------------
    public String extract(String compressed, String[] newEncodingArray) {
        String decompressed = "";
        String current = "";
        String delta = "";
        encodingArray = newEncodingArray;

        //displayEncodingArray();
        //получить кол-во вставленных нулей
        for (int i = 0; i < 8; i++)
        	delta += compressed.charAt(i);
        int ADDED_ZEROES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ADDED_ZEROES; i < l; i++) {
            //i = 8, т.к. первым байтом у нас идет кол-во вставленных нулей
            current += compressed.charAt(i);
            for (int j = 0; j < ENCODING_TABLE_SIZE; j++) {
                if (current.equals(encodingArray[j])) {//если совпало
                    decompressed += (char)j;//то добавляем элемент
                    current = "";//и обнуляем текущую строку
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
    	for (int i = 0; i < encodingArray.length; i++) {
        	if (freqArray[i] != 0)
        		enc += (char)i + encodingArray[i] + 'n';
        }
    	return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }


    public void displayEncodingArray() {//для отладки
        System.out.println("======================Encoding table====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            //if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            //}
        }
        System.out.println("========================================================");
    }
    }
En klass som gör det lättare att skriva till en fil:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Неверный путь, или такого файла не существует!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
En klass som gör det lättare att läsa från en fil:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1)//если закончился файл
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
Tja, och huvudklassen:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try {//указываем инструкцию с помощью аргументов командной строки
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Неверный формат ввода аргументов ");
            System.out.println("Читайте Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List<String> stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Неверный путь, или такого файла не существует!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("Текущая кодировка файла не поддерживается");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        //create file with encoding table:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Путь к сжатому файлу: " + compressedFile.getAbsolutePath());
        System.out.println("Путь к кодировочной таблице " + table.getAbsolutePath());
        System.out.println("Без таблицы файл будет невозможно извлечь!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100;//идеализированный коэффициент
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100;//настоящий коэффициент

        System.out.println("Идеализированный коэффициент сжатия равен " + idealRatio);
        System.out.println("Коэффициент сжатия с учетом кодировочной таблицы " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        //read compressed file
        //!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!check here:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte();//method returns EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        //--------------------

        //read encoding table:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine();//skip first empty string
        	encodingArray[(byte)'n'] = fi.readLine();//read code for 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        //extract:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Путь к распакованному файлу " + extractedFile.getAbsolutePath());
    }
}
Du måste själv skriva filen readme.txt med instruktioner :)
Slutsats
Jag antar att det var allt jag ville säga. Om du har något att säga om min inkompetens i att förbättra koden, algoritmen eller någon optimering i allmänhet, skriv gärna. Om jag inte förklarade något, skriv till mig också. Jag vill gärna höra från dig i kommentarerna!
PS
Ja, ja, jag är fortfarande här, för jag har inte glömt koefficienten. För s1-raden väger kodningstabellen 48 byte - mycket mer än originalfilen, och vi glömde inte bort de extra nollorna (antalet adderade nollor är 7) => komprimeringsförhållandet kommer att vara mindre än ett: 176/(65 + 48*8 + 7) = 0.38. Om du också märkte detta, så är det inte bara ditt ansikte som är bra. Ja, den här implementeringen kommer att vara extremt ineffektiv för små filer. Men vad händer med stora filer? Filstorleken är mycket större än kodningstabellens storlek. Det är här algoritmen fungerar som den ska! Till exempel för arkiveraren ger en verklig (inte idealiserad) koefficient lika med 1.46 - nästan en och en halv gång! Och ja, filen skulle vara på engelska.
Källa: will.com
