

Hej allihopa, vi delar med er den andra delen av publikationen "Virtuella filsystem i LinuxVarför behövs de och hur fungerar de? Den första delen kan läsas . Låt oss påminna dig om att denna serie av publikationer är tidsinställd att sammanfalla med lanseringen av en ny kursström , som börjar mycket snart.
Hur man övervakar VFS med eBPF och bcc-verktyg
Det enklaste sättet att förstå hur kärnan hanterar filer sysfs – är att se det i praktiken, och det enklaste sättet att observera ARM64 är att använda eBPF. eBPF (förkortning för Berkeley Packet Filter) består av en virtuell maskin som körs in , som privilegierade användare kan begära (query) från kommandoraden. Kärnkällorna talar om för läsaren vad kärnan kan göra; Att köra eBPF-verktyg på ett uppstartat system avslöjar vad kärnan faktiskt gör.
Lyckligtvis är det ganska enkelt att komma igång med eBPF med verktyg , som är tillgängliga som paket från den allmänna distributionen och dokumenterat i detalj . Verktyg bcc – det här är Python-skript med små insatser av C-kod, vilket innebär att alla som är bekanta med båda språken enkelt kan ändra dem. I bcc/tools Det finns 80 Python-skript, vilket betyder att en utvecklare eller systemadministratör med största sannolikhet kommer att kunna hitta något som passar för att lösa ett problem.
För att få åtminstone en översiktlig uppfattning om vilken typ av arbete VFS gör i ett körande system, försök vfscount eller vfsstat. Detta kommer att visa, låt oss säga, att dussintals samtal vfs_open() och "hans vänner" händer bokstavligen varje sekund.
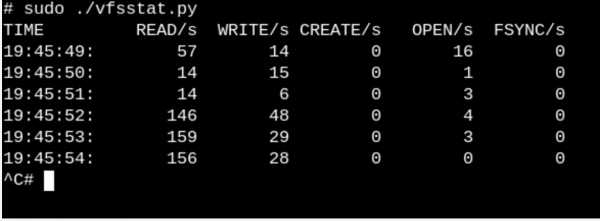
vfsstat.py– detta är ett Python-skript med C-kodinlägg som helt enkelt räknar VFS-funktionsanrop.
Låt oss ta ett mer trivialt exempel och se vad som händer när vi sätter in ett USB-minne i en dator och systemet upptäcker det.
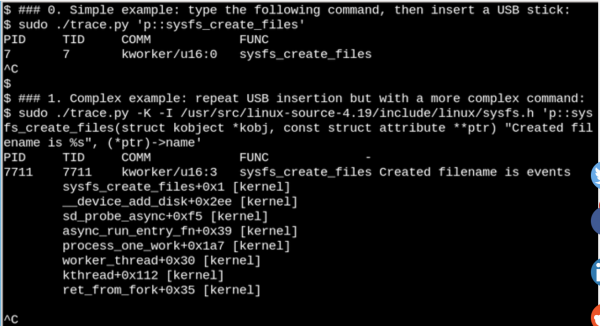
Med eBPF kan du se vad som händer i
/sys, när ett USB-minne är isatt. Ett enkelt och komplext exempel visas här.
I exemplet ovan, bcc инструмент skriver ut ett meddelande när kommandot körs sysfs_create_files(). Det ser vi sysfs_create_files() lanserades med hjälp av kworker stream som svar på det faktum att flashenheten sattes in, men vilken fil skapades? Det andra exemplet visar den fulla kraften hos eBPF. Här trace.py skriver ut kärnans bakåtspårning (alternativ -K) och namnet på filen som skapades sysfs_create_files(). Infogning av en enstaka påstående är C-kod som innehåller en lätt igenkännlig formatsträng som tillhandahålls av ett Python-skript som kör LLVM just-in-time kompilator. Den kompilerar den här raden och kör den i en virtuell maskin inuti kärnan. Full funktionssignatur sysfs_create_files () måste återges i det andra kommandot så att formatsträngen kan referera till en av parametrarna. Fel i detta C-kodfragment resulterar i igenkännliga C-kompilatorfel. Till exempel, om parametern -l saknas, kommer du att se "Det gick inte att kompilera BPF-text." Utvecklare som är bekanta med C och Python kommer att hitta verktyg bcc lätt att bygga ut och ändra.
När USB-minnet är isatt kommer kärnans bakåtspårning att visa att PID 7711 är tråden kworker, som skapade filen «events» в sysfs. Följaktligen är uppmaningen sysfs_remove_files() kommer att visa att borttagning av enheten resulterade i att filen raderades events, vilket överensstämmer med det allmänna begreppet referensräkning. Samtidigt tittar sysfs_create_link () med eBPF när du sätter i ett USB-minne kommer det att visa att minst 48 symboliska länkar har skapats.
Så vad är poängen med händelsefilen? Användande för sökning , visar att det orsakar disk_add_events (), och antingen "media_change"Eller "eject_request" kan skrivas till händelsefilen. Här informerar kärnblockslagret användarutrymmet om utseendet och borttagningen av "disken". Lägg märke till hur informativ denna undersökningsmetod är baserad på att sätta i ett USB-minne, jämfört med att försöka ta reda på hur saker och ting fungerar utifrån källkoden enbart.
Läsbara rotfilsystem gör inbäddade enheter möjliga
Naturligtvis stänger ingen av en server eller sin dator genom att dra ut kontakten ur uttaget. Men varför? Detta beror på att monterade filsystem på fysiska lagringsenheter kan ha fördröjda skrivningar, och de datastrukturer som registrerar deras tillstånd kanske inte är synkroniserade med posterna i lagringen. När detta händer måste systemägare vänta tills nästa start för att köra verktyget. fsck filesystem-recovery och i värsta fall förlora data.
Vi vet dock alla att många IoT-enheter, såväl som routrar, termostater och bilar, nu körs på LinuxMånga av dessa enheter har praktiskt taget inget användargränssnitt, och det finns inget sätt att stänga av dem ordentligt. Tänk dig att starta en bil med ett dött batteri när strömmen till styrenheten bryts. ständigt hoppa upp och ner. Hur kommer det sig att systemet startar utan en lång tid fsck, när börjar motorn äntligen fungera? Och svaret är enkelt. Inbäddade enheter är beroende av rotfilsystemet (förkortat ro-rootfs (skrivskyddat rotfilsystem)).
ro-rootfs erbjuder många fördelar som är mindre uppenbara än äkta. En av fördelarna är att skadlig programvara inte kan skriva till /usr eller /lib, om ingen process Linux kan inte skriva till den. En annan är att ett i stort sett oföränderligt filsystem är avgörande för fältsupport av fjärrenheter, eftersom supportpersonal använder lokala system som nominellt är identiska med systemen på plats. Den kanske viktigaste (men också mest lömska) fördelen är att ro-rootfs tvingar utvecklare att bestämma vilka systemobjekt som ska vara oföränderliga tidigt i systemdesignen. Att arbeta med ro-rootfs kan vara besvärligt och smärtsamt, vilket ofta är fallet med const-variabler i programmeringsspråk, men fördelarna överväger vida den extra kostnaden.
skapande rootfs Skrivskyddad funktionalitet kräver lite extra ansträngning för inbäddade utvecklare, och det är här VFS kommer in i bilden. Linux kräver att filer i /var var skrivbara, och dessutom kommer många populära applikationer som körs på inbäddade system att försöka skapa konfiguration dot-files в $HOME. En lösning för konfigurationsfiler i hemkatalogen är vanligtvis att förgenerera dem och bygga in dem rootfs. För /var en möjlig metod är att montera den på en separat skrivbar partition medan / monterad skrivskyddad. Ett annat populärt alternativ är att använda bind- eller överlagringsfästen.
Bindbara och stapelbara fästen och deras användning av containrar
Utför kommandot man mount – det bästa sättet att lära sig om länkbara och staplingsbara monteringar, som gör det möjligt för utvecklare och systemadministratörer att skapa ett filsystem på en väg och sedan exponera det för applikationer i en annan. För inbäddade system innebär detta möjligheten att lagra filer i /var på en skrivskyddad flashenhet, men ett överlägg eller länkfäste av sökvägen från tmpfs в /var När du laddar kommer det att tillåta applikationer att skriva anteckningar där (scrawla). Nästa gång du slår på ändringarna in /var kommer att gå förlorad. Ett överläggsfäste skapar en förening mellan tmpfs och det underliggande filsystemet och låter dig göra ändringar i befintliga filer i ro-tootf medan ett länkbart fäste kan göra nya tomma tmpfs mappar som är synliga som skrivbara i ro-rootfs vägar. Medan overlayfs detta är korrekt (proper) filsystemstyp, länkbar montering implementeras i .
Baserat på beskrivningen av överlägg och länkfästen är ingen förvånad över det de används aktivt. Låt oss se vad som händer när vi använder för att köra behållaren med hjälp av verktyget mountsnoop från bcc.
samtal system-nspawn startar behållaren under drift mountsnoop.py.
Låt oss se vad som hände:
Запуск mountsnoop under container "boot" visar att containerns körtid är starkt beroende av det bindbara fästet (endast början av den långa utgången visas).
Här systemd-nspawn tillhandahåller de valda filerna procfs и sysfs värd i container som vägar i den rootfs... Förutom MS_BIND flaggan som ställer in bindningsmonteringen, vissa andra flaggor i monteringen bestämmer förhållandet mellan ändringar i värd- och containernamnrymden. Till exempel kan en bindmontering antingen hoppa över ändringar till /proc и /sys i en container, eller dölj dem beroende på samtalet.
Slutsats
Att förstå den interna strukturen Linux kan verka som en omöjlig uppgift, eftersom kärnan i sig innehåller en enorm mängd kod, bortsett från användarutrymmesapplikationer Linux och systemanropsgränssnitt i C-bibliotek som glibc. Ett sätt att göra framsteg är att läsa källkoden för ett kärndelsystem, med tonvikt på att förstå systemanrop och rubriker som möter användarutrymmet, såväl som de viktigaste interna kärngränssnitten, såsom tabellen file_operations. Filoperationer tillämpar principen "allt är en fil", vilket gör dem särskilt trevliga att hantera. Kernel C-källfiler i katalogen på översta nivån fs/ representerar en implementering av virtuella filsystem, vilka är ett omslagslager som ger bred och relativt enkel kompatibilitet mellan populära filsystem och lagringsenheter. Montering med länkning och överlagring via namnrymder Linux — är magin med VFS som gör det möjligt att skapa containrar och skrivskyddade rotfilsystem. Kombinerat med en studie av källkoden, kärnverktyget eBPF och dess gränssnitt bcc
gör kärnutforskning enklare än någonsin.
Vänner, låt mig veta om den här artikeln var till hjälp för er. Kanske har ni några kommentarer eller förslag? Och för er som är intresserade av kursen "Administratör", Linux", vi inbjuder dig att , som äger rum den 18 april.
Källa: will.com
