

Denna anteckning kommer att vara intressant för dem som använder databehandlingsbiblioteket för R — data.table, och kanske kommer att glädja sig över flexibiliteten i dess tillämpning på olika exempel.
Inspirerad av ett bra exempel , och hoppades att du redan har läst hans artikel, föreslår jag att vi gräver djupare i optimering av kod och prestanda baserat på data.table.
Inledning: Varifrån kommer data.table?
Det är bäst att börja bekanta sig med biblioteket något på avstånd, nämligen med datatyperna som kan generera ett data.table-objekt (hädanefter, DT).
Array
Kod
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
En sådan struktur är en array (?base::array). Precis som i andra språk är arrayer här flerdimensionella. Det intressanta är att till exempel en tvådimensionell array börjar ärva egenskaper från klassen matris (?base::matrix), medan en endimensionell array, vilket också är viktigt, inte ärver från vektorn (?base::vector).
Därför är det viktigt att förstå att datatypen som finns i ett objekt bör kontrolleras med funktionen base::typeof, som returnerar en intern beskrivning av typen enligt R Internals — det allmänna protokollet för språket som är relaterat till den ursprungliga C.
En annan kommando för att bestämma klass av ett objekt, base::class, returnerar vid vektorer vektor-typen (den har ett annat namn än den interna, men gör det också möjligt att förstå datatypen).
Lista
Från en tvådimensionell array, vilken också är en matris, kan man gå vidare till en lista (?base::list).
Kod
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Flertalet saker händer samtidigt:
- Det andra måttet av matrisen komprimeras, vilket innebär att vi får både en lista och en vektor.
- Listan är såledesverksamm av dessa klasser. Det är viktigt att ha i åtanke att ett list-element kommer att motsvara ett (skalar) värde från matrisens array-cell.
Tack vare att listan också är en vektor kan vissa funktioner för vektorer tillämpas på den.
Dataframe
Från en lista, matris eller vektor kan man övergå till en dataframe (?base::data.frame).
Kod
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Vad som är intressant i den: en dataframe ärver från en lista! Kolumnerna i dataframen är celler i listan. Detta kommer att vara viktigt senare när vi använder funktioner som tillämpas på listor.
data.table
En DT (?data.table::data.table) kan skapas från dataframe, lista, vektor eller matris. Till exempel så här (in place).
Kod
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Det är användbart att, precis som en dataframe, DT ärver egenskaper från en lista.
DT och minne
Till skillnad från alla andra objekt i R-bas, överförs DT via referens. Om du behöver göra en kopia i ett nytt minnesområde krävs en funktion data.table::copy eller så måste du göra ett urval från det gamla objektet.
Kod
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Med detta avslutas introduktionen. DT är en fortsättning på utvecklingen av datatyper i R, som främst sker genom att utöka och snabba upp operationer som utförs på objekt av dataram-klass. Samtidigt bevaras ärvandet från andra primitiva typer.
Några exempel på användning av egenskaperna hos data.table
Som en lista…
Att iterera över raderna i en dataram eller DT är inte den bästa idén, eftersom loopkoden på språket R är mycket långsammare C, men att iterera över kolumner, som vanligtvis är betydligt färre, går bra. När man går igenom kolumnerna, kom ihåg att varje kolumn är ett element i en lista som vanligtvis innehåller en vektor. Och operationer på vektorer är väl vektoriserade i grundläggande funktioner i språket. Det går också att använda urvalsomoperatorer som är typiska för listor och vektorer: `[[`, `$`.
Kod
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vektorisering
Om det finns ett behov av att gå igenom raderna i en stor DT, är den bästa lösningen att skriva en funktion med vektorisering. Men om detta inte är möjligt, kom ihåg att loopen inuti DT fortfarande är snabbare än loopen i R, eftersom den körs på C.
Låt oss prova med ett större exempel med 100K rader. Vi kommer att extrahera den första bokstaven från ord som ingår i vektor-kolumnen — kolumnvektorer, och $inline$(.)^H$inline$ är operationen.
Uppdaterad
Kod
library(magrittr)
library(microbenchmark)

## Större exempel ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vektorisering

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# andra

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# tredje

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Första körningen med iteration över rader:
Enhet: millisekunder
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
Den andra genomkörningen, där vektoriseringsprocessen sker genom att omvandla en lista till en matris och ta element vid skärningspunkten med index 1 (detta är själva vektoriseringen). Jag rättar mig: vektoriseringen på funktionsnivå. strsplit, som kan ta en vektor som indata. Det visar sig att proceduren för att omvandla en lista till en matris är mycket tyngre än själva vektoriseringen, men i det här fallet är det fortfarande mycket snabbare än den icke-vektoriserade varianten.
Enhet: millisekunder
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Fördjupning baserad på medianen i 3 gånger.
Den tredje genomkörningen, där schemat för att omvandla till matris har ändrats.
Enhet: millisekunder
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Fördjupning baserad på medianen i 13 gånger.
Med detta måste man experimentera, ju mer ju bättre blir det.
Ytterligare ett exempel på vektorisering, där även text ingår, men det är närmare verkliga förhållanden: olika längder på orden, olika antal ord. Det krävs att man hämtar de tre första orden. Så här:
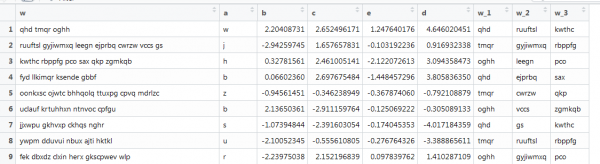
Här fungerar inte den tidigare funktionen längre, eftersom vektorerna har olika längder och vi angav storleken på matrisen. Vi tar om detta genom att gräva i internet.
Kod
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Enhet: millisekunder
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Skriptet kördes med en genomsnittlig hastighet på 1 sekund. Inte dåligt.
Länkade som en kedja...
Med DT-objekt kan man arbeta med hjälp av chaining. Det ser ut som om man fäster klamrar på höger sida, i princip en sockerbit.
Kod
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Rinner genom rören...
Samma operationer kan göras genom piping, ser liknande ut, men funktionellt rikare, eftersom man kan använda alla metoder, inte bara DT. Vi kommer att visa koefficienterna för logistisk regression för våra syntetiska data med ett antal filter på DT.
Kod
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Statistik, maskininlärning och annat inom DT
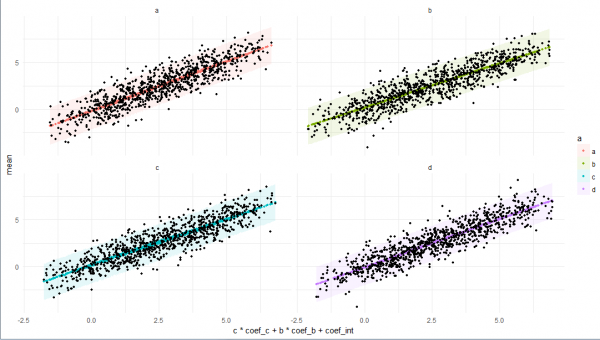
Man kan använda lambda-funktioner, men ibland är det bättre att skapa dem separat, skriva hela pipelinen för dataanalys, och sedan framåt — de fungerar inom DT. Exemplet är berikat med alla ovan nämnda funktioner, plus några användbara saker från DT:s arsenal (såsom att adressera DT inom DT via länk, ibland inte i ordning, men för att det ska funka).
Kod
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Slutsats
Jag hoppas att jag har kunnat skapa en sammanhängande, men självklart inte fullständig, bild av ett objekt som data.table, från dess egenskaper kopplade till arv från R-klasser till dess egna funktioner och omgivning av tidyverse-element. Jag hoppas detta hjälper dig att förstå och använda detta bibliotek bättre för arbete och nöje.
Tack!
Fullständig kod
Kod
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Källa: habr.com
