

TL; DR: JSONB kan avsevärt förenkla utvecklingen av databasstrukturer utan att kompromissa med prestanda i frågorna.
Introduktion
Låt oss ge ett klassiskt exempel, troligen en av de äldsta användningarna i världen av relationsdatabaser (databaser): vi har en entitet och behöver spara specifika egenskaper (attribut) för denna entitet. Men inte alla instanser kan ha samma uppsättning egenskaper, och dessutom kan det i framtiden finnas behov av att lägga till fler egenskaper.
Det enklaste sättet att lösa detta problem är att skapa en kolumn i databastabellen för varje värde av egenskapen och helt enkelt fylla i de som behövs för den specifika instansen av entiteten. Utmärkt! Problemet löst... tills dess att din tabell innehåller miljontals poster och du plötsligt behöver lägga till en ny post.
Låt oss överväga EAV-mönstret (), som förekommer ganska ofta. En tabell innehåller entiteter (poster), en annan tabell innehåller namnen på egenskaper (attribut), och en tredje tabell kopplar entiteter till deras attribut och innehåller värdet av dessa attribut för den aktuella entiteten. Detta ger dig möjlighet att ha olika uppsättningar egenskaper för olika objekt, samt att lägga till egenskaper "on the fly" utan att förändra databasstrukturen.
Trots detta skulle jag inte ha skrivit denna anteckning om det inte fanns nackdelar med att använda EAV. Till exempel, för att hämta en eller flera entiteter som har 1 attribut, krävs det 2 joinar i frågan: den första – en sammanslagning med attributtabellen, den andra – en sammanslagning med värdestabellen. Om entiteten har 2 attribut krävs det redan 4 joinar! Dessutom lagras alla attribut vanligtvis som strängar, vilket leder till typkonvertering både för resultatet och för WHERE-villkoret. Om du skriver många frågor är det ganska resurskrävande.
Trots dessa uppenbara nackdelar, har EAV länge använts för att lösa den här typen av problem. Det har varit oundvikliga nackdelar, och det har helt enkelt inte funnits någon bättre alternativ.
Men sedan dök en ny "teknologi" upp i PostgreSQL...
Sedan PostgreSQL 9.4 lades datatypen JSONB till för att lagra binära JSON-data. Även om lagring av JSON i detta format vanligtvis tar lite mer utrymme och tid jämfört med enkel textbaserad JSON, går operationer med det mycket snabbare. JSONB stöder också indexering, vilket gör förfrågningar ännu snabbare.
Datatypen JSONB möjliggör att vi kan ersätta det omfattande EAV-mönstret genom att lägga till endast en JSONB-kolumn i vår entitetstabell, vilket förenklar databasdesignen avsevärt. Men många hävdar att detta bör åtföljas av prestandanedgång... Det är just här denna artikel kommer in.
Inställning av testdatabas
För denna jämförelse skapade jag en databas på en ny installation av PostgreSQL 9.5 på en 80-dollarsuppsättning Ubuntu 14.04. Efter att ha justerat vissa parametrar i postgresql.conf körde jag ett skript med hjälp av psql. För att representera data i EAV-format skapades följande tabeller:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
Nedan finns en tabell där samma data kommer att lagras, men med attribut i en JSONB-kolumn – properties.
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Ser mycket enklare ut, eller hur? Sedan lades 10 miljoner poster till i entitetstabellerna (entity & entity_jsonb) och motsvarande fyllts med samma data i tabellerna där EAV-mönstret används och tillvägagångssättet med JSONB-kolumnen – entity_jsonb.properties. Således fick vi flera olika datatyper bland hela uppsättningen av egenskaper. Exempeldata:
{
  id:          1
  name:        "Entity1"
  description: "Test entity no. 1"
  properties:  {
    color:        "red"
    length:       120
    width:        3.1882420
    hassomething: true
    country:      "Belgium"
  }
}
Så, nu har vi samma data för två alternativ. Låt oss börja jämföra implementationerna i arbete!
Förenkling av design
Det har redan nämnts att databasdesignen har förenklats avsevärt: en tabell, tack vare användningen av en JSONB-kolumn för egenskaper, istället för att använda tre tabeller för EAV. Men hur påverkar detta förfrågningarna? Uppdatering av en egenskap för en entitet ser ut som följer:
-- EAV
UPDATE entity_attribute_value
SET value = 'blå'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"color"}', '"blå"')
WHERE id = 120;
Som vi ser, ser inte den sista frågan enklare ut. För att uppdatera egenskapsvärdet i JSONB-objektet måste vi använda funktionen , och vi måste skicka vårt nya värde som ett JSONB-objekt. Å andra sidan behöver vi inte veta något identifierare i förväg. Tittar vi på exemplet med EAV behöver vi både entity_id och entity_attribute_id för att utföra uppdateringen. Om du vill uppdatera en egenskap i JSONB-kolumnen baserat på objektets namn, så görs detta med en enkel rad.
Låt oss nu välja den entitet vi just uppdaterade baserat på dess nya färg:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'color' AND eav.value = 'blå';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'color' = 'blå';
Jag tror vi kan enas om att det andra är kortare (utan join!), och därmed mer läsbart. Här vinner JSONB! Vi använder JSON-operatören ->> för att få färgen som ett textvärde från JSONB-objektet. Det finns också ett andra sätt att uppnå samma resultat i JSONB-modellen med operatören @> :
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"color": "blå"}';
Detta är lite mer komplicerat: vi kontrollerar om JSON-objektet i kolumnens egenskaper innehåller objektet som finns till höger om operatören @>. Mindre läsbart, mer effektivt (se nedan).
Låt oss förenkla användningen av JSONB ännu mer när du behöver välja flera egenskaper samtidigt. Här passar verkligen JSONB-ansatsen: vi väljer helt enkelt egenskaper som extra kolumner i vår resultatuppsättning utan behov av joins:
-- JSONB
SELECT name
  , properties ->> 'color'
  , properties ->> 'country'
FROM entity_jsonb
WHERE id = 120;
Med EAV behöver du 2 joins för varje egenskap som du vill fråga. Enligt min mening visar ovanstående frågor en stor förenkling i databasdesignen. Du kan även se fler exempel på hur man skriver frågor mot JSONB i inlägget.
Nu är det dags att prata om prestanda.
Performance
För att jämföra prestanda använde jag i förfrågningar, för att beräkna exekveringstiden. Varje förfrågan kördes minst tre gånger, eftersom planeringsverktyget kräver mer tid första gången. Först utförde jag förfrågningarna utan några index. Uppenbarligen gav detta JSONB en fördel, eftersom joins som behövs för EAV inte kunde använda index (fälten med främmande nycklar var inte indexerade). Efter detta skapade jag ett index för två kolumner av främmande nycklar i EAV-värdestabellen, samt ett index för JSONB-kolumnen.
Uppdateringar av data visade följande resultat för tiden (i ms). Observera att skalan är logaritmisk:
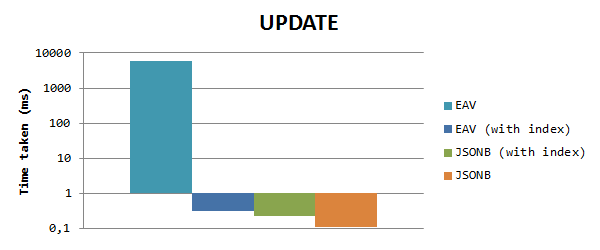
Vi ser att JSONB är mycket (> 50000 gånger) snabbare än EAV när index inte används, av anledningen som nämndes ovan. När vi indexerar kolumner med primära nycklar försvinner nästan skillnaden, men JSONB är fortfarande 1,3 gånger snabbare än EAV. Observera att indexet för JSONB-kolumnen här inte har någon påverkan, eftersom vi inte använder egenskapskolumnen i utvärderingskriterierna.
För att hämta data baserat på ett egenskapsvärde får vi följande resultat (normal skala):
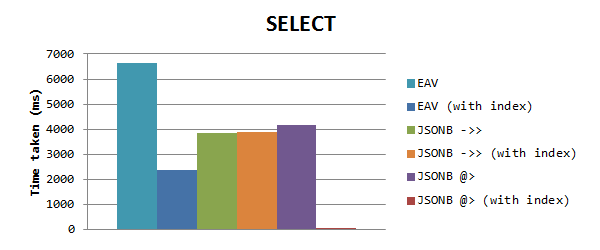
Det är tydligt att JSONB återigen fungerar snabbare än EAV utan index, men när EAV har index är den fortfarande snabbare än JSONB. Men sedan såg jag att tiden för JSONB-förfrågningarna var densamma, vilket ledde mig till insikten att GIN-indexet inte aktiveras. Uppenbarligen, när du använder GIN-index för en kolumn med fyllda egenskaper, fungerar det bara vid användning av inklusionsoperatorn @>. Jag använde detta i ett nytt test, vilket hade en enorm påverkan på tiden: endast 0,153 ms! Det är 15000 gånger snabbare än EAV och 25000 gånger snabbare än operatorn ->>.
Jag tycker att det var tillräckligt snabbt!
Storleken på databastabeller
Låt oss jämföra storlekarna på tabellerna med båda metoderna. I psql kan vi visa storleken för alla tabeller och index genom att använda kommandot dti+
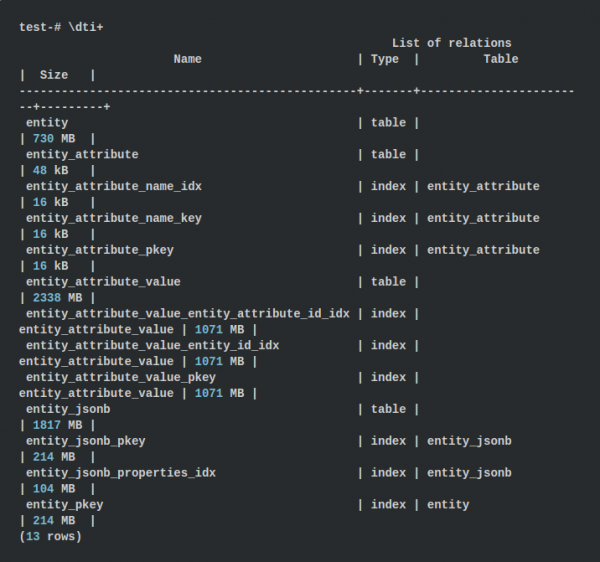
För EAV-metoden är storleken på tabellerna cirka 3068 MB och indexen upp till 3427 MB, vilket ger totalt 6,43 GB. Vid användning av JSONB-metoden används 1817 MB för tabellen och 318 MB för indexen, vilket innebär 2,08 GB. Det blir tre gånger mindre! Denna siffra överraskade mig något, eftersom vi lagrar namnen på egenskaperna i varje JSONB-objekt.
Men siffrorna talar för sig själva: i EAV lagrar vi 2 heltal externa nycklar för attributets värde, vilket resulterar i 8 byte ytterligare data. Dessutom lagras alla egenskapsvärden i EAV i text, medan JSONB kommer att använda numeriska och logiska värden inom de områden där det är möjligt, vilket ger en mindre datastorlek.
Sammanfattning
Generellt sett anser jag att lagringen av entitets egenskaper i JSONB-formatet kan förenkla design och underhåll av din databas avsevärt. Om du utför många frågor, kommer allt som lagras i en tabell med entiteten verkligen att fungera mer effektivt. Och det faktum att det underlättar interaktionen mellan data är redan en fördel, men den resulterande databasen är tre gånger mindre i storlek.
Dessutom, baserat på genomförda tester kan slutsatsen dras att prestandaförlusterna är mycket obetydliga. I vissa fall fungerar JSONB till och med snabbare än EAV, vilket gör det ännu bättre. Men detta referenstest täcker givetvis inte alla aspekter (t.ex. entiteter med mycket stora egenskaper, en betydande ökning av antalet egenskaper för existerande data,...), så om du har några förslag på hur de kan förbättras, tveka inte att lämna en kommentar!
Källa: habr.com
