

V tomto článku popíšu situaci, která se nedávno stala s jedním z našich cloudových VPS serverů a která mě na několik hodin zaskočila. Konfiguraci a řešení problémů se servery věnuji asi 15 let. Linux, ale tento případ vůbec nezapadá do mé praxe - učinil jsem několik mylných předpokladů a byl jsem trochu zoufalý, než se mi podařilo správně identifikovat příčinu problému a vyřešit ji.
Preambule
Provozujeme středně velký cloud, který stavíme na standardních serverech s následující konfigurací: 32 jader, 256 GB RAM a 4TB PCI-E disk Intel P4500 NVMe. Tato konfigurace se nám opravdu líbí, protože eliminuje potřebu I/O operací zajištěním správného throttlingu na úrovni instance virtuálního stroje. Protože Intel NVMe... Má působivý výkon, dokážeme současně poskytovat jak plné IOPS provisioning pro stroje, tak i zálohovací úložiště pro záložní server s nulovým IOWAIT.
Patříme mezi ty staromódní, kteří nepoužívají hyperkonvergované SDN ani jiné trendy, módní a mladistvé vychytávky k ukládání svazků virtuálních strojů, protože věří, že čím jednodušší systém, tím snazší je řešení problémů, když „hlavní guru odjel do hor“. V důsledku toho ukládáme svazky virtuálních strojů ve formátu QCOW2 na XFS nebo EXT4, který je nasazen nad LVM2.
K používání QCOW2 nás nutí i produkt, který používáme pro orchestraci – Apache CloudStack.
Pro provedení zálohy vytvoříme kompletní obraz svazku jako snapshot LVM2 (ano, víme, že snapshoty LVM2 jsou pomalé, ale i zde nám Intel P4500 pomáhá). lvmcreate -s .. a s pomocí dd Zálohu odesíláme na vzdálený server s úložištěm ZFS. Zde jsme trochu progresivní – ZFS dokáže ukládat data v komprimované podobě a my je můžeme rychle obnovit pomocí DD nebo extrahovat jednotlivé svazky virtuálních počítačů pomocí mount -o loop ....
Samozřejmě můžete pořídit neúplný obraz svazku LVM2, ale připojit souborový systém v režimu
ROa zkopírovat samotné obrazy QCOW2. Setkali jsme se však se situacemi, kdy to způsobilo selhání XFS, ne okamžitě, ale nečekaně. Opravdu se nám nelíbí, když hypervizorové hostitele náhle zamrznou o víkendech, v noci nebo během svátků kvůli chybám, které se vyskytnou v neznámém čase. Proto pro XFS nepoužíváme montáž snapshotů.ROextrahovat svazky, ale jednoduše zkopírovat celý svazek LVM2.
V našem případě je rychlost zálohování na záložní server určena výkonem zálohovacího serveru, který je pro nekomprimovatelná data přibližně 600–800 MB/s. Dalším omezením je kanál 10 Gbit/s, který propojuje záložní server s clusterem.
Zároveň se na jeden zálohovací server nahrává 8 záložních kopií současně. servery Hypervizory. Diskové a síťové subsystémy zálohovacího serveru jsou sice pomalejší, ale zabraňují přetížení diskových subsystémů hostitelů hypervizoru, protože ty jednoduše nejsou schopny zvládnout řekněme 8 GB/s, což hostitelé hypervizoru snadno zvládnou.
Výše uvedený proces kopírování je velmi důležitý pro další příběh, včetně detailů - použití rychlého disku Intel P4500, použití NFS a pravděpodobně i použití ZFS.
Historie zálohování
Na každém hypervisorovém uzlu máme malý swap oddíl o velikosti 8 GB a samotný hypervisorový uzel „rozbalíme“ pomocí DD Z hlavního obrazu. Pro systémový svazek na serverech používáme 2xSATA SSD RAID1 nebo 2xSAS HDD RAID1 na hardwarovém řadiči LSI nebo HP. V podstatě nám nezáleží na tom, co je uvnitř, protože systémový svazek pracuje v režimu „téměř jen pro čtení“, s výjimkou swapu. A protože máme na serveru hodně RAM a je 30–40 % volné, o swap se nestaráme.
Proces vytvoření záložní kopieTato úloha vypadá nějak takto:
#!/bin/bash

mkdir -p /mnt/backups/volumes

DIR=/mnt/images-snap
VOL=images/volume
DATE=$(date "+%d")
HOSTNAME=$(hostname)

lvcreate -s -n $VOL-snap -l100%FREE $VOL
ionice -c3 dd iflag=direct if=/dev/$VOL-snap bs=1M of=/mnt/backups/volumes/$HOSTNAME-$DATE.raw
lvremove -f $VOL-snap
Poznámka: ionice -c3, ve skutečnosti je tato věc pro NVMe zařízení zcela zbytečná, protože plánovač IO pro ně je nastaven jako:
cat /sys/block/nvme0n1/queue/scheduler
[none]
Máme však řadu starších uzlů s běžnými SSD RAIDy, pro ně je to relevantní, takže se to přesouvá. JAK JECelkově je to jen zajímavý kus kódu, který vysvětluje marnost ionice v případě takové konfigurace.
Věnujte pozornost vlajce iflag=direct pro DDPoužíváme přímý IO (výstup/výstup) bez vyrovnávací paměti bufferu, abychom se vyhnuli zbytečným nahrazováním IO bufferu při čtení. Nicméně oflag=direct Neděláme to, protože jsme při používání ZFS narazili na problémy s výkonem.
Tento systém úspěšně používáme již několik let bez jakýchkoli problémů.
A pak to začalo...Zjistili jsme, že zálohování u jednoho z uzlů bylo zastaveno a předchozí zálohování bylo dokončeno s monstrózním IOWAIT, téměř 50 %. Při snaze zjistit, proč k zálohování nedochází, jsme narazili na následující jev:
Volume group "images" not foundZačali jsme si myslet, že Intel P4500 je mrtvý, ale než jsme vypnuli server a vyměnili disk, museli jsme provést zálohu. LVM2 jsme opravili obnovením metadat ze zálohy LVM2:
vgcfgrestore imagesSpustili jsme zálohování a viděli jsme tento obrázek:
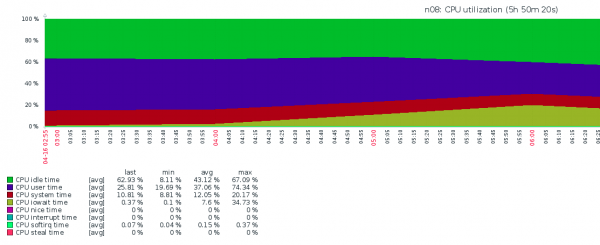
Zase jsme byli velmi smutní – bylo jasné, že takhle žít nemůžeme, protože všechny VPS by trpěly, a to znamenalo, že budeme trpět i my. Co se dělo, bylo naprosto nejasné – iostat Ukazovalo to žalostné IOPS a závratně vysoký IOWAIT. Neměl jsem žádné jiné nápady než „nahradíme NVMe“, ale pak mě něco napadlo.
Analýza situace krok za krokem
Historický časopisPřed několika dny bylo potřeba na tomto serveru vytvořit velký VPS se 128 GB RAM. Paměť se zdála dostatečná, ale z bezpečnostních důvodů bylo přiděleno dalších 32 GB pro swap. VPS byl vytvořen, úspěšně splnil svůj úkol a incident byl zapomenut, ale swapovací oddíl zůstal.
Funkce konfiguracePro všechny cloudové servery je parametr vm.swappiness byla nastavena na výchozí hodnotu 60A SWAP byl vytvořen na SAS HDD RAID1.
Co se stalo (podle redakce)Při zálohování DD produkoval velké množství dat k zápisu, která byla před zápisem do NFS umisťována do vyrovnávacích pamětí RAM. Systémové jádro, řízené politikou swappiness, přesunul mnoho paměťových stránek VPS do odkládacího prostoru, který se nacházel na pomalém svazku HDD RAID1. To způsobilo dramatický nárůst IOWAIT, nikoli kvůli NVMe IO, ale kvůli HDD RAID1 IO.
Jak byl problém vyřešen32GB odkládací oddíl byl deaktivován. Trvalo to 16 hodin. Můžete si přečíst, jak a proč se odkládací oddíl tak pomalu deaktivuje, a to samostatně. Parametry byly změněny. swappiness na hodnotu rovnou 5 v celém cloudu.
Jak se tohle mohlo nestat?Zaprvé, pokud by SWAP byl na SSD RAID nebo NVMe zařízení, a zadruhé, pokud by neexistovalo žádné NVMe zařízení, ale pomalejší zařízení, které by nebylo schopno zpracovat takový objem dat – ironicky problém vznikl, protože NVMe je příliš rychlé.
Poté všechno začalo fungovat jako předtím - s nulovým IOWAIT.
Zdroj: www.habr.com
