

Anmerkung des Übersetzers.: Der Autor dieses Artikels (Luc Perkins) ist Developer Advocate bei der CNCF, die das Zuhause für Open-Source-Projekte wie Linkerd, SMI (Service Mesh Interface) und Kuma ist (übrigens, haben Sie sich auch schon gefragt, warum Istio in dieser Liste fehlt?). Wiederholt versucht er, der DevOps-Community ein besseres Verständnis des modischen Hypes mit dem Namen „Service Mesh“ zu vermitteln, indem er 16 charakteristische Möglichkeiten aufzeigt, die solche Lösungen bieten.
Heute ist eines der heißesten Themen im Bereich der Softwaretechnik (und zu Recht!). Ich halte diese Technologie für unglaublich vielversprechend und träume davon, Zeuge ihrer breiten Verbreitung zu werden (natürlich, wenn es sinnvoll ist). Nichtsdestotrotz ist sie für die meisten Menschen noch von einem Hauch Geheimnis umgeben. Sogar diejenigen, die gut damit vertraut sind, haben oft Schwierigkeiten, ihre Vorteile und was sie tatsächlich darstellt, zu formulieren (inklusive des bescheidenen Autors). In diesem Artikel werde ich versuchen, die Situation zu korrigieren, indem ich verschiedene Anwendungsfälle von „Service Meshes“ aufliste.
* Anmerkung des Übersetzers: Hier und im Folgenden wird die Übersetzung „Service Mesh“ als „Service-Netz“ für den noch relativ neuen Begriff verwendet.
Aber zunächst möchte ich einige Bemerkungen machen:
- Ich habe nie mit Service Meshes gearbeitet und sie nicht außerhalb von Projekten verwendet, die ich für mein eigenes Lernen angestoßen habe. Auf der anderen Seite habe ich 2015 eine Menge Dokumentation für das interne Service Mesh von Twitter geschrieben (es hieß damals noch nicht einmal „Service Mesh“) und war an der Entwicklung der Website und der Dokumentation für , was doch etwas bedeutet.
- Meine Liste ist exemplarisch und unvollständig. Es sind durchaus mir unbekannte Anwendungsfälle möglich, und im Laufe der Zeit werden sicherlich neue Varianten auftreten, während sich die Technologie weiterentwickelt und ihre Beliebtheit wächst.
- Zur gleichen Zeit unterstützt nicht jede bestehende Implementierung eines Service Mesh alle aufgeführten Anwendungsfälle. Daher sollten meine Formulierungen wie „Service Mesh kann…“ als „Einzelne, möglicherweise auch alle gängigen Implementierungen von Service Mesh können…“ gelesen werden.
- Die Reihenfolge der Beispiele spielt dabei keine Rolle.
Kurze Liste:
- Serviceerkennung;
- Verschlüsselung;
- Authentifizierung und Autorisierung;
- Lastverteilung;
- Circuit Breaking;
- Automatische Skalierung;
- Canary Deployments;
- Blue-Green Deployments;
- Health Checks;
- Load Shedding;
- Traffic-Spiegelung;
- Isolation;
- Begrenzung der Anfragefrequenz, Wiederholungsversuche und Timeouts;
- Telemetrie;
- Audit;
- Visualisierung.
1. Dienstentdeckung
TL;DR: Verbinden Sie sich mit anderen Diensten im Netzwerk über einfache Namen.
Dienste sollten in der Lage sein, einander automatisch zu „finden“ durch angemessene Namen – zum Beispiel, service.api.production, pets/staging oder cassandra. Cloud-Umgebungen zeichnen sich durch ihre Elastizität aus, und hinter einem Namen können sich zahlreiche Instanzen eines Dienstes verbergen. Es ist klar, dass es in einer solchen Situation physisch unmöglich ist, alle IP-Adressen fest zu codieren.
Darüber hinaus, wenn ein Dienst einen anderen findet, sollte er in der Lage sein, Anfragen an diesen Dienst zu senden, ohne befürchten zu müssen, dass sie bei einer nicht funktionierenden Instanz landen. Mit anderen Worten, das Service Mesh sollte die Verfügbarkeit aller Dienstinstanzen überwachen und die Liste der Hosts so aktuell wie möglich halten.
Jedes Service Mesh implementiert den Dienstentdeckungsmechanismus auf seine Weise. Derzeit ist der verbreitetste Ansatz die Delegation an externe Prozesse wie DNS Kubernetes. Früher verwendeten wir bei Twitter für solche Zwecke ein Namenssystem . Außerdem ermöglicht die Technologie des Service Mesh das Auftreten benutzerdefinierter Namensmechanismen (obwohl ich noch keine Implementierung von SM mit dieser Funktionalität gesehen habe).
2. Verschlüsselung
TL;DR: Beseitigen Sie unverschlüsselten Verkehr zwischen den Diensten und lassen Sie diesen Prozess automatisiert und skalierbar sein.
Es ist beruhigend zu wissen, dass Angreifer nicht in Ihr internes Netzwerk eindringen können. Firewalls erledigen dies hervorragend. Aber was passiert, wenn ein Hacker trotzdem eindringt? Kann er mit dem internen Dienstverkehr machen, was er will? Lassen wir uns hoffen, dass dies nicht der Fall sein wird. Um ein solches Szenario zu verhindern, sollte ein Netzwerk mit Null-Vertrauen (Zero-Trust) implementiert werden, bei dem der gesamte Verkehr zwischen den Diensten verschlüsselt ist. Die meisten modernen Dienstnetzwerke erreichen dies durch gegenseitige (mutual TLS, mTLS). In einigen Fällen funktioniert mTLS in gesamten Clouds und Clustern (ich denke, interplanetare Kommunikation wird eines Tages ähnlich strukturiert sein).
Natürlich ist mTLS für das Service Mesh nicht zwingend erforderlich.. Jeder Dienst kann sich um sein eigenes TLS kümmern, aber das bedeutet, dass er einen Weg finden muss, um Zertifikate zu generieren, diese auf die Hosts des Dienstes zu verteilen und Code in die Anwendung einzufügen, der diese Zertifikate aus Dateien lädt. Vergessen Sie nicht, diese Zertifikate in bestimmten Zeitabständen zu aktualisieren. Dienstgitter automatisieren mTLS mit Systemen wie , die ihrerseits den Prozess der Ausstellung und Rotation von Zertifikaten automatisieren.
3. Authentifizierung und Autorisierung
TL;DR: Bestimmen Sie, wer der Anfragesteller ist, und legen Sie fest, was ihm erlaubt ist, noch bevor die Anfrage den Dienst erreicht.
Dienste möchten oft wissen, wer die Anfrage ausführt (Authentifizierung), und entscheiden dann anhand dieser Information, was was diesem Subjekt erlaubt ist (Autorisierung). In diesem Fall kann hinter dem Pronomen „wer“ Folgendes stecken:
- Andere Dienste. Dies wird als „Peer-Authentifizierung“ bezeichnet. Zum Beispiel möchte der DienstZugriff auf den Dienst
webdbdbEinige Benutzer. Dies wird als „Anfrage-Authentifizierung“ bezeichnet. - Zum Beispiel möchte der Benutzer haxor69eine neue Lampe kaufen. Dienstgitter bieten verschiedene Mechanismen, wie z. B.
JSON Web Tokens.Viele von uns haben das im Anwendungscode gemacht. Eine Anfrage kommt, wir durchsuchen die Tabelle .usw. Bei einem Dienstgitter geschieht dies noch bevor die Anfrage den Dienst erreicht.
usersNachdem wir festgestellt haben, von wem die Anfrage stammt, müssen wir bestimmen, was diesem Subjekt erlaubt ist. Einige Dienstgitter erlauben es, grundlegende Richtlinien (wer was tun darf) in Form von YAML-Dateien oder über die Befehlszeile festzulegen, während andere Integrationen mit Frameworks wieBerechtigungenunterstützen. Das Endziel ist es, dass Ihre Dienste jede Anfrage annehmen, in der Annahme, dass sie aus einer vertrauenswürdigen Quelle stammt.
Diese Handlung ist erlaubt. 4. Lastverteilung und TL;DR: Verteilen Sie die Last auf die Instanzen des Dienstes nach einem bestimmten Muster.
4. Lastverteilung
TL;DR: Verteilen Sie die Last auf die Instanzen des Dienstes nach einem bestimmten Muster.
Der „Service“ in einer Service-Sektion besteht sehr häufig aus vielen identischen Instanzen. Zum Beispiel besteht der Service heute aus 5 Kopien, morgen könnte ihre Zahl auf 11 steigen. Die Anfragen, die an cache , müssen entsprechend einem definierten Ziel verteilt werden. Zum Beispiel, um die Verzögerung zu minimieren oder die Wahrscheinlichkeit zu maximieren, eine funktionierende Instanz zu erreichen. Am häufigsten wird der Round-Robin-Algorithmus verwendet, es gibt jedoch auch viele andere – wie die Methode mit gewichtetem cache(weighted) Anfragen (man kann bevorzugte Ziele auswählen), ringförmiges (ring) Hashing (Verwendung von konsistentem Hashing für Upstream-Hosts) oder die Methode der geringsten Anzahl von Anfragen (Bevorzugung der Instanz mit der geringsten Anzahl von Anfragen). Klassische Lastverteiler haben auch andere Funktionen, wie HTTP-Caching und DDoS-Schutz, sind jedoch für den East-West-Traffic (d.h. für Traffic, der innerhalb des Rechenzentrums fließt – Anm. d. Ü.) nicht sehr relevant (typisches Anwendungsgebiet eines Service Mesh). Natürlich ist es nicht zwingend erforderlich, ein Service Mesh für die Lastverteilung zu verwenden, jedoch ermöglicht es, die Lastverteilungsrichtlinien für jeden Service aus einer zentralen Verwaltungsschicht festzulegen und zu kontrollieren, wodurch die Notwendigkeit entfällt, separate Lastverteiler im Netzwerkstack zu starten und zu konfigurieren.
5. Circuit Breaking
TL;DR: Stoppen Sie den Traffic zu dem problematischen Service und kontrollieren Sie den Schaden bei den schlechtesten Szenarien.
Wenn aus irgendeinem Grund der Service mit dem Traffic nicht zurechtkommt, bietet das Service Mesh mehrere Lösungsmöglichkeiten für dieses Problem (andere werden in den entsprechenden Abschnitten behandelt). Circuit Breaking ist die strengste Möglichkeit, den Service vom Traffic abzuschneiden. Allerdings macht es alleine keinen Sinn – ein Notfallplan ist notwendig. Es kann ein Backpressure
backpressure () Service-Meshes ermöglichen nicht nur zu definieren,
wann eine Deaktivierung erfolgen sollte und es wird eine Abschaltung folgen und was Das folgt dem. In diesem Fall kann „wann“ jede Kombination der festgelegten Parameter umfassen: die Gesamtzahl der Anfragen über einen bestimmten Zeitraum, die Anzahl der parallelen Verbindungen, ausstehende Anfragen, aktive Wiederholungsversuche usw.
Sie werden wahrscheinlich nicht den Circuit Breaking überbeanspruchen wollen, aber es ist angenehm zu wissen, dass es einen Notfallplan gibt.
6. Automatische Skalierung
TL;DR: Erhöhen oder verringern Sie die Anzahl der Dienstinstanzen basierend auf bestimmten Kriterien.
Service-Meshes sind keine Planer, daher führen sie kein Scaling eigenständig durch. Sie können jedoch Informationen bereitstellen, auf deren Grundlage Planer Entscheidungen treffen können. Da Service-Meshes Zugriff auf den gesamten Verkehr zwischen den Diensten haben, verfügen sie über umfassende Informationen darüber, was vor sich geht: welche Dienste Probleme haben, welche nur schwach ausgelastet sind (die ihnen zugewiesenen Ressourcen werden verschwendet) usw. Zum Beispiel skaliert Kubernetes die Dienste basierend auf der CPU- und Speicherauslastung der Pods.
(Siehe unseren Bericht „ , aber wenn Sie die Skalierung auf der Grundlage eines anderen Parameters durchführen möchten (in unserem Fall – verkehrsbezogen), wird eine spezielle Metrik benötigt. Eine Anleitung“ — Anm. d. Ü.)wie diese macht, aber der Prozess ist ziemlich komplex. Wir würden uns wünschen, dass das Service Mesh es vereinfacht, indem es einfach erlaubt, Bedingungen wie „Erhöhe die Anzahl der Dienstinstanzen , und auth auth7. Canary-Deployments
TL;DR: Testen Sie neue Funktionen oder Versionen des Dienstes an einer Teilmenge der Benutzer.
TL;DR: Testen Sie neue Funktionen oder Versionen des Dienstes an einer Teilgruppe von Nutzern.
Angenommen, Sie entwickeln ein gewisses SaaS-Produkt und planen, eine neue coole Version herauszubringen. Sie haben sie in der Staging-Umgebung getestet, und sie hat hervorragend funktioniert. Dennoch gibt es bestimmte Bedenken bezüglich ihres Verhaltens unter realen Bedingungen. Mit anderen Worten, die neue Version muss an realen Aufgaben getestet werden, ohne das Vertrauen der Nutzer zu gefährden. Canary-Deployments eignen sich hervorragend dafür. Sie ermöglichen es, eine neue Funktion einer bestimmten Untergruppe von Nutzern zu präsentieren. Diese Untergruppe kann aus den loyalsten Nutzern, denjenigen, die die kostenlose Version des Produkts nutzen, oder aus Nutzern bestehen, die bereit sind, „Versuchskaninchen“ zu sein.
Service-Meshes setzen dies um, indem sie Kriterien angeben, die bestimmen, wer welche Version der Anwendung sieht, und den Datenverkehr entsprechend leiten. Für die Dienste selbst ändert sich dabei nichts. Version 1.0 des Dienstes geht davon aus, dass alle Anfragen von Nutzern kommen, die diese auch sehen sollen, während Version 1.1 das Gleiche für ihre Nutzer annimmt. In der Zwischenzeit können Sie den Prozentsatz des Datenverkehrs zwischen der alten und der neuen Version ändern und eine wachsende Zahl von Nutzern zur neuen Version leiten, sofern sie stabil funktioniert und Ihre „Versuchskaninchen“ zustimmen.
8. Blau-Grüne Deployments
TL;DR: Bringen Sie eine neue coole Funktion heraus, sind Sie jedoch bereit, alles sofort zurückzunehmen.
Bedeutung besteht darin, den neuen „blauen“ Dienst parallel zum alten „grünen“ Dienst zu veröffentlichen. Wenn alles gut läuft und der neue Dienst sich bewährt, kann der alte Dienst schrittweise abgeschaltet werden. (Leider wird auch dieser neue „blaue“ Dienst eines Tages das Schicksal des „grünen“ teilen und verschwinden…) Blau-Grüne Deployments unterscheiden sich von Canary-Deployments dadurch, dass die neue Funktion allen Nutzern zur Verfügung steht (und nicht nur einem Teil); der Sinn besteht darin, einen „Fallback“ bereit zu haben, falls etwas schiefgeht.
Service-Mesh bieten eine sehr bequeme Möglichkeit, den „blauen“ Dienst zu testen und im Falle von Problemen sofort auf den funktionierenden „grünen“ zu wechseln. Ganz zu schweigen davon, dass sie nebenbei eine Menge Informationen bereitstellen (siehe Punkt „Telemetrie“ unten) über die Funktionsweise des „blauen“, was hilft zu verstehen, ob dieser bereit ist, umfassend genutzt zu werden.
Anmerkung des Übersetzers.: Weitere Informationen zu verschiedenen Bereitstellungsstrategien in Kubernetes (einschließlich der erwähnten Canary-, Blue/Green- und anderen Strategien) sind verfügbar in .
9. Gesundheitsprüfung
TL;DR: Achten Sie darauf, welche Instanzen von Diensten betriebsbereit sind, und reagieren Sie auf die, die es nicht mehr sind.
Gesundheitsprüfung (health check) hilft zu entscheiden, ob die Instanzen des Dienstes bereit sind, Verkehr zu empfangen und zu verarbeiten. Bei HTTP-Diensten könnte die Gesundheitsprüfung beispielsweise wie ein GET-Anruf an den Endpoint aussehen /health. Eine Antwort 200 OK würde bedeuten, dass die Instanz gesund ist, jede andere Antwort, dass sie nicht bereit ist, Verkehr zu akzeptieren. Service-Mesh erlauben es, sowohl die Methode, wie die Betriebsfähigkeit geprüft wird, als auch die Häufigkeit, mit der diese Prüfung stattfindet, anzugeben. Diese Informationen können dann für andere Zwecke verwendet werden – zum Beispiel zur Lastverteilung und Circuit Breaking.
Auf diese Weise ist die Gesundheitsprüfung kein eigenständiges Nutzungsszenario, sondern wird normalerweise zur Erreichung anderer Ziele eingesetzt. Abhängig von den Ergebnissen der Gesundheitsprüfungen können zudem externe Maßnahmen erforderlich sein (im Verhältnis zu anderen Zielen der Service-Meshs): Zum Beispiel könnte es nötig sein, den Statusbereich zu aktualisieren, ein Issue bei GitHub zu erstellen oder ein Ticket in JIRA auszufüllen. Und Service-Mesh bieten einen praktischen Mechanismus, um all dies zu automatisieren.
10. Lastabwurf (load shedding)
TL;DR: Leiten Sie den Verkehr als Antwort auf einen vorübergehenden Anstieg der Nutzung um.
Wenn ein Dienst mit Verkehr überlastet ist, können Sie vorübergehend einen Teil dieses Verkehrs woanders hinleiten (d.h. „abwerfen“, „umleiten“ (shed) ihn dorthin). Beispielsweise zu einem Backup-Dienst oder einem Rechenzentrum oder zu einem permanenten Thema. Infolgedessen wird der Dienst weiterhin einen Teil der Anfragen verarbeiten, anstatt zuversagen und die gesamte Verarbeitung einzustellen. Eine Lastablösung ist vorzuziehen, als den gesamten Kreis zu unterbrechen, aber es ist dennoch unerwünscht, dies übermäßig auszunutzen. Sie ermöglicht es, kaskadierende Ausfälle zu verhindern, bei denen nachgelagerte Dienste ausfallen.
11. Parallelisierung / Traffic-Mirroring
TL;DR: Senden Sie eine Anfrage gleichzeitig an mehrere Stellen.
Manchmal besteht die Notwendigkeit, eine Anfrage (oder eine bestimmte Auswahl von Anfragen) gleichzeitig an mehrere Dienste zu senden. Ein typisches Beispiel ist das Senden eines Teils des Produktionsverkehrs zu einem Staging-Dienst. Der zentrale Webserver der Produktion sendet eine Anfrage an den nachgelagerten Dienst products.production und nur zu diesem. Der Service-Mesh kopiert diese Anfrage intelligent und sendet sie an products.staging, dessen Webserver sich dessen nicht einmal bewusst ist.
Ein weiteres verwandtes Nutzungsszenario eines Service-Mesh, das über die Parallelisierung des Verkehrs implementiert werden kann, ist das . Dies sieht vor, dass dieselben Anfragen an verschiedene Versionen eines Dienstes gesendet werden, um zu überprüfen, ob sich alle Versionen gleich verhalten. Mir ist bisher keine Implementierung eines Service-Mesh mit einem integrierten Regressionstestssystem wie , begegnet, aber die Idee scheint vielversprechend.
12. Isolierung
TL;DR: Unterteilen Sie Ihr Service-Mesh in Mininetze.
Auch bekannt als Segmentierung, ist Isolierung die Kunst, ein Service-Mesh in logisch abgegrenzte Segmente zu unterteilen, die nichts voneinander wissen. Isolierung ähnelt ein wenig der Einrichtung von virtuellen privaten Netzwerken. Der grundlegende Unterschied besteht jedoch darin, dass Sie weiterhin alle Vorteile eines Service-Mesh (wie die Dienstentdeckung) nutzen können, jedoch mit zusätzlicher Sicherheit. Wenn es einem Angreifer gelingt, in einen Dienst innerhalb eines der Subnetze einzudringen, kann er nicht sehen, welche Dienste in anderen Subnetzen laufen oder deren Traffic abfangen.
Darüber hinaus können die Vorteile auch organisatorischer Natur sein. Möglicherweise möchten Sie Dienste in Subnetze unterteilen, abhängig von der Unternehmensstruktur, und Entwickler von der kognitiven Belastung befreien, die durch die Notwendigkeit entsteht, sich an das gesamte Service-Mesh zu erinnern.
13. Anfragerate begrenzen, Wiederholungen und Zeitüberschreitungen
TL;DR: Es müssen keine dringenden Aufgaben zum Management von Anfragen mehr in den Code-Basis aufgenommen werden.
All diese Dinge könnten als separate Anwendungsfälle betrachtet werden, aber ich habe mich entschieden, sie aufgrund einer gemeinsamen Eigenschaft zusammenzufassen: Sie übernehmen das Management des Lebenszyklus von Anfragen, normalerweise von Anwendungslibraries bearbeitet. Wenn Sie einen Webserver in Ruby on Rails (nicht integriert mit Service Mesh) entwickeln, der Anfragen an Backend-Dienste überstellt, , muss die Anwendung selbst entscheiden, was zu tun ist, wenn N Anfragen fehlschlagen. Außerdem muss ermittelt werden, wie viel Traffic diese Dienste bewältigen können, und diese Parameter müssen mit einer speziellen Bibliothek 'hardcodiert' werden. Darüber hinaus muss die Anwendung entscheiden, wann es Zeit ist aufzugeben und die Anfrage verfallen zu lassen (nach Timeout). Um einen der oben genannten Parameter zu ändern, muss der Webserver angehalten, neu konfiguriert und neu gestartet werden.
Die Übertragung dieser Aufgaben an das Service Mesh bedeutet nicht nur, dass die Entwickler der Dienste nicht mehr darüber nachdenken müssen, sondern auch, dass sie aus einer übergeordneten Perspektive betrachtet werden können. Wenn eine komplexe Kette von Diensten verwendet wird, sagen wir A -> B -> C -> D -> E, muss der gesamte Lebenszyklus der Anfrage berücksichtigt werden. Wenn es darum geht, die Timeouts im Dienst C zu verlängern, ist es sinnvoll, dies alles auf einmal zu tun und nicht in Teilen: den Code des Dienstes zu aktualisieren und darauf zu warten, dass der Pull-Request akzeptiert wird und das CI-System den aktualisierten Dienst bereitstellt.
14. Telemetrie
TL;DR: Sammeln Sie alle notwendigen (und nicht ganz notwendigen) Informationen von den Dienstleistungen.
Telemetrie ist ein allgemeiner Begriff, der Metriken, verteilte Tracing und Protokolle umfasst. Service Meshes bieten Mechanismen zum Sammeln und Verarbeiten aller drei Datentypen. Hier wird es etwas vage, da die Anzahl der möglichen Entscheidungen zu groß ist. Für das Sammeln von Metriken gibt es und andere Werkzeuge, zum Sammeln von Protokollen kann man verwenden , , usw. (zum Beispiel ClickHouse mit unserem für K8s — Anm. d. Übers., für verteiltes Tracing gibt es usw. Jedes Service Mesh kann einige Instrumente unterstützen und andere nicht. Es wird interessant sein zu sehen, ob das Projekt eine gewisse Konvergenz erreichen kann.
In diesem Fall liegt der Vorteil der Service-Mesh-Technologie darin, dass Sidecar-Container grundsätzlich alle oben genannten Daten von ihren Diensten sammeln können. Anders gesagt, Sie erhalten ein einheitliches System zur Erfassung von Telemetriedaten, und das Service Mesh kann all diese Informationen auf verschiedene Arten verarbeiten. Zum Beispiel:
- Die Logs eines bestimmten Dienstes im CLI verfolgen;
- den Datenverkehr über das Dashboard des Service Mesh überwachen;
- verteilte Traces sammeln und diese an ein System wie Jaeger weiterleiten.
Achtung, subjektive Meinung: Im Allgemeinen ist Telemetrie der Bereich, in den das Eingreifen eines Service Mesh unerwünscht ist. Das Sammeln grundlegender Informationen und die Echtzeitüberwachung bestimmter „Goldmetriken“ wie die Erfolgsquote von Anfragen und Latenzen sind in Ordnung, aber lassen Sie uns hoffen, dass wir nicht Zeugen der Entstehung solcher Frankenstein-Stacks werden, die versuchen, spezialisierte Systeme zu ersetzen, von denen einige sich bereits hervorragend bewährt haben und gut untersucht sind.
15. Audit
TL;DR: Wer die Lehren der Geschichte vergisst, ist dazu verurteilt, sie zu wiederholen.
Audit ist die Kunst, wichtige Ereignisse im System zu beobachten. Im Falle des Service Mesh kann dies bedeuten, zu verfolgen, wer Anfragen an bestimmte Endpoints bestimmter Dienste gestellt hat oder wie oft in den letzten Monat ein Ereignis im Zusammenhang mit der Sicherheit aufgetreten ist.
Es ist klar, dass das Audit sehr eng mit der Telemetrie verbunden ist. Der Unterschied besteht jedoch darin, dass Telemetrie üblicherweise mit Dingen wie Leistung und technischer Feinheit assoziiert wird, während das Audit sich auf rechtliche und andere Fragen beziehen kann, die über die rein technische Sphäre hinausgehen (zum Beispiel die Einhaltung der GDPR – der allgemeinen Datenschutzverordnung der EU).
16. Visualisierung
TL;DR: Es lebe React.js – eine unerschöpfliche Quelle skurriler Schnittstellen.
Vielleicht gibt es einen passenderen Begriff, aber ich kenne ihn nicht. Ich meine einfach die grafische Darstellung des Service Mesh oder einiger seiner Komponenten. Diese Visualisierungen können Indikatoren wie durchschnittliche Latenzen, Informationen zur Konfiguration der Sidecar-Container, Ergebnisse von Gesundheitschecks und Benachrichtigungen enthalten.
Die Arbeit in einer serviceorientierten Umgebung ist mit einer deutlich höheren kognitiven Belastung verbunden im Vergleich zu Seiner Majestät dem Monolithen. Daher sollte der kognitive Druck um jeden Preis verringert werden. Eine banale grafische Benutzeroberfläche für das Service-Mesh, mit der Möglichkeit, auf einen Knopf zu klicken und das gewünschte Ergebnis zu erhalten, kann entscheidend für das Wachstum der Popularität dieser Technologie sein.
Wurden nicht in die Liste aufgenommen
Ursprünglich hatte ich vor, noch einige weitere Anwendungsfälle in die Liste aufzunehmen, aber ich habe mich dann entschieden, dies nicht zu tun. Hier sind sie zusammen mit den Gründen für meine Entscheidung:
- Multi-Data-Center. Meiner Ansicht nach handelt es sich hierbei nicht so sehr um einen Anwendungsfall, sondern um einen engen und spezifischen Anwendungsbereich von Service-Meshes oder einer bestimmten Funktionalität wie der Dienstentdeckung.
- Ingress und Egress. Dies ist ein verwandter Bereich, aber ich habe mich (vielleicht künstlich) auf den Anwendungsfall „Traffic East-West“ beschränkt. Ingress und Egress verdienen einen eigenen Artikel.
Fazit
Das ist vorerst alles! Noch einmal, diese Liste ist sehr subjektiv und wahrscheinlich unvollständig. Wenn Sie der Meinung sind, dass ich etwas übersehen habe oder einen Fehler gemacht habe, wenden Sie sich bitte über Twitter an mich (). Bitte beachten Sie die guten Manieren.
P.S. vom Übersetzer
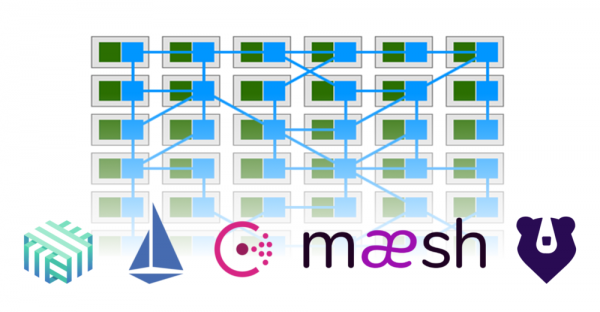
Als Grundlage für die Titelillustration des Artikels wurde ein Bild aus dem Artikel „“ (Autor — Gregory MacKinnon) verwendet. Es zeigt, wie ein Teil der Funktionalität aus Anwendungen (grün) in das Service-Mesh übergegangen ist, das die Beziehungen zwischen ihnen (blau) gewährleistet.
Lesen Sie auch in unserem Blog:
- «»;
- «»;
- «».
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish