

Në fillim, kur filloni punën me një grup të ri të dhënash, është e nevojshme ta kuptoni atë. Për ta bërë këtë, duhet, për shembull, të zbulojmë intervalet e vlerave që merrnin variablat, llojet e tyre, si dhe të mësojmë për numrin e vlerave të humbura.
Biblioteka pandas ofron shumë mjete të dobishme për të kryer analizën eksploruese të të dhënave (Exploratory Data Analysis, EDA). Por, para se të përdorim ato, zakonisht duhet të fillojmë me funksione më të përgjithshme, si df.describe(). Megjithatë, duhet të theksojmë se mundësitë e ofruara nga këto funksione janë të kufizuara, dhe fazat fillestare të punës me çdo grup të dhënash gjatë kryerjes së EDA shpesh janë shumë të ngjashme me njëra-tjetrën.
Autori i materialit që po publikojmë sot thotë se ai nuk është një adhurues i kryerjes së veprimeve të përsëritura. Si rezultat, në kërkim të mjeteve që lejojnë kryerjen e analizës eksploruese të të dhënave shpejt dhe efektivisht, ai zbuloi bibliotekën . Rezultatet e punës së saj shprehen jo në formën e disa treguesve të veçantë, por në formën e një raporti HTML mjaft të detajuar, që përmban shumicën e informacioneve rreth të dhënave që po analizohet, të cilat mund të jenë të nevojshme për t'u znjohur para se të filloni punën më të ngjeshur me to.
Këtu do të shqyrtohen karakteristikat e përdorimit të bibliotekës pandas-profiling në shembullin e grupit të dhënash Titanic.
Analiza eksploruese e të dhënave me ndihmën e pandas
Vendosa të eksperimentoj me pandas-profiling në grupin e dhënash Titanic për shkak se aty janë të dhëna të llojeve të ndryshme dhe për shkak të të dhënave që mungojnë. Mendoj se biblioteka pandas-profiling është veçanërisht interesante në ato raste kur të dhënat ende nuk janë pastruar dhe kërkojnë përpunim më të thellë, në varësi të karakteristikave të tyre. Për të kryer një përpunim të tillë me sukses, duhet të dini se nga duhet të filloni dhe çfarë duhet të vëreni. Këtu do të na ndihmojnë mundësitë e pandas-profiling.
Për të filluar, le të importojmë të dhënat dhe të përdorim pandas për të marrë treguesit e statistikave përshkruese:
# импорт необходимых пакетов
import pandas as pd
import pandas_profiling
import numpy as np

# импорт данных
df = pd.read_csv('/Users/lukas/Downloads/titanic/train.csv')

# вычисление показателей описательной статистики
df.describe()
Pas kryerjes së këtij fragmenti të kodit, do të kemi atë që tregohet në figurën e mëposhtme.
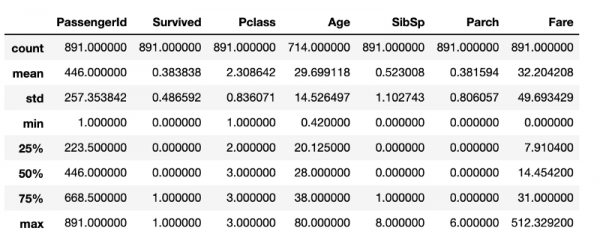
Treguesit e statistikave përshkruese të marra me ndihmën e mjeteve standarde pandas
Megjithëse ka shumë informacion të dobishëm këtu, nuk ka gjithçka që mund të jetë interesante për të zbuluar mbi të dhënat e shqyrtuara. Për shembull, mund të supozosh se në kornizën e të dhënave, në strukturën Mundësia e qasjes në të dhëna në formatin çelës-vlerë ose grupe kolonesh (, ka 891 rreshta. Nëse kjo duhet të verifikohet, do të nevojitet një rresht tjetër kodi që përcakton madhësinë e kornizës. Megjithëse këto llogaritje nuk janë veçanërisht të rëndësishme për burimet, përsëritja e vazhdueshme e tyre do të çojë patjetër në humbje kohe, e cila, ndoshta, do të ishte më mirë të shpenzohej për pastrimin e të dhënave.
Analiza eksploruese e të dhënave duke përdorur pandas-profiling
Tani do të bëjmë të njëjtën gjë duke përdorur pandas-profiling:
pandas_profiling.ProfileReport(df)Kryerja e rreshtit të kodit të paraqitur më lart do të lejojë formimin e një raporti me metrikat e analizës eksploruese të të dhënave. Kodi i paraqitur më lart do të prodhojë informacionin e gjetur për të dhënat, por mund të bëhet që rezultati të jetë një skedar HTML që, për shembull, mund t'ia tregosh dikujt.
Pjesa e parë e raportit do të përmbajë seksionin Overview (Përmbledhje), që jep informacione themelore mbi të dhënat (numri i vëzhgimeve, numri i variablave, etj.). Për më tepër, ai do të përmbajë një listë paralajmërimesh, duke e informuar analistin se në çfarë duhet të i kushtojë vëmendje të veçantë. Këto paralajmërime mund të shërbejnë si një udhëzues se mbi çfarë mund të përqendrohet për pastrimin e të dhënave.
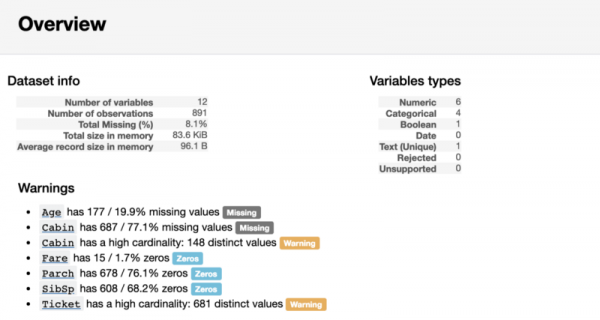
Seksioni i raportit Overview
Analiza eksploruese e variablave
Pas seksionit Overview në raport mund të zbuloni informacione të dobishme për secilin variabel. Ato përfshijnë, midis të tjerash, diagrame të vogla që përshkruajnë shpërndarjen e secilit variabel.
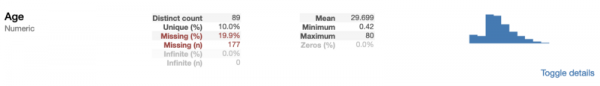
Informacion rreth variablit numerik Age
Siç mund të shihet nga shembulli i mëparshëm, pandas-profiling na jep disa indikacione të dobishme, siç janë përqindja dhe numri i vlerave të humbura, si dhe indikatorët e statistikave përshkruese që kemi parë tashmë. Duke qenë se Age është një variabel numerik, vizualizimi i shpërndarjes së tij në formën e histogramit na lejon të nxjerrim përfundimin se kemi të bëjmë me një shpërndarje të djathtë.
Kur shqyrtojmë një variabel kategorik, treguesit e nxjerrë duken paksa të ndryshëm nga ata që janë gjetur për variablit numerik.
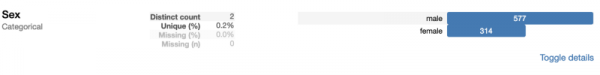
Informacion rreth variablit kategorik Sex
Konkretisht, në vend që të gjejë mesataren, minimumin dhe maksimumin, biblioteka pandas-profiling zbuloi numrin e klasave. Prandaj, Seksi — një variabël binar, vlerat e saj përfaqësohen nga dy klasa.
Nëse ju, ashtu si unë, e doni të eksploroni kodin, mund t'ju interesojë se si në të vërtetë biblioteka pandas-profiling llogarit këto tregues. Ta mësoni këtë, duke pasur parasysh se kodi i bibliotekës është i hapur dhe i aksesueshëm në GitHub, nuk është aq e vështirë. Duke mos qënë një adhurues i madh i përdorimit të ‘kutive të zeza’ në projektet e mia, shikova kodin burimor të bibliotekës. Për shembull, ja si duket mekanizmi i trajtimit të variablave numerikë, i përfaqësuar nga funksioni :
def describe_numeric_1d(series, **kwargs):
    """Llogarit statistikë përmbledhëse të një variabli numerik (`TYPE_NUM`) (një Serisë).
    Gjithashtu krijon histogramet (mini dhe të plota) të shpërndarjes së saj.
    Parametrat
    ----------
    series : Serisë
        Variabli për të cilin do të japim përshkrimin.
    Kthen
    -------
    Serisë
        Përshkrimi i variablit si një Serisë me indekse që janë çelësi i statistikave.
    """
    # Formati një numër si përqindje. Për shembull 0.25 do të kthehet në 25%.
    _percentile_format = "{:.0%}"
    stats = dict()
    stats['type'] = base.TYPE_NUM
    stats['mean'] = series.mean()
    stats['std'] = series.std()
    stats['variance'] = series.var()
    stats['min'] = series.min()
    stats['max'] = series.max()
    stats['range'] = stats['max'] - stats['min']
    # Për të shmangur llogaritjen e tij disa herë
    _series_no_na = series.dropna()
    for percentile in np.array([0.05, 0.25, 0.5, 0.75, 0.95]):
        # Dropna() është një workaround për https://github.com/pydata/pandas/issues/13098
        stats[_percentile_format.format(percentile)] = _series_no_na.quantile(percentile)
    stats['iqr'] = stats['75%'] - stats['25%']
    stats['kurtosis'] = series.kurt()
    stats['skewness'] = series.skew()
    stats['sum'] = series.sum()
    stats['mad'] = series.mad()
    stats['cv'] = stats['std'] / stats['mean'] if stats['mean'] else np.NaN
    stats['n_zeros'] = (len(series) - np.count_nonzero(series))
    stats['p_zeros'] = stats['n_zeros'] * 1.0 / len(series)
    # Histogramet
    stats['histogram'] = histogram(series, **kwargs)
    stats['mini_histogram'] = mini_histogram(series, **kwargs)
    return pd.Series(stats, name=series.name)
Megjithëse ky fragment kodi mund të duket mjaft i madh dhe i komplikuar, në të vërtetë, e kupton lehtësisht. Bëhet fjalë për faktin se në kodin burimor të bibliotekës ka një funksion që përcakton llojet e variablave. Nëse ndodh të zbulojë një variabl numerik, funksioni i mësipërm do të gjejë treguesit që kemi shqyrtuar. Ky funksion përdor operacionet standarde të pandas për të punuar me objekte të tipit Serisë, siç është series.mean(). Rezultatet e llogaritjeve ruhet në një fjalor stats. Histogramet krijohen duke përdorur një version të adaptuar të funksionit matplotlib.pyplot.hist. Adaptimi synon që funksioni të funksionojë me lloje të ndryshme të grupeve të të dhënave.
Të dhënat e korrelacionit dhe mostra e të dhënave të hulumtuara
Pas rezultateve të analizës së variablave nga pandas-profiling, në seksionin Korrelacionet, do të shfaqen matricat e korrelacionit të Pearsonit dhe Spearmanit.
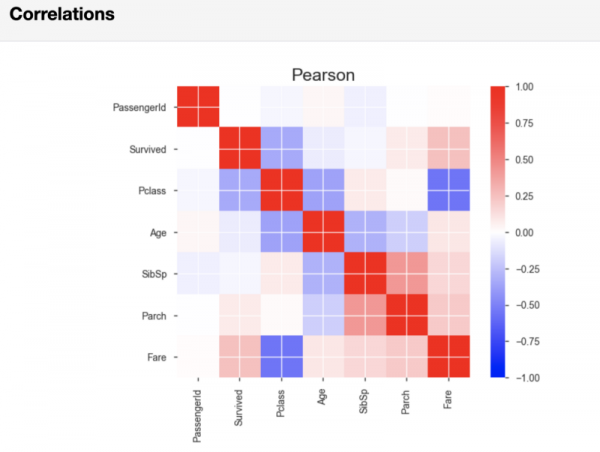
Matrica e korrelacionit të Pearsonit
Nëse është e nevojshme, mund të caktoni vlerat e pragut në atë rresht kodi që nis formimin e raportit. Kështu, mund të përcaktoni se cila forcë korrelacioni konsiderohet e rëndësishme për analizën tuaj.
Dhe për fund, në raportin pandas-profiling, në seksionin Mostra, shfaqet si një shembull një fragment i të dhënave të marra nga fillimi i grupit të të dhënave. Ky qasje mund të çojë në surpriza të pakëndshme, pasi vëzhgimet e para mund të jenë një mostër që nuk pasqyron karakteristikat e gjithë grupit të të dhënave.
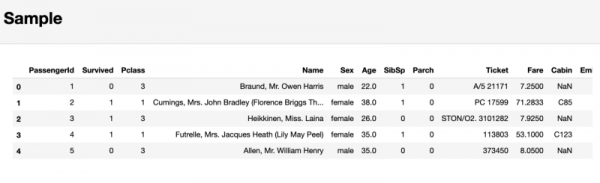
Seksioni që përmban mostrat e të dhënave të hulumtuara
Si rezultat, nuk rekomandoj t'i kushtoni vëmendje këtij seksioni të fundit. Në vend të kësaj, është më mirë të përdorni komandën df.sample(5), e cila do të zgjedhë rastësisht 5 vëzhgime nga grupi i të dhënave.
Përfundime
Duke përmbledhur atë që u tha më sipër, mund të theksoj se biblioteka pandas-profiling i ofron analistëve disa mundësi të dobishme, të cilat do t'i vijnë për shtat në rastet kur duhet të merrni shpejt një pasqyrë të përgjithshme të të dhënave ose t'i dërgoni dikujt një raport të analizës eksploruese të të dhënave. Të dhënat reale, duke marrë parasysh karakteristikat e tyre, analizohet, si gjithmonë, manualisht, pavarësisht nga përdorimi i pandas-profiling.
Nëse dëshironi të shihni si duket e gjithë analiza eksploruese e të dhënave në një bllok Jupyter — shikoni projektin tim, të krijuar me ndihmën e nbviewer. Dhe në repozitoret GitHub mund të gjeni kodin përkatës.
Të nderuar lexues! Nga çfarë e filloni analizën e grupeve të reja të të dhënave?
Burimi: habr.com
